
hex dump 읽는 법: 3단 구조 한눈에
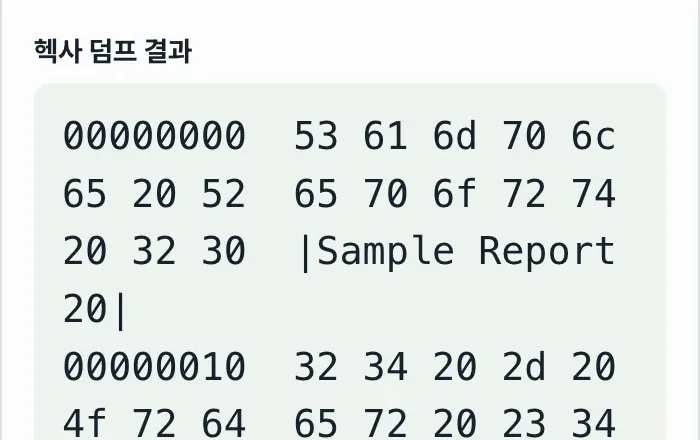
hex dump 화면에 나온 줄줄이 이어진 16진수 숫자와 오른쪽의 점(.) 문자열은, 사실 정해진 3개 컬럼(오프셋·16진수·ASCII)만 이해하면 그대로 읽을 수 있습니다.
터미널에서 xxd나 hexdump -C를 실행했을 때, 혹은 다른 프로그램이 원본 바이트를 이 형식으로 출력했을 때도 원리는 동일합니다. 이 글은 그 구조가 어떻게 만들어지는지부터 각 컬럼을 읽는 법까지 순서대로 설명합니다.
요약 ① 왼쪽 오프셋은 그 줄이 시작하는 바이트 위치이며, 16진수·10진수 전환은 같은 위치를 다른 숫자로 보여줄 뿐입니다. ② 가운데 영역은 바이트 값을 2자리 16진수(00~FF)로 적은 것이고, 한 줄에 8개 또는 16개씩 나열됩니다. ③ 오른쪽 |...| 영역의 점(.)은 화면에 문자로 표시할 수 없는 바이트를 안전하게 대체한 기호입니다.
hex dump를 마주치게 되는 상황
텍스트 편집기에서 어떤 파일을 열었는데 문자가 깨져 보이면, 원인이 파일의 인코딩 방식인지 확인하려고 hex 뷰어로 첫 몇 바이트를 들여다보는 경우가 있습니다.
확장자만으로는 실제 내용을 알 수 없는 파일을, 앞부분 바이트 값을 눈으로 직접 확인해 판단해야 할 때도 있습니다.
이럴 때 마주하는 hex dump 화면은 대부분 설명 없이 숫자만 쏟아냅니다. 왼쪽에 8자리 숫자, 가운데 두 줄로 나뉜 16진수 값, 오른쪽에 점투성이 문자열이 나란히 붙어 있을 뿐입니다.
문제는 이 표기 방식이 프로그래밍이나 네트워크 분석, 파일 포맷 확인 등에서 반복적으로 쓰인다는 점입니다. 한 번 구조를 알아두면 어떤 프로그램이 만든 hex dump든 같은 원리로 읽을 수 있지만, 모르면 매번 같은 화면 앞에서 막히게 됩니다.
도구 없이 직접 hex dump 만들고 읽는 법
hex dump는 특별한 프로그램이 있어야만 볼 수 있는 것이 아닙니다.
macOS·Linux 터미널에는 xxd 파일명 또는 hexdump -C 파일명 명령어가 기본으로 들어 있고, Windows PowerShell에는 Format-Hex 파일명 명령어가 있습니다. 이 명령어들이 만드는 화면의 구조는 근본적으로 같습니다.
구조가 만들어지는 순서는 다음과 같습니다.
- 원본 데이터를 바이트 단위로 나눕니다. 텍스트라면 UTF-8 인코딩 규칙에 따라 각 문자를 1~4바이트로 바꾸고, 파일이라면 저장된 그대로의 바이트를 사용합니다.
- 한 줄에 표시할 바이트 수를 정합니다. 보통 8개 또는 16개입니다.
- 각 줄의 시작 위치(오프셋)를 계산합니다. 오프셋은 "줄 번호 × 한 줄당 바이트 수"입니다.
- 각 바이트 값을 2자리 16진수(00~FF)로 적어 가로로 나열합니다.
- 같은 바이트 값이 32~126 범위(인쇄 가능한 ASCII)면 해당 문자를, 그렇지 않으면 점(.)을 오른쪽에 나란히 적습니다.
예시로 보는 오프셋과 바이트 값
예를 들어 알파벳 20개로 이루어진 문자열 ABCDEFGHIJKLMNOPQRST를 한 줄에 16바이트씩 hex dump 하면 이렇게 됩니다.
00000000  41 42 43 44 45 46 47 48  49 4A 4B 4C 4D 4E 4F 50  |ABCDEFGHIJKLMNOP|
00000010  51 52 53 54                                       |QRST|
첫 줄은 0번째 바이트(A)부터 15번째 바이트(P)까지 16개를 담고, 둘째 줄은 16번째 바이트(Q)부터 시작합니다.
이 16이라는 위치를 16진수로 적으면 00000010이고, 10진수로 적으면 00000016입니다. 가리키는 위치는 완전히 같지만, 어떤 진법으로 표기하느냐에 따라 숫자 모양만 달라진 것입니다.
점(.)이 나타나는 경우
제어문자나 여러 바이트로 인코딩되는 문자가 섞이면 오른쪽 영역에 점이 등장합니다. 예를 들어 텍스트 안에 줄바꿈(0x0A)이 들어 있으면 화면 문자로 그대로 옮길 수 없어 점으로 대체됩니다.
한글 한 글자는 UTF-8에서 보통 3바이트로 인코딩되는데, 이 3개 바이트 값은 모두 127을 넘어 ASCII 인쇄 가능 범위(32~126) 밖입니다.
그래서 가운데 hex 영역에는 바이트 값이 정확히 나타나지만, 오른쪽 ASCII 영역에는 글자 대신 점 3개가 나란히 나타납니다.
이 과정을 손으로 계산하지 않고, 직접 넣은 텍스트나 파일이 실제로 어떤 hex dump로 변환되는지 바로 보고 싶다면 저희 도구로 확인하기.
텍스트나 파일을 넣으면 설치나 회원가입 없이 바로 hex dump 결과를 확인할 수 있습니다.

자주 헷갈리는 부분
| 헷갈리는 지점 | 실제 의미 |
|---|---|
| 오프셋이 16진수·10진수 전환에 따라 달라 보임 | 같은 위치를 다른 진법 숫자로 표기한 것뿐, 가리키는 데이터는 동일 |
| ASCII 영역에 점(.)이 많음 | 0x00~0x1F 제어문자·127 이상 비인쇄 바이트를 읽기 쉽게 대체한 표시일 뿐, 데이터 손상 아님 |
| 입력한 글자 수보다 바이트 수가 더 많음 | 한글 등은 UTF-8에서 문자 하나가 여러 바이트로 인코딩되기 때문 |
| 한 줄당 바이트 수(8/16)를 바꾸면 줄 수가 달라짐 | 한 줄에 담는 바이트 개수만 바뀔 뿐 전체 데이터는 동일 |
| 큰 파일인데 일부만 보임 | 페이지 크기(256B~4KB) 단위로 나눠 보여주는 페이징일 뿐, 나머지 구간도 존재 |
마지막 항목인 페이징은 특히 오해하기 쉽습니다. 브라우저에서 큰 파일 전체를 한 번에 그리면 느려지기 때문에, 도구는 선택한 페이지 크기만큼만 그리고 나머지는 다음 페이지로 넘겨 보여줍니다.
화면에 보이는 것이 전체 데이터가 아니라 지금 보고 있는 한 구간이라는 뜻입니다.
정리
- hex dump는 텍스트(UTF-8 인코딩)나 파일(원본 바이트)을 바이트 배열로 바꾼 뒤, 한 줄에 8개 또는 16개씩 나눠 보여주는 표기 방식입니다.
- 왼쪽 오프셋은 그 줄이 시작하는 바이트 위치이며, 16진수와 10진수 표기는 같은 위치를 다른 숫자로 보여줄 뿐입니다.
- 가운데 영역은 바이트 값을 2자리 16진수로 적은 것이고, 오른쪽 |...| 영역은 32~126 범위 바이트만 문자로, 나머지는 점(.)으로 보여줍니다.
- 점(.)이 많다고 데이터가 손상된 것은 아니며, 화면 문자로 옮길 수 없는 값을 안전하게 표시한 것뿐입니다.
- 큰 데이터는 페이지 단위로 나눠 보여주므로, 화면에 보이는 부분이 전체 데이터의 전부는 아닙니다.
텍스트나 파일을 넣으면 설치나 회원가입 없이 바로 hex dump 결과를 확인할 수 있습니다.
자주 묻는 질문
텍스트를 입력했는데 왜 글자 수보다 바이트 수가 더 많나요?
영어와 숫자 같은 ASCII 문자는 UTF-8에서 1바이트로 인코딩되지만, 한글이나 이모지처럼 유니코드 범위가 넓은 문자는 보통 3~4바이트로 인코딩됩니다.
그래서 한글 한 글자를 입력해도 hex dump에는 여러 개의 바이트 값이 나타나고, ASCII 영역에는 그 글자 대신 점(.)이 바이트 수만큼 나열됩니다.
오프셋을 16진수로 볼 때와 10진수로 볼 때 숫자가 다른 이유는 뭔가요?
오프셋은 그 줄이 시작하는 바이트의 절대 위치를 8자리 숫자로 표시한 것입니다. 같은 위치라도 16진수로 적으면 예를 들어 00000010이고, 10진수로 적으면 00000016으로 보입니다.
가리키는 위치 자체는 동일하며, 어느 진법으로 숫자를 표기하느냐만 다른 것입니다.
ASCII 영역의 점(.)이 많으면 파일이 손상된 건가요?
아닙니다. 점은 화면에 문자로 옮겨 적을 수 없는 바이트, 즉 0x00~0x1F 범위의 제어문자나 127 이상의 비인쇄 바이트를 안전하게 대체한 표시입니다.
해당 바이트의 실제 값은 가운데 16진수 영역에 그대로 정확히 나타나 있으므로, 점의 개수만으로 파일 손상 여부를 판단할 수는 없습니다.
한 줄에 8바이트와 16바이트 중 어느 쪽이 표준인가요?
둘 다 실무에서 널리 쓰이며, 정해진 단일 표준은 없습니다. macOS·Linux의 hexdump -C 명령어는 기본적으로 한 줄에 16바이트를 보여주고, 일부 디버거나 도구는 8바이트 단위를 쓰기도 합니다.
한 줄당 바이트 수를 바꿔도 데이터 자체는 바뀌지 않고 줄 구분만 달라집니다.