
인라인 스타일을 CSS 클래스로 변환하는 원리
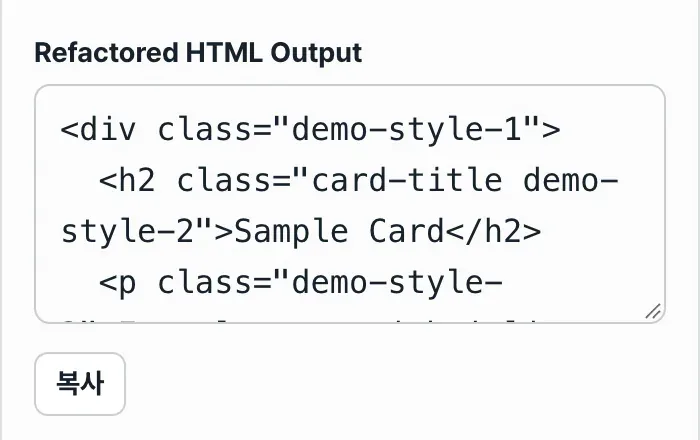
HTML 태그마다 style="..." 속성이 따로 붙어 있어 CSS로 한 번에 관리하기 어려운 문서를 다뤄본 적이 있다면, 인라인 스타일을 별도 CSS 클래스 규칙으로 자동 분리하는 도구가 도움이 됩니다.
이 글은 그 변환 과정에서 클래스명이 어떤 순서로 매겨지고, 스타일 선언이 어떻게 나뉘며, 기존 class 속성과 동일한 스타일 값이 각각 어떻게 처리되는지를 실제 동작 방식 그대로 설명합니다.
요약 ① 클래스명은 접두사+숫자 형태이며, style 속성이 있는 모든 요소를 DOM 문서 순서대로 통틀어 센 번호가 매겨집니다. ② style 값은 세미콜론으로 나눈 뒤 각 조각을 trim하고 빈 조각은 버리므로, 끝에 세미콜론이 있어도 빈 CSS 규칙이 생기지 않습니다. ③ 기존 class 속성은 지워지지 않고, 새로 만들어진 클래스명이 그 뒤에 그대로 추가됩니다.
이런 상황에서 인라인 스타일이 쌓입니다
노션에서 문서를 HTML로 내보내거나, 이메일 뉴스레터 빌더에서 만든 레이아웃을 복사해 붙여넣으면 문단·리스트 항목·표 셀마다 style="color:#333; font-size:14px;" 같은 속성이 개별적으로 붙어 있는 경우가 흔합니다.
이런 문서를 정적 페이지나 CMS 게시글로 옮기면, 나중에 색상이나 크기를 한 번에 바꾸려 해도 CSS 파일 하나를 고치는 게 아니라 태그마다 박힌 style 속성을 하나씩 찾아 고쳐야 합니다.
인라인 스타일과 클래스 기반 CSS가 뒤섞여 있으면 지금 화면에 어떤 규칙이 실제로 적용되고 있는지 파악하는 것도 번거로워집니다.
도구 없이 직접 분리하는 방법
이 작업은 손으로도 할 수 있습니다. 규칙은 다음과 같은 순서로 정리됩니다.
- HTML 문서 안에서
style="..."속성이 붙은 요소를 문서에 나온 순서(위에서 아래, 바깥 요소에서 안쪽 요소 순으로 트리를 훑는 순서)대로 찾습니다. - 접두사를 하나 정합니다(예:
c). 처음 발견한 스타일 요소부터c1,c2,c3순으로 번호를 매깁니다. 이 번호는 div·span·p 같은 태그 종류를 구분하지 않고, style 속성이 있는 요소 전체를 통틀어 이어서 셉니다. - 요소에 이미 class 속성이 있으면 지우지 않습니다. 기존 class 값 뒤에 공백을 두고 새로 만든 클래스명을 이어붙입니다. class 속성이 없던 요소라면 새로 만듭니다.
- style 속성의 값을 세미콜론(
;) 기준으로 나눕니다. 나뉜 조각마다 앞뒤 공백을 지우고(trim), 그 결과 빈 문자열이 된 조각은 버립니다. 마지막에 세미콜론이 하나 더 있어서 생기는 빈 조각이 여기서 걸러집니다. - 남은 선언들을 순서대로 이어
.클래스명 {\n 선언1;\n 선언2;\n}형태의 CSS 규칙 하나를 만듭니다. - 원래 있던 style 속성 자체는 지웁니다.
- 문서에 있는 모든 스타일 요소에 대해 2~6번을 반복하고, 만들어진 CSS 규칙을 전부 모아 하나의 스타일시트로 둡니다.
여기서 손으로 하면 특히 번거로운 지점이 있습니다. 이 규칙은 스타일 값이 같은지를 비교해서 합치지 않습니다.
즉 두 요소의 style 값이 글자 하나까지 똑같아도, 규칙을 그대로 따르면 각 요소마다 새 번호를 매긴 별도 클래스와 별도 CSS 규칙을 만들어야 합니다.
요소 수가 많아질수록 번호를 누락 없이 순서대로 이어가는 일 자체가 실수하기 쉬운 작업이 됩니다.
저희 도구로 확인하기.
브라우저에서 바로 변환되며 설치나 회원가입이 필요 없습니다.

결과를 읽을 때 헷갈리기 쉬운 지점들
변환 결과를 처음 보면 아래 다섯 가지가 특히 오해하기 쉽습니다.
| 헷갈리는 지점 | 실제 동작 |
|---|---|
| 클래스 번호를 매기는 기준 | 태그 종류 구분 없이, style 속성이 있는 모든 요소를 DOM 순서대로 통틀어 센 번호 |
| style 끝에 세미콜론이 있을 때 | trim 후 빈 문자열이 된 조각은 버려지므로 빈 CSS 규칙이 생기지 않음 |
| 원래 있던 class 속성 | 지워지지 않고, 새 클래스명이 기존 값 뒤에 공백으로 이어붙음 |
| style 값이 완전히 같은 두 요소 | 하나로 합쳐지지 않고, 각각 별도 번호의 클래스와 별도 CSS 규칙을 받음 |
| 태그가 닫히지 않는 등 구조가 깨진 입력 | 브라우저의 DOMParser가 자동으로 교정해 파싱하므로, 출력 HTML 구조가 원본 텍스트와 미묘하게 달라질 수 있음 |
특히 마지막 항목은 결과가 "이상해 보이는" 원인이 되곤 합니다. 이 도구는 입력한 문자열을 그대로 텍스트로 다루지 않고, 브라우저가 실제 HTML 문서를 해석할 때 쓰는 것과 같은 파서(DOMParser)로 읽습니다.
그래서 짝이 맞지 않는 태그나 잘못된 중첩처럼 형식이 어긋난 부분이 있으면, 파서가 자체 규칙에 따라 구조를 보정한 뒤 그 보정된 구조를 기준으로 클래스를 매기고 style을 추출합니다.
원본 텍스트를 한 글자도 바꾸지 않고 style만 쏙 빼내는 것이 아니라, 일단 파서가 이해한 문서 구조가 결과물의 기준이 되는 셈입니다.
클래스 번호가 태그 종류별로 따로 매겨지지 않는다는 점도 자주 헷갈립니다.
예를 들어 문서에 스타일이 걸린 요소가 <div>, <span>, <div> 순서로 나온다면 번호는 태그별로 div1, span1, div2가 아니라, 발견된 순서 그대로 c1, c2, c3이 됩니다.
정리
- 클래스명은 "접두사+번호" 형태이며, 번호는 style 속성이 있는 모든 요소를 DOM 문서 순서대로 통틀어 센 값입니다.
- style 값은 세미콜론으로 분리한 뒤 각 조각을 trim하고 빈 조각을 버리므로, 끝에 세미콜론이 있어도 빈 CSS 규칙이 생기지 않습니다.
- 기존 class 속성은 삭제되지 않고, 새 클래스명이 뒤에 추가되는 방식으로 유지됩니다.
- 스타일 값이 동일한 요소라도 자동으로 병합되지 않고, 요소마다 별도 클래스와 별도 CSS 규칙이 생성됩니다.
- 입력은 브라우저 DOMParser로 해석되므로, 태그 구조가 깨진 HTML을 넣으면 파서가 보정한 구조가 결과의 기준이 됩니다.
브라우저에서 바로 변환되며 설치나 회원가입이 필요 없습니다.
자주 묻는 질문
스타일 값이 완전히 같은 요소들은 하나의 클래스로 합쳐지나요?
아니요. 이 도구는 값을 비교해서 중복을 제거하지 않습니다. style 속성이 있는 요소는 값이 같더라도 각각 새 번호가 매겨진 별도 클래스를 받고, CSS 규칙도 요소 수만큼 따로 생성됩니다.
원래 걸려 있던 class 속성은 변환 후 사라지나요?
아니요. 기존 class 값은 그대로 남고, 새로 생성된 클래스명이 기존 값 뒤에 공백으로 추가됩니다. 기존 class를 지우고 새 클래스로 대체하는 방식이 아닙니다.
style 속성 끝에 세미콜론이 붙어 있으면 빈 CSS 규칙이 생기나요?
아니요. style 문자열은 세미콜론 기준으로 나뉜 뒤 각 조각의 앞뒤 공백이 제거되고, 그 결과 빈 문자열이 된 조각은 버려집니다. 그래서 style="color:red;"처럼 끝에 세미콜론이 있어도 빈 규칙이 CSS에 남지 않습니다.
태그가 깨진 HTML을 넣으면 결과도 원본 그대로 나오나요?
그대로는 아닙니다. 이 도구는 브라우저의 네이티브 DOMParser로 입력을 해석하는데, DOMParser는 닫히지 않은 태그처럼 형식이 어긋난 부분을 자체 규칙에 따라 자동으로 교정해서 파싱합니다. 그래서 출력되는 HTML 구조가 원본 텍스트와 미묘하게 달라질 수 있습니다.