
HTML 태그 제거로 본문 텍스트만 뽑아내기
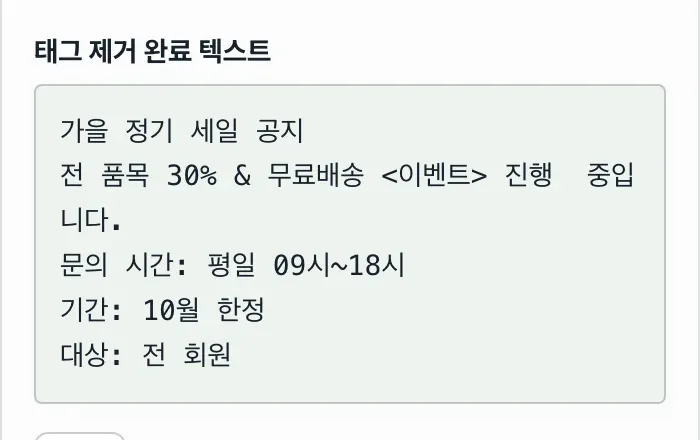
웹페이지 소스나 이메일에서 복사한 HTML을 붙여넣으면 <div>·<p>·& 같은 태그와 기호가 본문과 뒤섞여 나옵니다. 이걸 걷어내고 순수 본문 텍스트만 남기는 길은 텍스트 에디터의 정규식으로 직접 지우거나 태그 제거기에 붙여넣는 것, 두 가지입니다. 이 글은 두 방법이 각각 무엇을 하는지와, 태그 제거기의 네 옵션이 켜고 끌 때 결과를 어떻게 바꾸는지를 예시로만 설명합니다.
요약 ① '자바스크립트/CSS 제거'는 껍데기 태그뿐 아니라
<script>·<style>안의 코드 텍스트까지 지웁니다. 끄면 코드가 본문에 그대로 남습니다. ② '줄바꿈 보존'은</p>·</div>같은 닫는 블록 태그를 줄바꿈으로 바꿔 문단을 살립니다. 끄면 문장이 한 줄로 붙습니다. ③ 'HTML 엔티티 변환'을 끄면&·<· 가 그대로 남고, '빈 줄 제거'를 끄면 빈 줄과 들여쓰기가 남습니다.
복사한 HTML이 태그와 기호로 뒤덮이는 이유
흔한 상황이 하나 있습니다. 뉴스레터나 안내 메일의 내용을 문서로 옮기려고 'HTML 원본 보기'로 열어 복사했더니, 문장 사이사이에 <td>·<span>· 가 잔뜩 끼어 있는 경우입니다.
이유는 단순합니다. 브라우저나 메일 앱은 평소 HTML을 '렌더링'해서 태그를 숨기고 본문만 보여 줍니다. 그런데 원본 소스를 복사하면 렌더링 전 상태, 즉 태그가 글자 그대로 담긴 텍스트를 가져오게 됩니다.
특수기호도 같은 원리입니다. HTML 소스에서 &는 &로, <는 <로, 줄이 넘어가지 않는 공백은 로 적혀 있습니다. 렌더링될 때만 사람이 읽는 문자로 바뀌므로, 소스를 그대로 복사하면 이 '엔티티' 표기가 남습니다.
<script>와 <style> 블록은 또 다릅니다. 이 안에는 본문이 아니라 자바스크립트 코드와 CSS 규칙이 들어 있어서, 껍데기 태그만 지우면 그 코드 텍스트가 본문 사이에 그대로 노출됩니다.
도구 없이 직접 태그를 걷어내는 방법
도구 없이 해결하는 두 경로를 먼저 정리합니다. 상황에 따라 어느 쪽이든 그 자체로 완결됩니다.
방법 1: 렌더링한 뒤 서식 없이 붙여넣기
소스가 아니라 이미 화면에 그려진 페이지나 메일이 있다면, 보이는 본문을 드래그해 복사한 뒤 '서식 없이 붙여넣기'(Windows Ctrl+Shift+V, macOS Cmd+Shift+V)로 넣으면 태그 없이 텍스트만 들어갑니다.
이 방식은 렌더링이 되는 HTML에만 쓸 수 있고, 원본 소스 문자열 자체를 정리하려는 경우에는 해당하지 않습니다.
방법 2: 텍스트 에디터의 정규식 바꾸기
원본 소스를 직접 정리하려면 정규식을 지원하는 에디터(VS Code, Notepad++, Sublime Text 등)에서 '모두 바꾸기'를 순서대로 실행하면 됩니다.
- 스크립트·스타일·주석 통째 삭제:
<script[\s\S]*?</script>,<style[\s\S]*?</style>,<!--[\s\S]*?-->를 각각 빈 문자열로 바꿉니다. - 문단을 살리려면 닫는 블록 태그를 줄바꿈으로:
</(p|div|h[1-6]|li|tr|section)>를\n으로,<br\s*/?>·<hr\s*/?>도\n으로 바꿉니다. - 남은 태그 제거:
<[^>]*>를 빈 문자열로 바꿉니다. - 엔티티 복원:
&→&,<→<,>→>,"→",'→', →공백을 하나씩 바꿉니다. - 빈 줄 정리:
^\s*$\n(또는^\s*\n)을 빈 문자열로 바꿔 빈 줄을 없앱니다.
이 다섯 단계가 사실상 태그 제거기가 내부에서 하는 일과 같은 순서입니다. 도구는 이 과정을 입력할 때마다 자동으로 실행할 뿐입니다.
저희 도구로 확인하기.
설치·회원가입 없이 브라우저에서 바로 실행되며, 입력한 HTML은 서버로 전송되지 않고 화면에서만 처리됩니다.

자주 헷갈리는 네 가지 옵션
태그 제거기의 체크박스 네 개는 기본적으로 모두 켜져 있습니다. 각각을 끄면 결과가 이렇게 달라집니다.
| 옵션 | 켰을 때 | 껐을 때 |
|---|---|---|
| 자바스크립트/CSS 제거 | <script>·<style> 안의 코드 텍스트까지 삭제 | 껍데기 태그만 지워 코드가 본문에 남음 |
| 줄바꿈 보존 | 닫는 블록 태그·<br>·<hr>를 줄바꿈으로 변환 | 문단이 한 줄로 붙음 |
| HTML 엔티티 변환 | &·<· 를 &·<·공백으로 복원 | 기호가 그대로 남음 |
| 빈 줄/공백 제거 | 빈 줄 삭제 + 각 줄 앞뒤 공백 정리 | 줄 끝 공백만 정리, 빈 줄·들여쓰기 유지 |
껍데기만 지울 때와 코드까지 지울 때
입력:
<style>.box{color:red}</style>
<p>환영합니다</p>
<script>track('view')</script>
'자바스크립트/CSS 제거'가 켜져 있으면 결과는 환영합니다 한 줄입니다. 끄면 껍데기 <style>·<script> 태그만 사라지고 안의 코드가 텍스트로 남습니다.
.box{color:red}
환영합니다
track('view')
문단이 붙는 이유
입력이 <p>첫 문단</p><p>둘째 문단</p>일 때, '줄바꿈 보존'이 켜져 있으면 두 줄로 나뉩니다.
첫 문단
둘째 문단
끄면 첫 문단둘째 문단처럼 한 줄로 붙습니다. 닫는 블록 태그를 줄바꿈으로 바꾸는 단계가 생략되기 때문입니다.
엔티티를 안 바꾸면 기호가 남는다
입력이 <p>A & B, 값 < 10, 무료 배송</p>일 때 옵션에 따라 이렇게 갈립니다.
- 'HTML 엔티티 변환' 켜짐 →
A & B, 값 < 10, 무료 배송 - 'HTML 엔티티 변환' 꺼짐 →
A & B, 값 < 10, 무료 배송
끄면 &를 &가 아니라 글자 그대로 읽게 되어, 결과를 잘못 옮기기 쉬운 지점입니다.
빈 줄을 남길지 말지
입력:
<ul>
  <li>사과</li>
  <li>배</li>
</ul>
'빈 줄/공백 제거'가 켜져 있으면(줄바꿈 보존도 켠 상태) 결과는 두 줄로 정리됩니다.
사과
배
끄면 각 줄의 끝 공백만 정리되고, 항목 앞의 들여쓰기 공백과 태그 사이 빈 줄은 그대로 남습니다.
정리
- 복사한 HTML이 지저분한 건 렌더링 전 소스라서입니다. 태그와
&같은 엔티티가 글자 그대로 담겨 있습니다. - '자바스크립트/CSS 제거'는 껍데기 태그만이 아니라
<script>·<style>안의 코드까지 지웁니다. 끄면 코드가 본문에 남습니다. - '줄바꿈 보존'은 닫는 블록 태그를 줄바꿈으로 바꿔 문단을 살립니다. 끄면 한 줄로 붙습니다.
- 'HTML 엔티티 변환'을 끄면
&·<· 가 그대로 남고, '빈 줄 제거'를 끄면 빈 줄과 들여쓰기가 유지됩니다. - 도구 없이도 정규식 다섯 단계로 같은 결과를 낼 수 있고, 도구는 그 순서를 입력할 때마다 자동으로 실행합니다.
설치·회원가입 없이 브라우저에서 바로 실행되며, 입력한 HTML은 서버로 전송되지 않고 화면에서만 처리됩니다.
자주 묻는 질문
입력한 HTML이 서버로 전송되나요?
아니요. 이 도구는 순수 클라이언트(브라우저) 방식이라, 입력값을 서버로 보내지 않고 화면 안에서만 계산합니다. 입력창에 값이 바뀔 때마다 즉시 결과가 다시 그려집니다.
script나 style 안의 코드도 지워지나요?
'자바스크립트/CSS 제거' 옵션이 켜져 있으면 껍데기 태그뿐 아니라 안에 적힌 자바스크립트 함수·CSS 규칙 텍스트까지 통째로 삭제합니다. 이 옵션을 끄면 태그만 사라지고 코드가 본문에 텍스트로 남습니다.
결과에 엔티티 기호가 그대로 남아요.
'HTML 엔티티 변환' 옵션이 꺼져 있기 때문입니다. 켜면 &는 &로, <·>는 <·>로, 는 공백으로 복원되고, ' 같은 숫자 문자 코드도 사람이 읽는 문자로 바뀝니다.
문단 구분이 안 되고 한 줄로 붙어 나옵니다.
'줄바꿈 보존'은 닫는 블록 태그(</p>·</div>·</h1~6>·</li>·</tr>·</section> 등)와 <br>·<hr>만 줄바꿈으로 바꿉니다. 원본이 <span>·<a> 같은 인라인 태그만 쓰거나 문단을 공백으로만 나눴다면 새 줄이 생기지 않습니다.