
JSONキー camelCase↔snake_case変換の方法
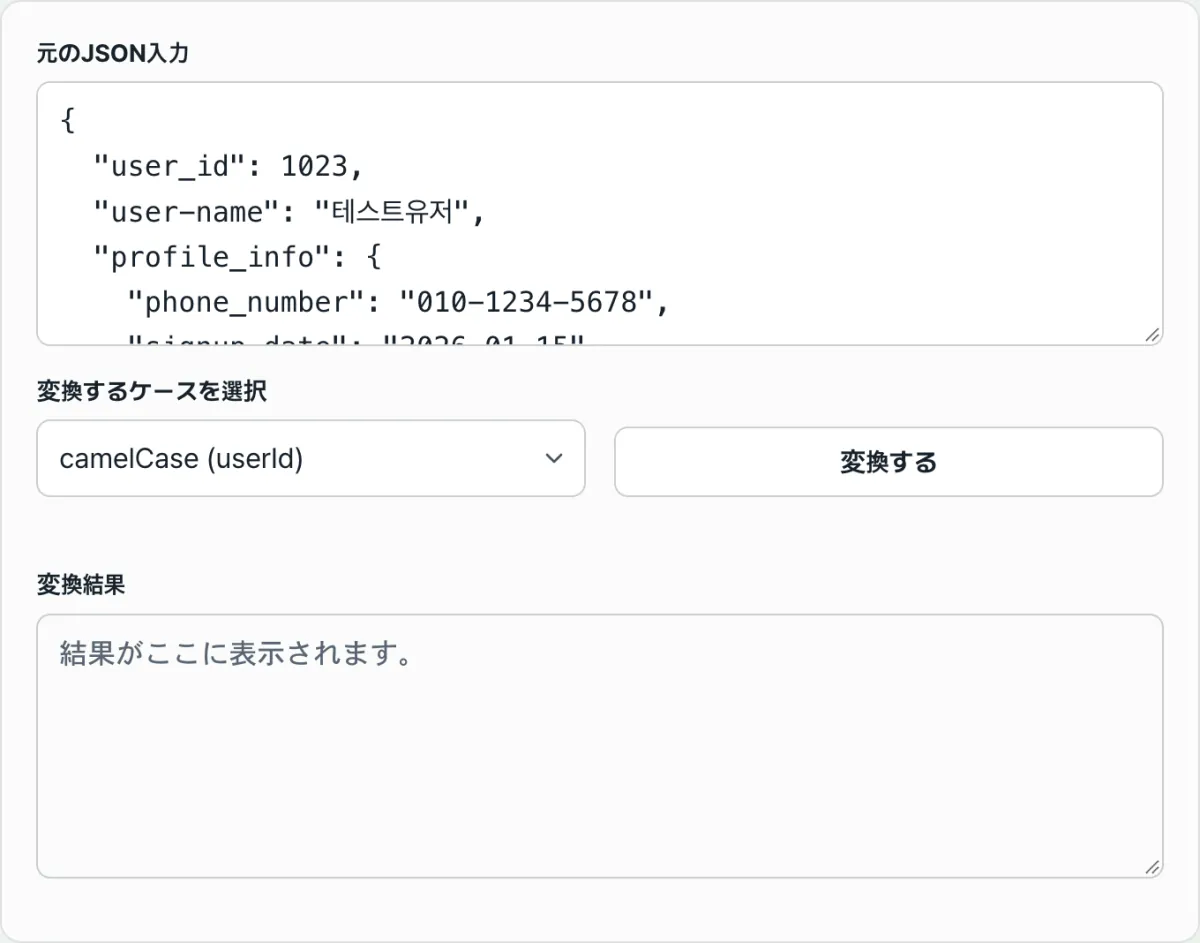
APIのレスポンスはsnake_caseなのに、フロントエンドのコードはcamelCaseの規約で書かれている。そんなとき、key名を毎回手で書き換える代わりに、表記法の変換ルールをひとつ覚えておけば済みます。
camelCase・snake_case・PascalCase・kebab-caseは、どれも「単語をどう区切って、どうつなぎ直すか」という同じ原理の上に成り立つ表記ルールです。この記事では、そのルールを手作業で適用する方法と、自動変換ツールでよく見落とされる例外ケースを整理します。
まとめ ① camelCase・snake_case・PascalCase・kebab-caseは、単語の区切り方だけが違う、同じデータの表記法です。 ② 変換は、大文字の位置とアンダースコア・ハイフンの位置で単語を区切り、目的の表記法に合わせてつなぎ直す処理です。 ③ ネストしたオブジェクトや配列の中のkeyにも、同じルールがdepth制限なしで再帰的に適用されます。
この問題が実際に起きる場面
この問題は、異なる言語やフレームワークの慣習がAPIをひとつ挟んで出会うときに起こります。バックエンドがPython系のフレームワークで書かれていれば、レスポンスJSONのkeyはたいていsnake_case(user_id、created_at)で返ってきます。
一方、フロントエンドがJavaScript・TypeScriptなら、コードの規約はcamelCase(userId、createdAt)を使うことが多いです。
そのままレスポンスを使うと、ひとつのファイルの中にuser_idとuserNameが混在したコードになってしまいます。フィールドが数個ならマッピング関数を手で書いて済ませられますが、フィールドが数十個あって、その中にネストしたオブジェクトや配列まで混ざっていると、深いdepthのkeyをひとつ見落としやすくなります。
ツールを使わず、表記ルールどおりに手で変換する方法
四つの表記法は、どれも同じ原理でできています。key名を「単語」単位に区切り、その単語を表記法ごとに決められた方法でつなぎ直すだけです。
単語を区切る基準は二つだけです。camelCase・PascalCaseのように区切り文字を使わない表記法では、大文字が始まる位置を新しい単語の始まりと見なし、snake_case・kebab-caseのように区切り文字を使う表記法では、アンダースコア(_)やハイフン(-)が現れる位置で区切ります。
単語を区切ったら、下のルールに従ってつなぎ直せば完了です。
| 表記法 | 結合ルール | 例(user, id) |
|---|---|---|
| camelCase | 最初の単語は小文字、以降の単語は先頭の文字だけ大文字にして、区切り文字なしでつなぐ | userId |
| snake_case | すべての単語を小文字にし、アンダースコア(_)でつなぐ | user_id |
| PascalCase | すべての単語の先頭文字を大文字にし、区切り文字なしでつなぐ | UserId |
| kebab-case | すべての単語を小文字にし、ハイフン(-)でつなぐ | user-id |
ネストしたオブジェクト・配列も同じルール
たとえば { "user_id": 1, "profile": { "email_address": "a@test.com" } } をcamelCaseに変換するなら、user_idはアンダースコアで区切られてuserIdになり、ネストしたprofileオブジェクトの中のemail_addressも同じルールでemailAddressになります。
最上位のkeyだけ変えて内側のオブジェクトをそのままにすると、半分しか変わっていない結果になります。区切られたすべてのdepthに同じルールを繰り返し適用する必要があります。
配列が混ざっていてもルールは同じです。order_listのように配列自体のkeyはorderListに変わり、その配列の要素が { order_id: 1 } のようなオブジェクトであれば、要素の中のkeyも同じルールで変わります。要素が文字列や数値なら(例:"tags": ["new", "sale"])、変換すべきkey自体が存在しないので、値はそのまま残ります。
正規表現で自動化する方法
この処理をプログラムで実装するときは、正規表現で扱うのが一般的です。camelCaseに変換する関数は、「-」や「_」の直後に来る小文字を探して大文字に変えながら区切り文字を消す、という置換一回で済みます。
snake_caseやkebab-caseに変換する関数はその逆で、大文字が現れる位置ごとに区切り文字を挟み込んでから全体を小文字にします。PascalCaseは、camelCaseの結果の先頭文字だけを大文字にすれば完成です。
keyが数個しかないなら、このルールを手で適用しても十分です。しかしdepthが何層にもなり、keyの数が増えてくると、一つずつ手で変換している途中でネストした部分のkeyを見落としやすくなります。Dynamic Labsの無料ツールは、この再帰的な適用を自動で処理します。
無料ツールで確認してみましょう。
登録なしで無料で利用でき、「変換」ボタンを押すとすぐに結果が表示されます。
よく誤解されるポイント
ルール自体はシンプルですが、実際のデータではいくつかのkeyの形によって、結果が想定と違うものになることがあります。
| 状況 | 結果 |
|---|---|
| ハイフン・アンダースコアの混在(user-id_name) | どちらの区切り文字も単語の区切りとして認識され、camelCase変換ではuserIdNameのように正しくつながる |
| すでに大文字で始まるkey(UserId) | snake_case・kebab-case変換では、大文字の位置ごとに区切り文字を入れるルールのため、先頭文字の前にも区切り文字が残り、_user_id、-user-idのように出力されることがある |
| 値(value)が文字列・数値・真偽値・null | 変換対象はkeyのみで、値の中身は元のまま維持される |
| JSONの文法が正しくない場合 | 変換されず、JSON.parseが発生させたエラーメッセージがそのまま画面に表示される |
区切り文字が混在するkey、大文字で始まるkey
ハイフンとアンダースコアがひとつのkeyの中に混在していても(user-id_name)、心配する必要はありません。どちらの区切り文字も「新しい単語の始まり」として認識されるため、camelCaseに変換するとuserIdNameのように正しくつながります。
逆に、元のkeyがすでにPascalCaseのように大文字で始まっている場合(UserId)は、結果をよく確認する必要があります。snake_case・kebab-caseに変換するルールは「大文字が現れる位置ごとに区切り文字を挟み込む」方式なので、先頭の文字が大文字だとその位置にも区切り文字が付き、結果の先頭に区切り文字が残ることがあります。
結果の先頭に区切り文字が見えたら、元のkeyが大文字で始まっていたというサインだと読めばよいでしょう。
値(value)とJSON文法エラー
値(value)は変換対象ではありません。文字列・数値・真偽値・nullの値は、表記法に関係なく元の内容のまま残ります。値の中にたまたまuser_idのような文字列が入っていても、その文字列自体は変わりません。
JSONの文法が誤っているときは、変換の代わりにパースエラーのメッセージがそのまま画面に表示されます。角括弧・波括弧の対応が取れていない、keyを二重引用符で囲んでいない、最後の項目の後ろにカンマが残っている(trailing comma)、単一引用符を二重引用符の代わりに使っている、といった場合によく起こります。
エラーメッセージに含まれるpositionの数字は、文字列の先頭から空白も含めて何文字目で問題が起きたかを示すので、その位置の周辺を確認すると原因を絞り込めます。
まとめ
- camelCase・snake_case・PascalCase・kebab-caseは、単語を区切ってつなぎ直すルールだけが違う、同じデータの表記法です。
- 大文字が始まる位置と、アンダースコア・ハイフンの位置が、単語を区切る基準になります。
- ネストしたオブジェクトや配列の中のkeyにも、同じルールをdepth制限なしで繰り返し適用しないと、すべては変わりません。
- 元のkeyが大文字で始まっていると、snake_case・kebab-case変換の結果の先頭に区切り文字が残ることがある、と覚えておくとよいでしょう。
- keyではない値(value)の中身は変換対象ではなく、JSONの文法が誤っていればパースエラーのメッセージがそのまま表示されます。
登録なしで無料で利用でき、「変換」ボタンを押すとすぐに結果が表示されます。
よくある質問
ネストされたオブジェクトや配列の中のキーも変換されますか?
はい。オブジェクトの中にさらに別のオブジェクトが入っている場合や、配列の中にオブジェクトが入っている場合でも、その中のすべてのキーを深さの制限なく再帰的に探し、同じルールで変換します。
入力欄のJSONを編集すると、結果も自動で変わりますか?
いいえ。変換は「変換する」ボタンを押した時点の入力値で1回だけ実行されます。入力を修正した後は、もう一度ボタンを押さないと新しい結果は表示されません。
キー名ではなく値(value)の中の文字列も表記法が変わるのですか?
いいえ。変換の対象はキー名だけです。文字列・数値・真偽値・null といった値は元の形のまま維持されます。
「JSON文法エラー」というエラーが出るのですが、何が問題なのでしょうか?
入力した文字列が JSON.parse の求める文法に従っていない場合です。最後の項目の後ろのカンマ(trailing comma)、シングルクォートの使用、キーをダブルクォートで囲んでいないことなどがよくある原因です。画面に表示されるエラーメッセージに含まれる position の数字から、何文字目で問題が起きているのかを確認できます。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む