
A/B-Test: statistische Signifikanz und p-Wert berechnen
Inhalt
- Eine höhere Conversion-Rate macht noch keinen echten Gewinner
- Statistische Signifikanz: der mathematische Maßstab
- Die Technik dahinter: Two-Proportion Z-Test und die Formeln des statistischen Tests
- Vergleichsübersicht: Entscheidungskriterien nach Konfidenzniveau
- Die 5 schwersten Fehler bei der Auswertung von A/B-Tests
- In 5 Schritten zum sauber validierten A/B-Test
- 7 Praxistipps für A/B-Tests
- Entscheidungsbaum: Wie gehen Sie mit den Testergebnissen um?
- Spickzettel: Die wichtigsten Begriffe zu A/B-Tests und statistischen Tests
- Häufig gestellte Fragen
Nur weil Variante A oder B eine minimal höhere Conversion-Rate erzielt hat, sollten Sie B nicht einfach zum Gewinner erklären. Bei geringen Impressionen und Conversions kann der Unterschied schlicht Zufall sein.
Ob ein Ergebnis belastbar ist und Sie keine falsche Entscheidung treffen, zeigt die „statistische Signifikanz".
Das Wichtigste in Kürze ① Um das Ergebnis eines A/B-Tests zu beurteilen, reicht es nicht, die Conversion-Raten einfach zu vergleichen. Sie müssen die gesamten Daten aus Impressionen und Conversions statistisch prüfen. ② Statistische Signifikanz liegt vor, wenn der p-Wert kleiner ist als das gewählte Signifikanzniveau (meist 5 %, also ein Konfidenzniveau von 95 %). ③ Wer während des Tests laufend auf die Ergebnisse schaut und den Test vorzeitig beendet (Peeking-Problem), hält zufällige Verzerrungen leicht für einen Sieg. Das sollten Sie unbedingt vermeiden.
Eine höhere Conversion-Rate macht noch keinen echten Gewinner
Ein häufiger Fehler bei A/B-Tests: Man wählt die Variante, die auch nur um Nachkommastellen besser abschneidet.
Nehmen wir an, bei Variante A haben 3 von 100 Besuchern konvertiert (Conversion-Rate 3 %), bei Variante B 4 von 100 (4 %). Rein rechnerisch sieht B um 33 % besser aus. Tatsächlich entscheidet aber ein einziger zufälliger Klick über diesen Unterschied.
Wie viele Nutzer müssen also gesehen und konvertiert haben, damit Sie den Unterschied als „echten Erfolg statt Zufall" bezeichnen können?
Statistische Signifikanz: der mathematische Maßstab
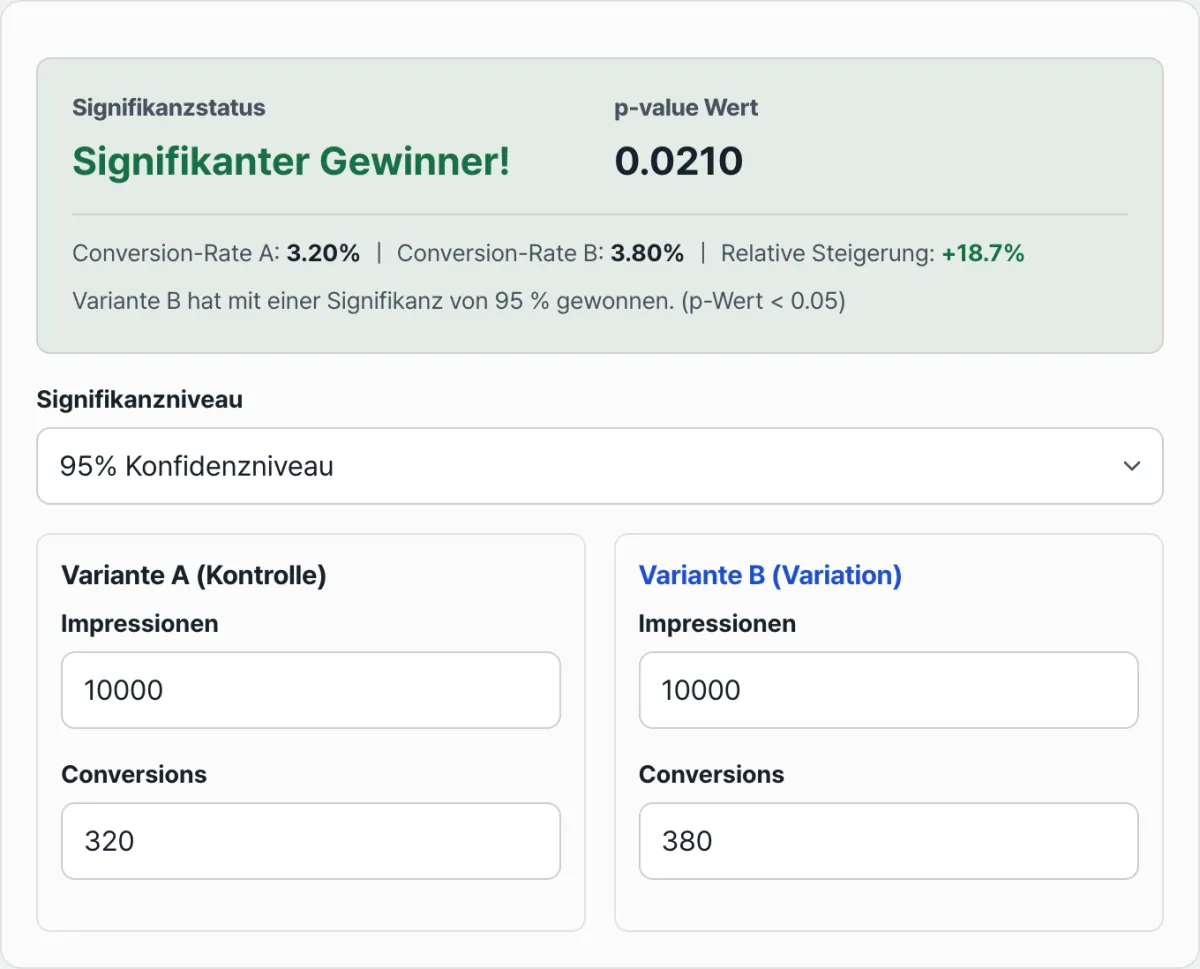
Dazu verwendet die Statistik den Z-Test (Two-Proportion Z-Test, Zweistichproben-Test für Anteile), mit dem sich der Unterschied zwischen den Anteilen zweier unabhängiger Gruppen prüfen lässt.
Der zentrale Begriff ist dabei der p-Wert. Er gibt die Wahrscheinlichkeit an, einen Unterschied in dieser Größe oder größer allein durch den Zufall der Stichprobenziehung zu beobachten, obwohl es in Wirklichkeit gar keinen Leistungsunterschied zwischen den beiden Varianten gibt (Nullhypothese).
In digitalen Produkten und im Marketing gilt üblicherweise ein Konfidenzniveau von 95 % (Signifikanzniveau α = 0,05) als Standard. Liegt der p-Wert unter 0,05, ist die Wahrscheinlichkeit, dass der Unterschied rein zufällig entstanden ist, kleiner als 5 %. Dann gilt der Sieg als statistisch signifikant.
Kostenlos · ohne Registrierung · nur Impressionen und Conversions eingeben und in 1 Sekunde p-Wert und Gewinner erhalten
Nach der Auswertung wird das Ergebnis wie folgt eingeordnet:
- Gewinner! Signifikante Verbesserung (Statistically Significant): Beim gewählten Konfidenzniveau (95 % oder 99 %) ist Variante B statistisch nachweisbar eindeutig besser als A.
- Kein Unterschied (Inconclusive / Not Significant): Die Abweichung zwischen Variante A und B ist bloß ein Stichprobenfehler bzw. Rauschen. Ein signifikanter Gewinner lässt sich nicht bestimmen. Sie müssen weitere Daten sammeln.
Die Technik dahinter: Two-Proportion Z-Test und die Formeln des statistischen Tests
Hier sehen Sie, welche statistische Mathematik ein A/B-Test-Rechner im Hintergrund ausführt.
1. Gepoolter Anteil (Pooled Proportion) und Berechnung des Z-Werts
Die gesamten Impressionen beider Gruppen seien NA und NB, die Conversions XA und XB:
- Gepoolter Anteil (Pooled Proportion): P = (XA + XB) / (NA + NB)
- Standardfehler (Standard Error): SE = sqrt(P(1 - P)(1/NA + 1/NB))
- Z-Statistik (Z-Score): Z = (PB - PA) / SE
- Berechnung des p-Werts: Über die Verteilungsfunktion (CDF) der Standardnormalverteilung N(0, 1) wird für den zweiseitigen Test (Two-tailed test) p = 2 * (1 - Phi(|Z|)) berechnet.
2. Fehler 1. Art (Type I Error) vs. Fehler 2. Art (Type II Error)
- Fehler 1. Art (alpha, falsch positiv): Die Wahrscheinlichkeit, einen Gewinner anzunehmen, obwohl es tatsächlich keinen Unterschied gibt (Standard: 5 %).
- Fehler 2. Art (beta, falsch negativ): Die Wahrscheinlichkeit, einen tatsächlich vorhandenen Unterschied nicht zu erkennen (Standard: 20 %).
- Teststärke (Statistical Power, 1 - beta): Die Wahrscheinlichkeit, einen echten Gewinner korrekt zu finden. Für ein verlässliches Experiment sollten es mindestens 80 % sein.
Vergleichsübersicht: Entscheidungskriterien nach Konfidenzniveau
| Konfidenzniveau (Confidence) | Signifikanzniveau (p-Wert-Schwelle) | Z-Score-Grenzwert | Geeignetes Umfeld |
|---|---|---|---|
| 90 % Konfidenzniveau | p < 0,10 | |Z| >= 1,645 | Frühe Start-ups, schnelle Hypothesentests bei wenig Traffic |
| 95 % Konfidenzniveau (globaler Standard) | p < 0,05 | |Z| >= 1,960 | Gängige Web-/App-Oberflächen, Copywriting, Landingpage-Experimente |
| 99 % Konfidenzniveau | p < 0,01 | |Z| >= 2,576 | Zahlungsabläufe im Finanzbereich, Preisgestaltung, sensible Geschäftsmodelle |
Die 5 schwersten Fehler bei der Auswertung von A/B-Tests
- Peeking-Problem (Peeking Problem): Während des Experiments jeden Tag ins Dashboard schauen und den Test beenden, sobald der p-Wert unter 0,05 fällt (die Wahrscheinlichkeit für falsch positive Ergebnisse steigt dadurch von 5 % auf bis zu 30 %).
- Zu geringe Stichprobe (Underpowered Test): Voreilige Entscheidungen, bevor die mindestens erforderliche Stichprobengröße (Sample Size) erreicht ist.
- Missbrauch einseitiger Tests (One-tailed): Man schließt aus, dass B schlechter als A sein könnte, und halbiert mit einem einseitigen Test künstlich den p-Wert. Das verzerrt das Ergebnis.
- Gleichzeitige Wechselwirkungen: Mehrere unabhängige A/B-Tests laufen parallel für dieselben Nutzer, wodurch die Ergebnisse verfälscht werden.
- Saisonalität und Wochentagseffekte (Seasonality Bias): Daten aus besonderen Zeiträumen wie Zahltag, Wochenende oder Black Friday werden fälschlich verallgemeinert.
In 5 Schritten zum sauber validierten A/B-Test
- Schritt 1 (Hypothese aufstellen und Stichprobengröße vorab berechnen): Berechnen Sie anhand der Ausgangs-Conversion-Rate (Baseline) und des minimal nachweisbaren Effekts (MDE: Minimum Detectable Effect) im Voraus die mindestens nötige Stichprobengröße.
- Schritt 2 (Experiment starten und mindestens 7 Tage volle Laufzeit): Um Verzerrungen durch das Nutzerverhalten an einzelnen Wochentagen auszuschließen, teilen Sie den Traffic mindestens eine Woche lang (7 bis 14 Tage) im Verhältnis 50:50 zufällig auf (Randomized Split).
- Schritt 3 (Einmalige Endauswertung nach abgeschlossener Datenerhebung): Ziehen Sie die Daten erst, wenn die vorab festgelegte Stichprobengröße und Laufzeit erreicht sind.
- Schritt 4 (Mit dem Signifikanzrechner prüfen): Geben Sie Impressionen und Conversions von Variante A und B insgesamt ein und prüfen Sie p-Wert und Konfidenzintervall (Confidence Interval).
- Schritt 5 (Entscheiden und Learnings im Unternehmen teilen): Bei p < 0,05 rollen Sie die Gewinnervariante aus. Ist das Ergebnis nicht signifikant, dokumentieren Sie die möglichen Gründe für das Scheitern aus Sicht der Hypothese und berücksichtigen sie im nächsten Experiment.
7 Praxistipps für A/B-Tests
- MDE (minimal nachweisbarer Effekt) realistisch bei 5 bis 10 % ansetzen: Wer einen winzigen Unterschied von 1 % nachweisen will, braucht Traffic in Millionenhöhe. In der Praxis ist ein MDE von 5 bis 10 % deshalb passend.
- Goldene Regel: volle Wochenzyklen (Full Week Cycle): Auch wenn Sie die Zielstichprobe dank hohem Traffic schon nach 2 Tagen erreicht haben, lassen Sie den Test unbedingt volle 7 Tage laufen, um Wochentagseffekte auszugleichen.
- Breite des Konfidenzintervalls (Confidence Interval) prüfen: Schauen Sie nicht nur, ob gewonnen oder verloren wurde, sondern auch auf die Spanne der Verbesserung von Variante B (z. B. +5 % bis +12 %), um die geschäftliche Wirkung abzuschätzen.
- Testplattform mit A/A-Tests auf Integrität prüfen: Spielen Sie dieselbe Variante A im Verhältnis 50:50 aus und testen Sie vorab, ob die p-Werte gleichverteilt sind. So finden Sie Fehler in der Logik der Traffic-Verteilung.
- Segmentanalyse im Nachhinein (Post-hoc Segmentation): Auch wenn das Gesamtergebnis nicht signifikant ist, prüfen Sie gegen, ob sich in bestimmten Segmenten wie „Neue Besucher" oder „Mobile Nutzer" eine deutliche Signifikanz zeigt.
- Mikro-Conversions (Micro-conversion) als Kennzahl nutzen: Reichen die Käufe (Makro-Conversions) nicht aus, werten Sie zusätzlich die Signifikanz von Zwischenmetriken wie „In den Warenkorb gelegt" oder „Scrollen auf der Produktseite" aus.
- Guardrail-Metriken (Guardrail Metric) überwachen: Auch wenn die Conversion-Rate von Variante B gestiegen ist, prüfen Sie gleichzeitig unbedingt, ob sich Kennzahlen zur Produktgesundheit wie Absprungrate, Ladezeit oder Rückerstattungsanfragen nicht verschlechtert haben.
Entscheidungsbaum: Wie gehen Sie mit den Testergebnissen um?
- Fall A (p < 0,05 & höhere Conversion-Rate & Konfidenzintervall positiv) ➔ Variante B vollständig ausrollen (Winner Rollout)
- Fall B (p >= 0,05 & Stichprobengröße erreicht) ➔ Hypothese verwerfen und Original A beibehalten (Inconclusive – No Effect)
- Fall C (p >= 0,05 & Stichprobengröße noch nicht erreicht) ➔ Testdauer verlängern und weitere Daten sammeln (Continue Experiment)
- Fall D (p < 0,05 & Conversion-Rate sinkt) ➔ Variante B sofort stoppen und zum Original zurückkehren (Statistically Significant Loss)
Spickzettel: Die wichtigsten Begriffe zu A/B-Tests und statistischen Tests
- p-Wert (Signifikanzwert): Die Wahrscheinlichkeit, bei zutreffender Nullhypothese ein Ergebnis zu beobachten, das mindestens so extrem ist wie die erhobenen Daten.
- Konfidenzniveau (Confidence Level): Die Wahrscheinlichkeit, dass der wahre Wert im Konfidenzintervall liegt, wenn man dasselbe Experiment 100-mal wiederholt (üblicherweise 95 %).
- Nullhypothese (Null Hypothesis, H0): Die Grundannahme, dass es zwischen Variante A und Variante B keinen Leistungsunterschied gibt.
- Alternativhypothese (Alternative Hypothesis, H1): Die Behauptung, dass es zwischen Variante A und Variante B einen bedeutsamen Leistungsunterschied gibt.
- Z-Test (Z-Test): Ein parametrisches Testverfahren auf Basis der Normalverteilung, das prüft, ob der Unterschied zwischen den Anteilen zweier Gruppen statistisch signifikant ist.
Häufig gestellte Fragen
Kann ich den Test auch durchführen, wenn der Traffic (Impressionen) von Variante A und B nicht genau 50:50 verteilt ist?
Ja. Die vom A/B-Test Signifikanzrechner verwendete Formel des Two-Proportion Z-Tests berechnet Z-Wert und p-Wert auch dann korrekt, wenn die Stichproben unterschiedlich groß sind, da sie den Standardfehler beider Gruppen gewichtet mittelt. Sie können die Daten also problemlos auswerten.
Was soll ich tun, wenn der p-Wert nur knapp über der Grenze liegt, etwa bei 0,051?
0,05 ist eine übliche Konvention als Schwellenwert. Bei 0,051 lässt sich statistisch kein eindeutiger Sieg feststellen, es deutet aber auf einen starken Trend hin. Sie können den Test daher um einige Tage verlängern, um weitere Daten zu gewinnen, oder die Guardrail-Metriken gesamthaft prüfen und flexibel entscheiden.
Werden die Impressionen und Conversion-Daten meines Unternehmens, die ich in den Rechner eingebe, nach außen weitergegeben?
Nein. Alle Berechnungen dieses Tools laufen lokal in der JavaScript-Engine Ihres Browsers. Es werden keinerlei Daten an einen externen Server übertragen, sodass Sie auch zentrale interne KPIs bedenkenlos überprüfen können.
Dieser Artikel basiert auf unserem koreanischen Original. Koreanisches Original lesen