
JSON 平坦化の方法: キーの結合ルール
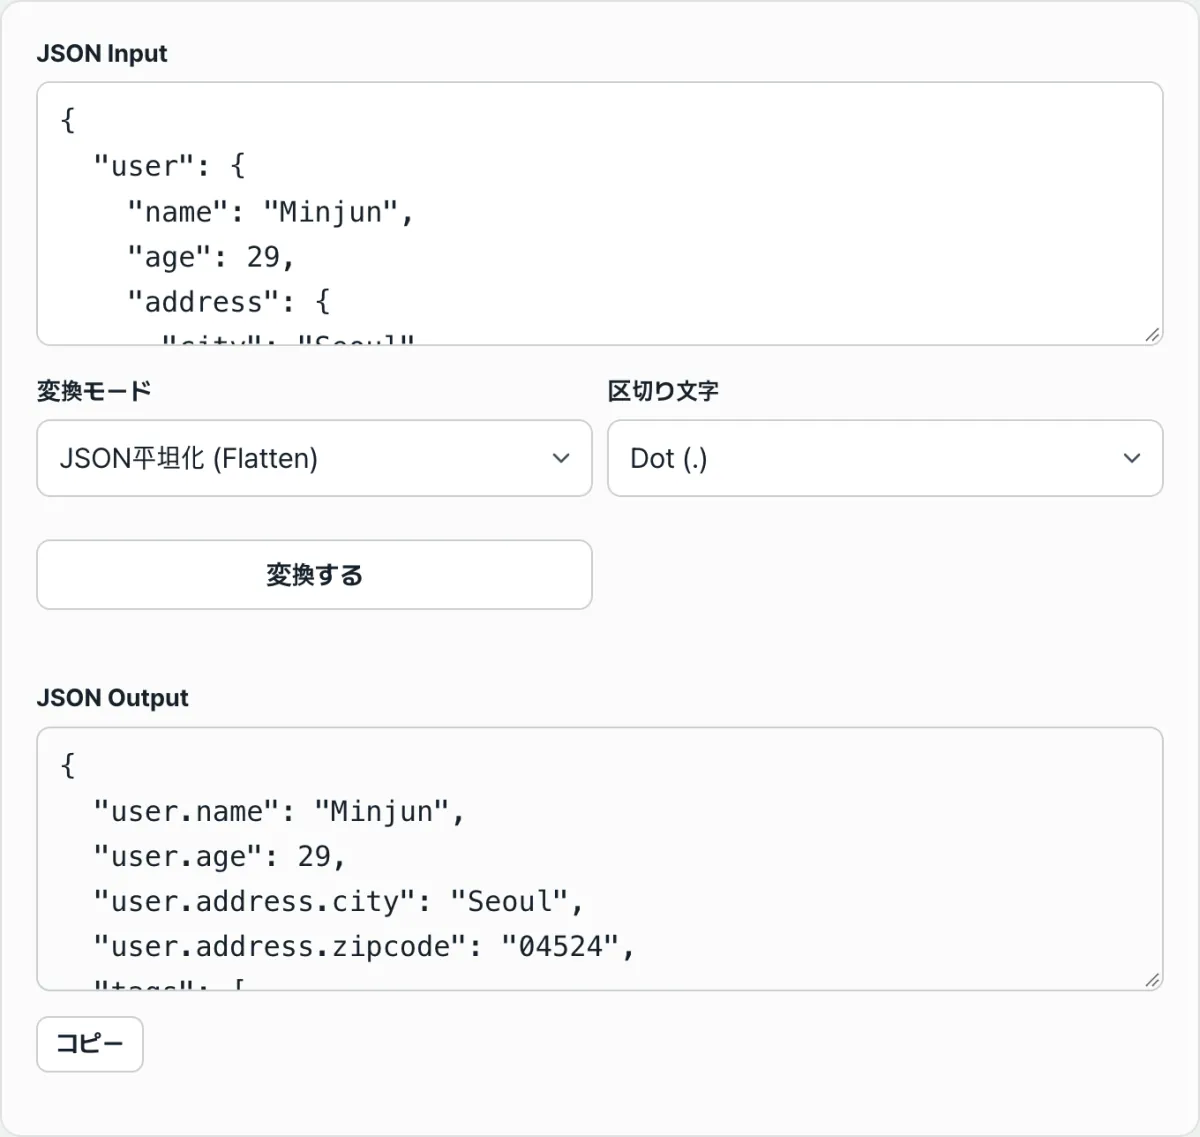
深くネストしたJSONオブジェクトをExcelやCSVに移すには、何段にも包まれた階層構造を、1つの表に収められる1次元のキーと値の構造に変換する必要があります。この変換をJSONの平坦化(Flatten)と呼び、逆に1次元構造を元のネストしたオブジェクトに戻す処理を構造化(Unflatten)と呼びます。どちらも決まったルールに従って機械的に動く計算なので、ルールさえ分かればツールなしでも手で再現できます。
要点 ① ネストしたオブジェクトのキーは「親キー+区切り文字+子キー」の形にまとめられ、1次元構造になります。 ② 配列(Array)はオブジェクトではないため平坦化の対象から外れ、元のままの値が保たれます。 ③ 区切り文字に選んだ文字が元のキーにすでに含まれていると、Unflatten時にそのキーが意図せずさらに分割されます。
ネストしたJSONを表に移そうとしたときに起きる問題
APIのレスポンスや設定ファイルは、オブジェクトの中にさらにオブジェクトが入っている構造がよくあります。たとえば {"user": {"name": "山田太郎", "address": {"city": "東京"}}} のように、ユーザー情報の中に住所情報がもう一段包まれている形です。
この構造をそのままExcelやCSVに移すと問題が起きます。表は1つのセルに1つの値しか入れられませんが、address のように値がまるごとオブジェクトである項目を入れると、列が正しく作られなかったり、値が壊れて見えたりします。
そこで address.city のように、親キーと子キーを1つの列名にまとめた1次元構造が必要になります。この変換を毎回手作業で組み直さず、正確なルールで処理しようというのが平坦化です。
ツールなしで手作業で変換するルール
FlattenとUnflattenは、それぞれ決まった再帰ルール1つで動きます。ルールに沿って進めれば、小さなJSONなら手で直接変換することもできます。
平坦化(Flatten)のルール
あるキーの値が純粋なオブジェクト(配列ではなく、nullでもない {} の形)であれば、その中に入って子キーをそれぞれ「親キー+区切り文字+子キー」という新しい名前で最上位に引き上げます。値がオブジェクトでなければ(配列を含む)、元のキーのまま結果に書き出します。
次のJSONをドット(.)区切りで平坦化するとします。
{"user": {"name": "山田太郎", "address": {"city": "東京"}}, "tags": ["a", "b"]}user はオブジェクトなので中に入ります。user.name は「山田太郎」、user.address はまたオブジェクトなのでもう一段入り、user.address.city は「東京」になります。tags は配列でオブジェクトではないため、そのまま残ります。
{"user.name": "山田太郎", "user.address.city": "東京", "tags": ["a", "b"]}構造化(Unflatten)のルール
逆方向は、各キーを区切り文字で分割し、その断片を順番にたどりながらネストしたオブジェクトを作り直す処理です。キーを区切り文字で分けた断片を前から1つずつたどり、存在しない階層は新しく作り、最後の断片に元の値を入れます。
上で作った平坦データを再度構造化すると、user.address.city は user、address、city の3つの断片に分かれ、user オブジェクトの下に address オブジェクトを作り、その下に city: "東京" を入れます。user.name も同じ user オブジェクトの下に合流し、元のネスト構造がそのまま復元されます。
無料ツールで確認する。
入力したJSONはサーバーに送信されず、ブラウザ内だけで平坦化・構造化の変換が行われます。
間違えやすいポイント: 配列の扱いと区切り文字の選び方
特に混同しやすいのが2点です。1つは配列があるときに結果が想定と違ってくること、もう1つは区切り文字の選び方によってUnflattenの結果が元と変わってしまうことです。
配列があるときに出る結果
まず配列です。{"users": [{"name": "山田太郎"}, {"name": "佐藤花子"}]} のように配列の中にオブジェクトが入っていても、users の値そのものが配列なので平坦化の対象から外れます。配列内の {"name": "山田太郎"} オブジェクトまで掘り下げて users.0.name のようにインデックスを付けて展開することはなく、users キーの下に配列が元のまま丸ごと残ります。
| 値の形 | 平坦化時の扱い |
|---|---|
純粋なオブジェクト {} | 再帰的に中へ入り、子キーを親キー+区切り文字+子キーにまとめる |
配列 [](内部にオブジェクトがあっても) | 再帰せず、元の配列をそのまま値として保持 |
| 文字列・数値・真偽値・null | 元のキーの下にそのまま保持 |
区切り文字の選び方で結果が変わるケース
次は区切り文字です。区切り文字は、Flattenでキーをまとめるときに使った文字を、Unflattenで再び分割するときにもそのまま使います。元のデータのキー自体にその区切り文字がすでに入っていた場合、Unflattenはそのキーを意図した以上に細かく分割してしまいます。
たとえば {"商品価格.ウォン": 15000} のように、キー名そのものにドットが入っている平坦データがあるとします。これをドット(.)区切りで構造化すると、商品価格 と ウォン の2つの断片に分かれ、{"商品価格": {"ウォン": 15000}} という、本来の意図にはなかったネストしたオブジェクトが作られてしまいます。
バージョン番号(1.2.3)やファイル拡張子、ドメイン名のように、ドットを含むキーを扱うときによく起きるケースです。こうしたときは、元のキーに現れない文字、たとえばアンダースコア(_)やスラッシュ(/)を区切り文字に選ぶと、この問題を避けられます。
まとめ
- 平坦化は純粋なオブジェクトだけを再帰的に展開し、「親キー+区切り文字+子キー」の形の新しいキーを作ります。
- 配列はオブジェクトではないので平坦化されず、内部にオブジェクトが入っていても元のまま値として残ります。
- 構造化は各キーを区切り文字で分割し、順番にネストしたオブジェクトを作り直す逆の処理です。
- 区切り文字は元のキーにない文字を選ぶことで、Unflatten時の意図しない追加分割を避けられます。
- 形式が正しくないテキストはJSON.parseの段階で弾かれ、変換の代わりにエラーとして表示されます。
入力したJSONはサーバーに送信されず、ブラウザ内だけで平坦化・構造化の変換が行われます。
よくある質問
配列の中のオブジェクトも平坦化されますか?
いいえ。値が配列であれば、それ自体がオブジェクトではないと判定され、再帰の対象から外れます。配列の中に {"name": "山田太郎"} のようなオブジェクトが入っていても、users.0.name のようにインデックスを付けて展開されることはなく、配列が元のまま値として保たれます。
区切り文字はどれを選べばいいですか?
ドット(.)、スラッシュ(/)、アンダースコア(_)から選べ、既定値はドットです。元のキー名にすでにその文字が入っていると、Unflatten時に意図せずさらに分割されることがあるため、キーに現れない文字を選ぶほうが安全です。
値がnullの場合はどう処理されますか?
nullは純粋なオブジェクトとは判定されないため再帰の対象にならず、元のキーの下にそのまま保持されます。子キーに分割されることはありません。
正しくないJSONを入れるとどうなりますか?
JSON.parseが失敗する形式(引用符の欠落、カンマの誤りなど)であれば、変換は実行されず、赤いエラーメッセージが表示されて出力欄は空になります。元のテキストが有効なJSONかどうかを先に確認してください。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む