
モックJSONのダミーデータ生成とAPIテスト設計
Webサービス開発の初期段階で、バックエンドAPIサーバーのデータベースモデル設計やAPIコントローラーのエンドポイント実装がまだ完了していないと、フロントエンドの開発者は機能の検証やUIレイアウトのレンダリングに苦労することになります。
そんなとき必要になるのが、API仕様書に記載されたJSON構造と一致する精巧なダミーデータ(Mock Data)です。この記事では、ランダムなダミーJSONデータをコードで直接生成する方法と、その過程で見落としがちなAPIテストのチェックポイントをまとめます。
1. ダミーデータ生成の基本構造
定型化された偽のデータセット(Mock JSON)を自動生成するロジックは、ほとんどが次のような繰り返し構造に集約されます。
mockDataset = [ template(i) for i in 1..N ]ここでNは生成したいレコード(Record)の総数、template(i)はインデックスiを受け取り、ランダムなデータフィールドを埋めたオブジェクトを1つ返す関数です。
データ項目ごとにランダム値を埋める方法
- 一意の識別子(連番ID / UUID):
連番の整数値(
i + 1)、または標準RFC4122規格に準拠する36桁のUUID文字列(ブラウザのcrypto.randomUUID())を割り当てます。 - ランダムな名前の選択:
あらかじめ用意した名前の配列からインデックスをランダムに取り出して1つ選びます。
const selectedName = list[Math.floor(Math.random() * list.length)]; - 日付範囲へのランダムな割り当て:
開始時刻と終了時刻の間のミリ秒区間からランダムな地点を選び、日付文字列に変換します。
const randomDate = start + Math.random() * (end - start);
この3つのパターンさえ押さえれば、連番ID・UUID・名前・日付が混ざったダミーレコードを自分でコードで作れます。ただしフィールドが増えたり、スキーマを頻繁に変更したりする場合は、毎回このロジックを手で書き直すよりも、フィールド名と型を指定するだけで結果をすぐに出力してくれるツールを使うほうが速く進みます。
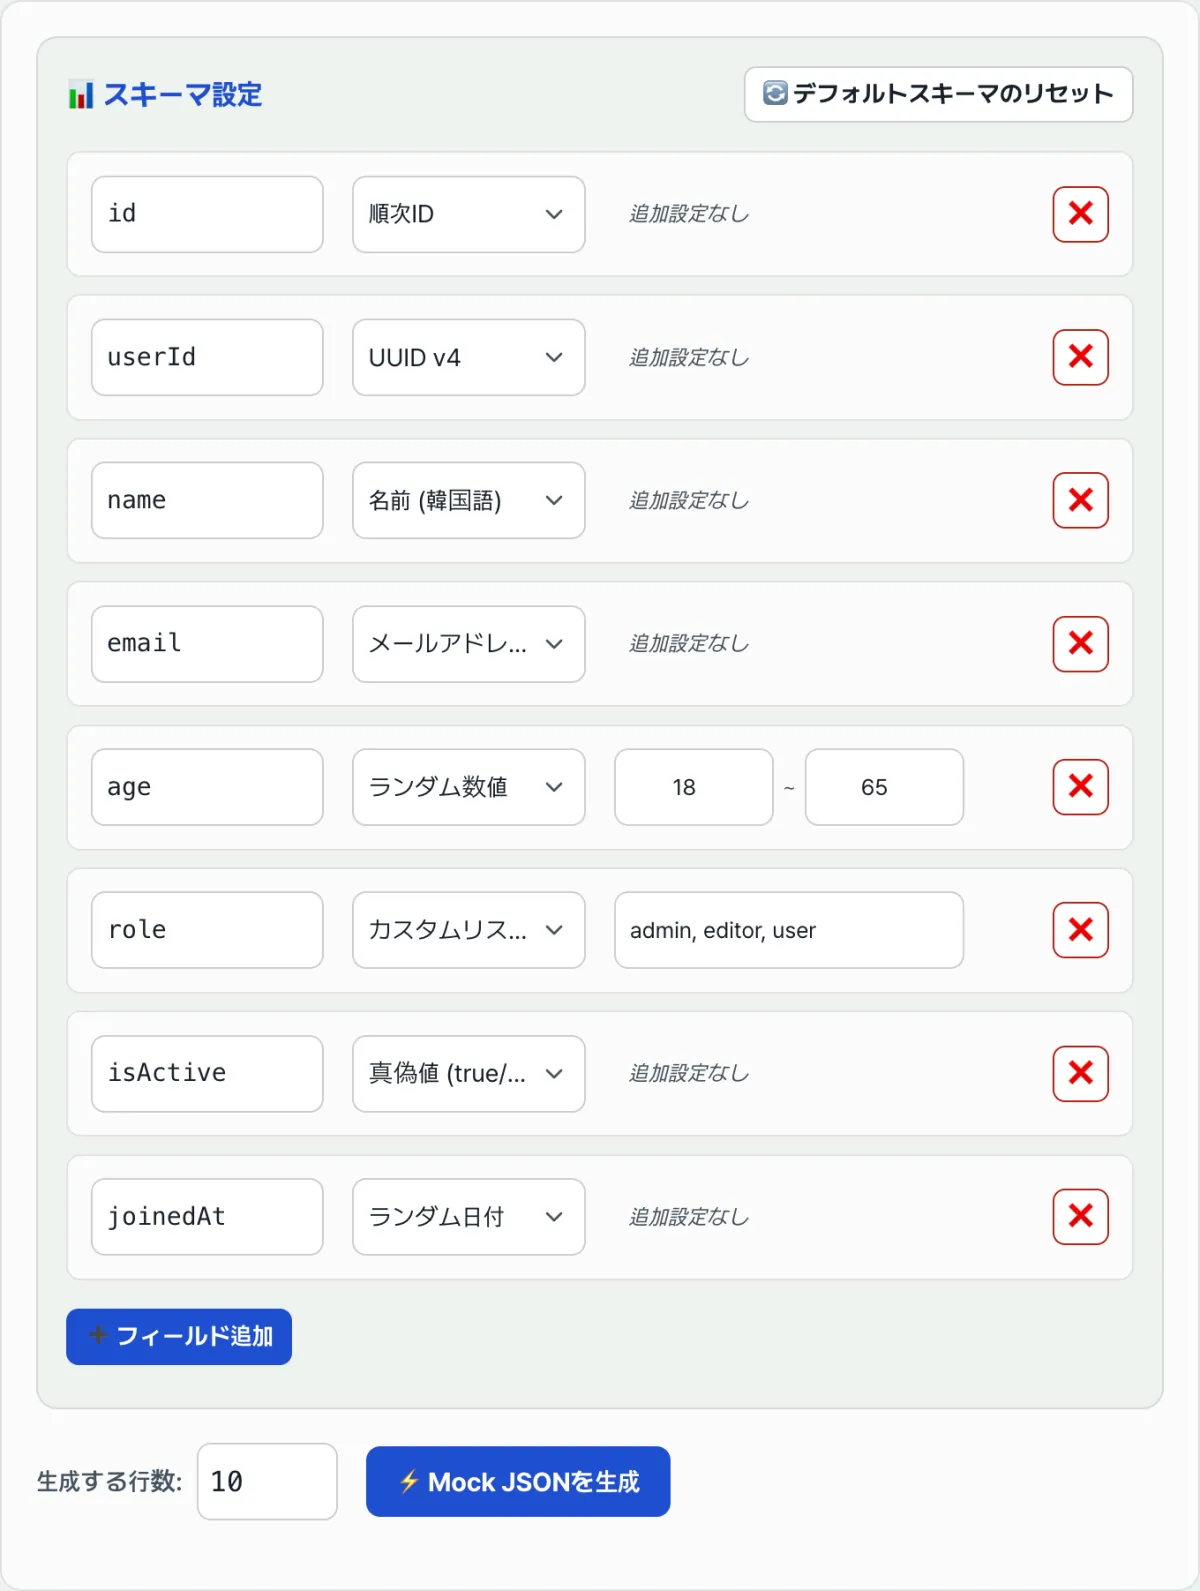
私たちのツールで確認する。 フィールド名・データ型・行数を指定するだけで、上記のロジックをそのまま適用したJSON配列をすぐに生成します。
必要な件数と、オブジェクトのフィールド名・データ型(氏名、メール、乱数など)を指定すると、ダミーのJSON配列データをすぐに出力できます。
2. 偽データ(Mock JSON)を使ったAPIテストのチェックポイント
偽データをWeb UIに連携してテストするときは、実際のリモートサーバーとの通信環境に近いレイテンシ(Network Latency)もあわせて模擬するとよいでしょう。
- ネットワーク遅延の模擬:
ローカル開発環境ではデータの読み込みが0msに近く、ローディングスピナーなどのUIコンポーネントが実際に表示されるかどうかを確認するのが困難です。
PromiseとsetTimeoutを組み合わせて、意図的に任意の遅延を入れてテストします。// 実際のAPI通信のように動作する、偽データ取得用のPromise function fetchMockUsers() { return new Promise((resolve) => { setTimeout(() => { resolve(mockUserDatabase); }, 800); // 0.8秒のネットワークレイテンシを人為的に付与 }); }
ダミーデータを作るたびにコード上へデータ生成用の関数を新しく書き足す代わりに、必要なデータ量とスキーマ構造を指定するだけで、Mock JSON配列をすぐに生成してコピーできます。
3. 完全なAPI模擬のためのダミーデータの注意点
| 項目 | 確認するポイント |
|---|---|
| エッジケース | 極端に長い名前の値、値が空のnull、空の配列など、異常なレコードを一部混ぜておくと、レイアウトの崩れやCannot read property of undefinedのような参照エラーを事前に見つけられます |
| リレーションデータの整合性 | 投稿と投稿者を一緒に生成する場合、投稿のauthorIdの値が投稿者リストのidのいずれかと一致していなければ、画面へのバインディングでエラーが起きます |
| データ型 | フロントエンドのコードが期待する型(文字列/数値/真偽値)と、実際に生成された値の型が一致しているかを確認します |
まとめ
- ダミーデータの生成は、結局のところインデックスを使った繰り返し処理の中で、フィールドごとにランダムな値を埋めていく構造です。
- 連番ID・UUID・名前・日付は、それぞれ決まったルール(カウンター、
crypto.randomUUID()、配列のインデックス参照、区間の乱数)で埋められます。 - エッジケースと参照の整合性をあわせて確認することで、実際の画面で起きるエラーを事前に防げます。
必要な件数と、オブジェクトのフィールド名・データ型(氏名、メール、乱数など)を指定すると、ダミーのJSON配列データをすぐに出力できます。
よくある質問
対応しているデータ型にはどのようなものがありますか?
フィールドごとに、連番ID、UUID、名前、メールアドレス、乱数、日付、真偽値、そして単語リストを自分で指定するカスタムEnumまで、型を選べます。フィールド名と型、生成する行数(Row count)を決めるだけで、それに合ったJSON配列が作成されます。
カスタムEnumはどのように動作しますか?
カンマ(,)で区切った単語リスト(例: admin, user, guest)を書いておくと、各行のデータを生成するときに、その単語の中から1つをランダムに割り当てます。ステータス値やロール(Role)のように、決まった値のうち1つだけが入るべきフィールドに適しています。
できあがった結果はどのように使いますか?
「生成する」ボタンを押すと、結果のJSONデータを画面ですぐに確認でき、クリップボードへのコピーやファイルへの保存ができるので、そのままフロントエンドのモックアップコードやAPIテストに貼り付けて使えます。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む