
Mock-JSON für Testdaten erzeugen: Formeln und API-Tests
Inhalt
In der frühen Phase der Webentwicklung ist oft das Datenbankmodell des Backends noch nicht fertig, und die Endpunkte der API-Controller sind nicht implementiert. Dann haben Frontend-Entwickler Mühe, Funktionen zu prüfen und das UI-Layout zu rendern.
In diesem Fall brauchen Sie unbedingt realistische Dummy-Daten (Mock-Daten), die der JSON-Struktur aus der API-Spezifikation entsprechen. Dieser Beitrag zeigt, wie Sie zufällige Dummy-JSON-Daten selbst per Code erzeugen, und fasst die API-Testpunkte zusammen, die dabei häufig übersehen werden.
1. Grundstruktur der Dummy-Daten-Erzeugung
Die Logik zum automatischen Erzeugen strukturierter Fake-Datensätze (Mock-JSON) lässt sich meist auf folgende Schleifenstruktur zurückführen:
mockDataset = [ template(i) for i in 1..N ]Dabei ist N die Gesamtzahl der zu erzeugenden Datensätze (Records). template(i) ist eine Funktion, die den Index i entgegennimmt und ein Objekt mit zufällig befüllten Feldern zurückgibt.
So werden die Felder mit Zufallswerten befüllt
- Eindeutige Kennung (fortlaufende ID / UUID):
Zugeordnet wird entweder eine fortlaufende Ganzzahl (
i + 1) oder ein 36-stelliger UUID-String nach dem Standard RFC4122 (im Browser mitcrypto.randomUUID()). - Zufällige Namensauswahl:
Aus einem vorbereiteten Namensarray wird ein zufälliger Index gezogen und damit ein Name ausgewählt.
const selectedName = list[Math.floor(Math.random() * list.length)]; - Zufälliges Datum in einem Zeitraum:
Zwischen Start- und Endzeitpunkt wird im Millisekundenbereich ein zufälliger Punkt gewählt und in einen Datumsstring umgewandelt.
const randomDate = start + Math.random() * (end - start);
Mit diesen drei Mustern können Sie Dummy-Datensätze aus fortlaufenden IDs, UUIDs, Namen und Datumswerten auch direkt im Code erzeugen. Wächst die Zahl der Felder jedoch und ändert sich das Schema häufig, ist es schneller, ein Werkzeug zu nutzen, bei dem Sie nur Feldnamen und Typen angeben und sofort das Ergebnis erhalten, statt diese Logik jedes Mal von Hand neu zu schreiben.
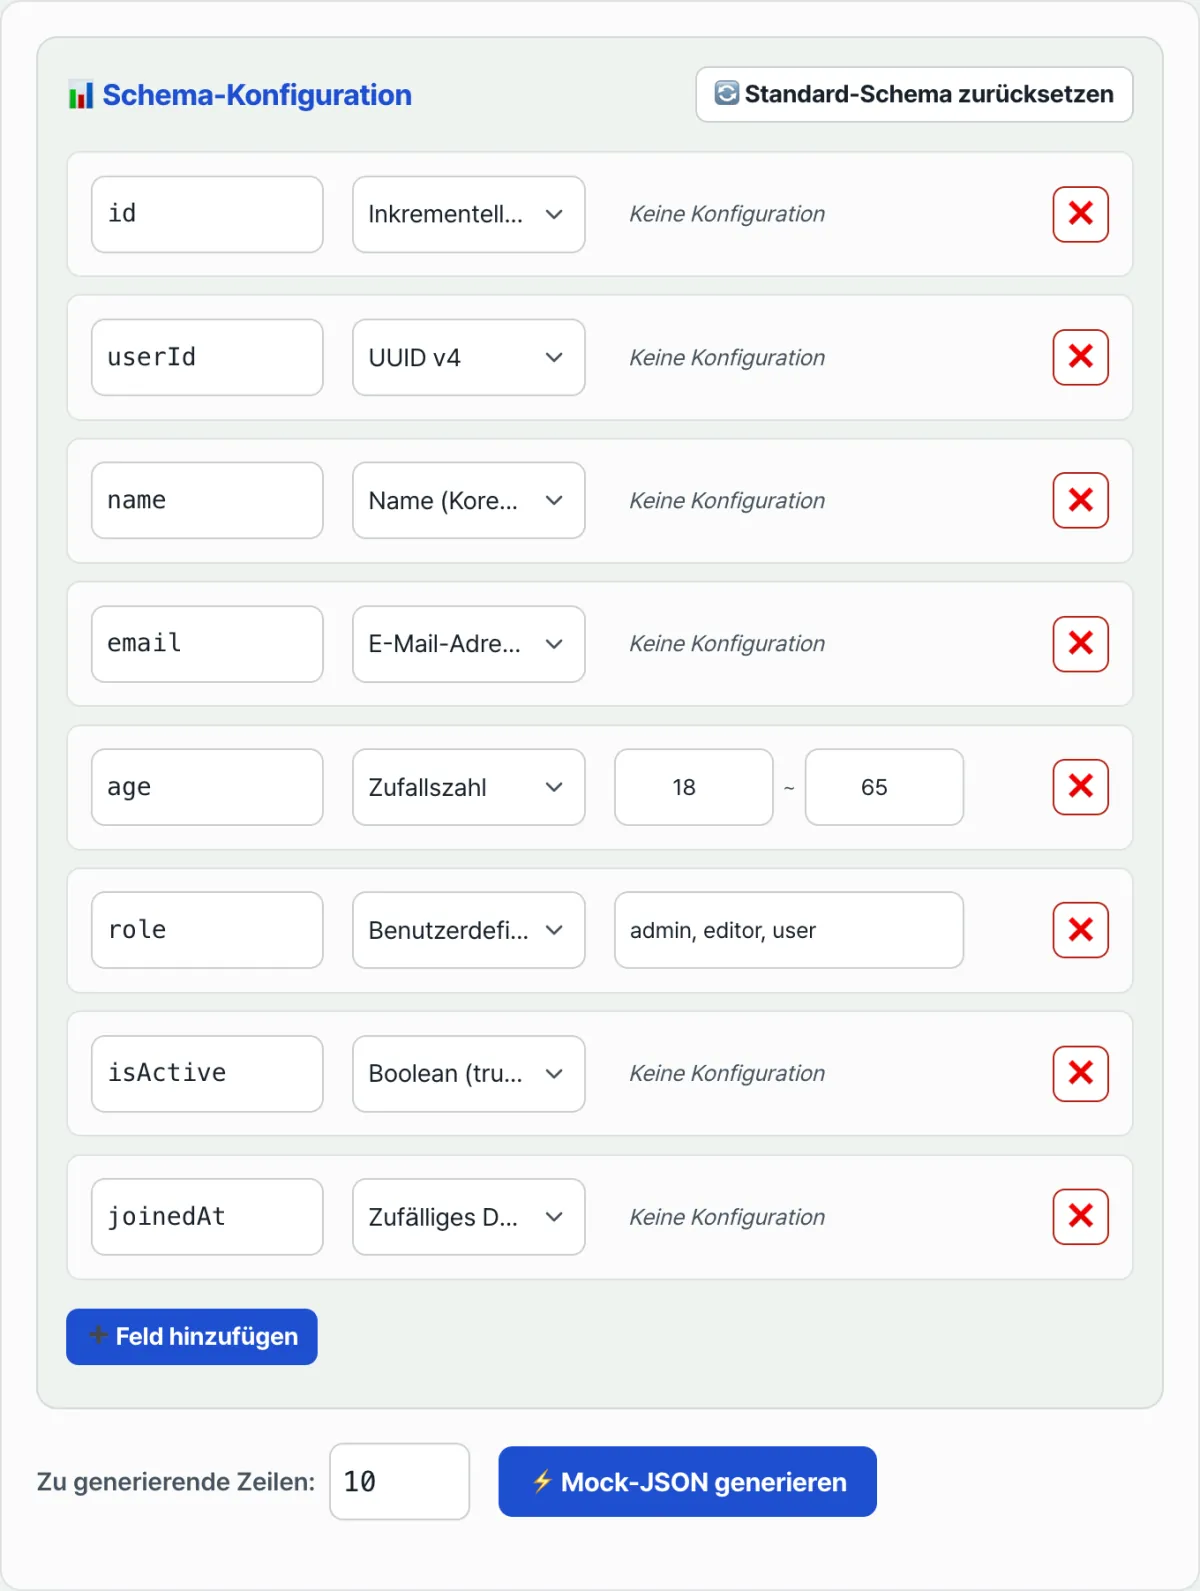
Mit unserem Tool ausprobieren. Sie geben nur Feldnamen, Datentypen und Zeilenanzahl an, und der Mock-JSON-Generator für Testdaten erzeugt sofort ein JSON-Array nach der oben beschriebenen Logik.
Legen Sie Anzahl der Datensätze, Feldnamen und Datentypen (Name, E-Mail-Adresse, Zufallszahl usw.) fest und erzeugen Sie sofort ein JSON-Array mit Testdaten.
2. Checkpunkte für API-Tests mit Mock-JSON
Wenn Sie Fake-Daten zum Testen an die Web-UI anbinden, sollten Sie zusätzlich eine Latenz (Netzwerklatenz) simulieren, die der Kommunikation mit einem echten Remote-Server ähnelt.
- Netzwerkverzögerung simulieren:
In der lokalen Entwicklungsumgebung liegt die Ladezeit der Daten nahe bei 0 ms. Dadurch lässt sich kaum prüfen, ob UI-Komponenten wie ein Ladeindikator (Spinner) tatsächlich angezeigt werden. Kombinieren Sie
PromiseundsetTimeout, um bewusst eine beliebige Verzögerung einzubauen.// Promise für Fake-Daten, das sich wie ein echter API-Aufruf verhält function fetchMockUsers() { return new Promise((resolve) => { setTimeout(() => { resolve(mockUserDatabase); }, 800); // künstliche Netzwerklatenz von 0,8 Sekunden }); }
Statt jedes Mal eine neue Funktion zur Datenerzeugung in den Code zu tippen, legen Sie nur die gewünschte Datenmenge und die Schemastruktur fest. Das Mock-JSON-Array können Sie dann direkt erzeugen und kopieren.
3. Worauf Sie bei Dummy-Daten für eine realistische API-Simulation achten sollten
| Punkt | Worauf Sie achten sollten |
|---|---|
| Randfälle | Mischen Sie einige untypische Datensätze unter, etwa besonders lange Namen, leere Werte als null oder leere Arrays. So entdecken Sie Layoutfehler oder Referenzfehler wie Cannot read property of undefined frühzeitig |
| Konsistenz relationaler Daten | Wenn Sie Beiträge und Autoren gemeinsam erzeugen, muss der Wert authorId eines Beitrags mit einer id aus der Autorenliste übereinstimmen, damit beim Binding in der Ansicht keine Fehler auftreten |
| Datentypen | Prüfen Sie, ob die Typen der erzeugten Werte (String/Zahl/Boolean) denen entsprechen, die der Frontend-Code erwartet |
Zusammenfassung
- Das Erzeugen von Dummy-Daten besteht im Kern darin, in einer indexbasierten Schleife die Felder mit Zufallswerten zu füllen.
- Fortlaufende IDs, UUIDs, Namen und Datumswerte werden jeweils nach festen Regeln befüllt (Zähler,
crypto.randomUUID(), Array-Indexzugriff, Zufallszahl im Intervall). - Prüfen Sie Randfälle und die Konsistenz von Referenzen gemeinsam, um Fehler in der echten Ansicht frühzeitig abzufangen.
Legen Sie Anzahl der Datensätze, Feldnamen und Datentypen (Name, E-Mail-Adresse, Zufallszahl usw.) fest und erzeugen Sie sofort ein JSON-Array mit Testdaten.
Häufig gestellte Fragen
Welche Datentypen werden unterstützt?
Pro Feld können Sie einen Typ wählen: fortlaufende ID, UUID, Name, E-Mail-Adresse, Zufallszahl, Datum, Boolean sowie ein benutzerdefiniertes Enum, bei dem Sie eine eigene Wortliste angeben. Sie legen nur Feldnamen, Typen und die Anzahl der zu erzeugenden Zeilen (Row Count) fest, und es wird ein passendes JSON-Array erstellt.
Wie funktioniert ein benutzerdefiniertes Enum?
Tragen Sie eine durch Kommas (,) getrennte Wortliste ein (z. B. admin, user, guest). Beim Erzeugen jeder Zeile wird dann eines dieser Wörter zufällig zugewiesen. Das eignet sich für Felder wie Status oder Rolle, in die nur einer von mehreren festen Werten gehören darf.
Wie verwende ich das erzeugte Ergebnis?
Wenn Sie auf die Schaltfläche „Erzeugen“ klicken, können Sie das JSON-Ergebnis direkt auf dem Bildschirm prüfen. Sie können es in die Zwischenablage kopieren oder als Datei speichern und unverändert in Frontend-Mockups oder API-Tests einfügen.
Dieser Artikel basiert auf unserem koreanischen Original. Koreanisches Original lesen