
ランダム数字抽選の仕組み: Math.randomの偏りと対策
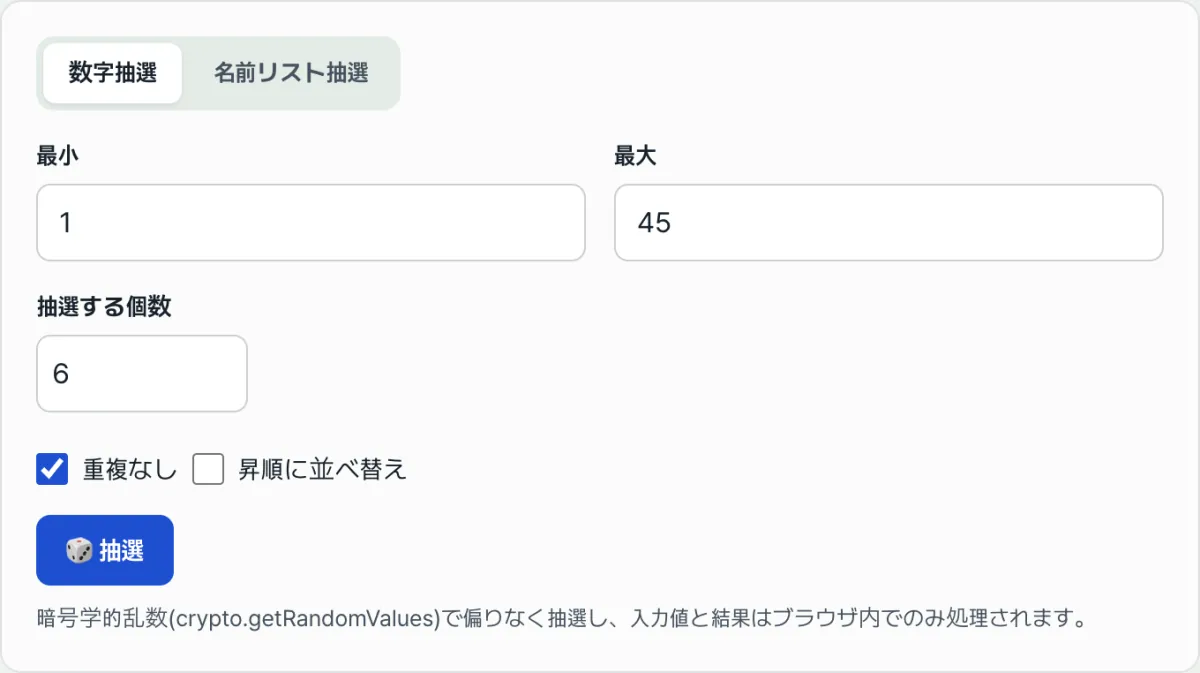
イベントの当選者を抽選したり、景品やくじの番号を抽選したりするとき、最も重要な基準は結果の公平性と予測不可能性です。画面上にランダムな数字が表示されていても、内部の実装に偏りがあったり、次の値を予測できたりすれば、抽選の信頼性は損なわれます。この記事では、JavaScriptの乱数生成方式がなぜ問題になるのか、そして偏りなく公平に抽選する方法を整理します。
まとめ
- ①
Math.random()は予測可能な疑似乱数(PRNG)であるため、景品や当選者の抽選のように公平性が重要な場面には適していません。- ②
crypto.getRandomValues()をベースにしたCSPRNGとFisher-Yatesシャッフル、リザバーサンプリングを組み合わせれば、偏りなく公平に抽選できます。- ③ 自分で実装するのが手間なら、当サイトの無料ツール「ランダム数字抽選ツール」でCSPRNGベースの公平な抽選をすぐに試せます。
なぜ乱数の生成方式が抽選結果を左右するのか
コンピューターは決められたアルゴリズムを実行する決定論的なシステムです。そのため、純粋なソフトウェアだけで完全な無作為の値を作ることはできず、乱数のように見える値を計算して生成する疑似乱数(Pseudo-Random Number)を使います。この計算方式によって、抽選の公平性が変わってきます。
Math.random()の限界
Math.random() は疑似乱数生成器(PRNG、Pseudo-Random Number Generator)に基づいて動作します。V8などのJavaScriptエンジンは、内部的に xorshift128+ または LCG(Linear Congruential Generator) 系のアルゴリズムを使用しています。
- シード(Seed)に基づく決定論: 初期シード値と内部状態が決まれば、その後に生成される数列は固定されます。
- 予測可能性: 乱数をいくつか連続して観察すると、以前の状態や次の値を数学的に再構成して予測できます。
- 不正のリスク: 景品抽選やイベント当選者の選出で、次のパターンを計算して当選率を高める不正が起こりえます。
誤ったシャッフルコードが生む偏り
名簿をランダムに並べ替えたり、重複なしでK個を抽出したりするときによく使われる array.sort(() => Math.random() - 0.5) というコードは、短い配列では問題なく動作するように見えますが、統計的な偏りを生みます。
N個の要素が取りうるすべての順列(Permutation)の総数はN!(Nの階乗)です。ところが、JavaScriptのソートアルゴリズム(QuickSort、Timsortなど)が無作為な比較関数を呼び出すときに生じる内部的な決定の組み合わせ数は、N^Nの形に近くなります。N^Nは多くの場合N!の整数倍にならないため、特定の順列が他の順列より頻繁に現れるという確率的な偏りが生じます。
偏りなく公平に抽選する方法
偏りをなくすには、(1) 予測不可能な乱数ソース、(2) すべての順列が同じ確率で出るシャッフルアルゴリズム、(3) 大量データでも安全な抽出手法、この3つを組み合わせて使う必要があります。以下では、自分で実装するときに必要になる原理とコードを紹介します。
1) crypto.getRandomValues() で予測不可能な乱数を作る
crypto.getRandomValues() は、暗号学的に安全な擬似乱数生成器(CSPRNG、Cryptographically Secure PRNG)を使います。
- エントロピー源: OS レベルで、マウスの動き、CPU 割り込みのタイムスタンプ、キーボード入力のノイズといった物理現象から乱数のエントロピーを集めます。
- 逆算不可能性: 過去に生成された乱数をすべて把握したとしても、次の値を予測したり内部シードを逆追跡したりするのは事実上不可能です。
- 公平性: 現金相当の景品、当選者抽選、暗号鍵の生成など、信頼性が重要な場面では CSPRNG を使うべきです。
crypto.getRandomValues() で得た 32 ビット整数(0 ~ 2^32-1)を、欲しい範囲 [0, M-1] に変換するときに単純に % M(剰余演算)だけを適用すると、剰余による偏りが生じます。2^32 が M の倍数でない限り、前のほうの数が選ばれる確率がわずかに高くなるからです。これをなくすには、棄却サンプリング(Rejection Sampling)方式で限界値を求めます。
Rejection Limit = 2^32 − (2^32 mod M)
取り出した乱数 R がこの限界値以上なら、その値を捨てて選び直します。こうすると均等な確率分布になります。
2) Fisher-Yates シャッフルですべての順列を同じ確率にする
Fisher-Yates シャッフル(Durstenfeld 変形)は、配列の後ろ側(N-1)から始めて、まだ確定していない前側の領域(0~i)から無作為なインデックス j を選び、2つの位置を入れ替える方式です。
- 時間計算量: O(N)。配列を1回だけ走査します。
- 空間計算量: O(1)。追加の配列を使わず、その場でシャッフルします。
ある要素が位置 i に配置される確率を計算すると、この方式が均等である理由がわかります。
- 配列の最後の位置(N-1)に特定の要素が選ばれる確率は 1/N です。
- 最後から2番目の位置(N-2)に特定の要素が選ばれる確率は(前の段階で選ばれず、今回の段階で選ばれる確率なので)(1 − 1/N) × 1/(N-1) = (N-1)/N × 1/(N-1) = 1/N です。
- 一般化すると、k 番目の位置に特定の要素が選ばれる確率は (N-1)/N × (N-2)/(N-1) × … × (k-1)/k × 1/(k-1) = 1/N です。
つまり、どの要素もどの位置に配置される確率はちょうど 1/N で等しく、取り得るすべての N! 通りの順列が出る確率もそれぞれ 1/N! で均等であることがわかります。
3) リザーバーサンプリング(Reservoir Sampling)で大量データを処理する
1 から 100 万まで、のように広い範囲から重複なしで数個だけ選びたい場合や、全体の個数をあらかじめ把握できないストリームデータから K 個を抽選する必要がある場合、配列全体をメモリ上に作ってシャッフルする方法は効率的ではありません。そんなときはリザーバーサンプリングを使います。
サイズ K のリザーバー(Reservoir)配列を用意し、ストリームデータを1つずつ読みながら次のように処理します。以下で i は、コードと同じく 0 から始まるインデックスです。
- 最初の K 個の要素(インデックス 0~K-1)は条件なしでリザーバー配列に入れます。
- インデックス i(i が K 以上の場合)の要素が入力されたら、0 から i までの無作為な整数 j を生成します。
- j が K より小さければ、リザーバーの j 番目の要素を、現在のインデックス i の入力値で置き換えます。
全体のデータ個数が N 個のとき、最終段階が終わった後に特定の要素がリザーバーに残っている確率を計算してみます。ストリームに n 番目(1 から数える順番で、コードの 0 始まりのインデックスでは i = n − 1 に相当)に入ってきた要素が最後までリザーバーに残る確率は次のとおりです。
P(当選) = K/n × (1 − 1/(n+1)) × (1 − 1/(n+2)) × … × (1 − 1/N) = K/n × n/(n+1) × (n+1)/(n+2) × … × (N-1)/N = K/N
全体のデータサイズ N を事前に知らなくても、1回の走査(O(N))と O(K) 程度のメモリだけで、N 個から K 個を公平に非復元抽出できます。
実装コード: CSPRNG + Fisher-Yates + リザーバーサンプリング
以下のコードは、CSPRNG による剰余バイアスの除去、Fisher-Yates シャッフル、リザーバーサンプリングをすべて含んだ TypeScript の例です。
/**
 * CSPRNG による無作為な整数生成(剰余バイアスを除去)
 * @param min 最小値(含む)
 * @param max 最大値(含む)
 */
export function getRandomIntSecure(min: number, max: number): number {
  if (min > max) {
    throw new Error("min は max 以下である必要があります。");
  }
  const range = max - min + 1;
  if (range === 1) return min;

  const totalValues = 0x100000000; // 2^32
  const limit = totalValues - (totalValues % range);

  const array = new Uint32Array(1);
  let randomValue: number;

  do {
    crypto.getRandomValues(array);
    randomValue = array[0];
  } while (randomValue >= limit);

  return min + (randomValue % range);
}

/**
 * CSPRNG による Fisher-Yates 重複なしの無作為抽出(K個)
 * @param array 元の応募者/数値の配列
 * @param k 抽出する当選者数(未指定なら全体をシャッフル)
 */
export function pickRandomItems<T>(array: T[], k?: number): T[] {
  const result = [...array];
  const count = k !== undefined ? Math.min(k, result.length) : result.length;

  for (let i = result.length - 1; i > result.length - 1 - count; i--) {
    const j = getRandomIntSecure(0, i);
    [result[i], result[j]] = [result[j], result[i]];
  }

  return result.slice(result.length - count);
}

/**
 * 大量範囲/ストリームデータのリザーバーサンプリング(Reservoir Sampling)
 * @param min 範囲の開始値
 * @param max 範囲の終了値
 * @param k 抽選する当選者数
 */
export function reservoirSampleRange(min: number, max: number, k: number): number[] {
  const total = max - min + 1;
  const sampleCount = Math.min(k, total);
  const reservoir: number[] = [];

  // 1. 最初の K 個でリザーバーを満たす
  for (let i = 0; i < sampleCount; i++) {
    reservoir.push(min + i);
  }

  // 2. i 番目の要素を無作為に差し替えるか判定
  for (let i = sampleCount; i < total; i++) {
    const currentValue = min + i;
    const j = getRandomIntSecure(0, i);
    if (j < sampleCount) {
      reservoir[j] = currentValue;
    }
  }

  return reservoir;
}
抽選結果が公平かどうかを検証する: カイ二乗適合度検定
抽選ツールが特定の番号や参加者に偏っていないかを確認するには、統計的な検定を使えます。合計 N 回の抽選実験で生成された K 個のカテゴリについて、実際の観測度数を Oᵢ、理論上の期待度数を Eᵢ = N/K とすると、カイ二乗統計量 χ² は次のように定義されます。
χ² = Σ(i=1からKまで) (Oᵢ − Eᵢ)² / Eᵢ
- 帰無仮説(H₀): 乱数抽出手法は偏りなく均等な確率分布に従うという仮定です。
- 自由度(df): K − 1
- 判定基準: 計算された χ² 統計量が、有意水準(α = 0.05)のカイ二乗臨界値より小さければ、その抽選器は統計的に偏りがないと判断します。
こうした統計検定を自分で実装して毎回確認するのは手間のかかる作業です。以下の抽選ツールは、すでに CSPRNG による剰余バイアスの除去と Fisher-Yates シャッフルを適用してあるので、別途検証コードを書かなくても偏りのない結果をすぐに得られます。
無料・暗号論的乱数ベース・重複なしの公平な抽選
Math.random()とcrypto.getRandomValues()の比較
| 項目 | Math.random() | crypto.getRandomValues() |
|---|---|---|
| 生成方式 | 疑似乱数(PRNG) | 暗号論的疑似乱数(CSPRNG) |
| 予測可能性 | 以前の値から次の値を推測できる | 逆算は事実上不可能 |
| シードの供給源 | 内部アルゴリズムの状態 | OSレベルの物理エントロピー |
| 適した用途 | ゲームの演出、単純なランダム効果 | 景品・当選者の抽選、暗号鍵の生成 |
実務で公平性を確保する方法
アルゴリズムと同じくらい、運用プロセスの透明性も重要です。
- 事前のシード・ハッシュの公開: 抽選前に参加者名簿のSHA-256ハッシュ値やシード値を公式の掲示板で公開しておけば、抽選後に誰でも同じ結果を再現して確認できます。
- 画面録画とログの保存: 名簿の入力から抽選ボタンのクリック、結果画面までを録画し、抽出した乱数の値と時刻のログを保存して、必要に応じて提出します。
- 重複データの整理: 同一人物の重複応募(電話番号、メールアドレス、アカウントID)を抽選前に1件にまとめます。
- クライアント側のツールの活用: サーバー側で操作される可能性を減らすため、ブラウザ上で
crypto.getRandomValues()を直接実行するクライアント側の抽選ツールを使うのがおすすめです。
まとめ
公平な抽選のためには、予測可能なMath.random()ではなくcrypto.getRandomValues()ベースのCSPRNGを使い、array.sort()方式ではなくFisher-Yatesシャッフルで順列を作る必要があります。大容量のデータでは、リザーバーサンプリングを使えばメモリの負担を抑えて抽出できます。また、カイ二乗検定で結果の均一性を確認できます。自分で実装せずに公平な抽選結果をすぐに確認したい場合は、下のツールを試してみてください。
無料・暗号論的乱数ベース・重複なしの公平な抽選
よくある質問
Q1. Math.random()で選んだ当選者に法的な問題は生じますか?
小規模な社内イベントや、単に楽しむための抽選であれば、Math.random()を使っても問題になる可能性は低いです。ただし、高額な金券性の景品や公共機関・企業の公式イベントでは、乱数の予測可能性や偏りへの指摘を減らすため、CSPRNGベースの乱数アルゴリズムを使うのがよいでしょう。
Q2. 1等から選ぶのと5等から選ぶのでは、当選確率に違いがありますか?
Fisher-Yatesアルゴリズムのような一様無作為シャッフルを使えば、抽選の順序にかかわらず、すべての応募者の当選確率は同じです。ただし、イベントの進行としては、下位の等賞から発表したほうが盛り上がりやすいという利点があります。
Q3. 重複あり(復元抽出)と重複なし(非復元抽出)は、どう使い分けますか?
ロトの番号生成や景品の当選者選びのように、一度選ばれた番号や人がもう一度選ばれてはいけない場合は、非復元抽出(重複なし)を使います。サイコロを振るように毎回同じ確率を保つ必要がある場合は、復元抽出(重複あり)を使います。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む