
Sorteo aleatorio sin repetición: CSPRNG y Fisher-Yates
Contenido
Cuando sorteas ganadores de un evento o extraes números de premios y lotería, los criterios más importantes son la imparcialidad y la imprevisibilidad del resultado. Aunque en la pantalla parezca que aparecen números aleatorios, si la implementación interna tiene sesgos o permite predecir el siguiente valor, la credibilidad del sorteo se derrumba. En este artículo explicamos por qué el método de generación de números aleatorios de JavaScript resulta problemático y cómo sortear de forma imparcial y sin sesgos.
Resumen
- ①
Math.random()es un generador pseudoaleatorio (PRNG) predecible, así que no es adecuado para sorteos de premios o de ganadores donde la imparcialidad es lo más importante.- ② Si combinas un CSPRNG basado en
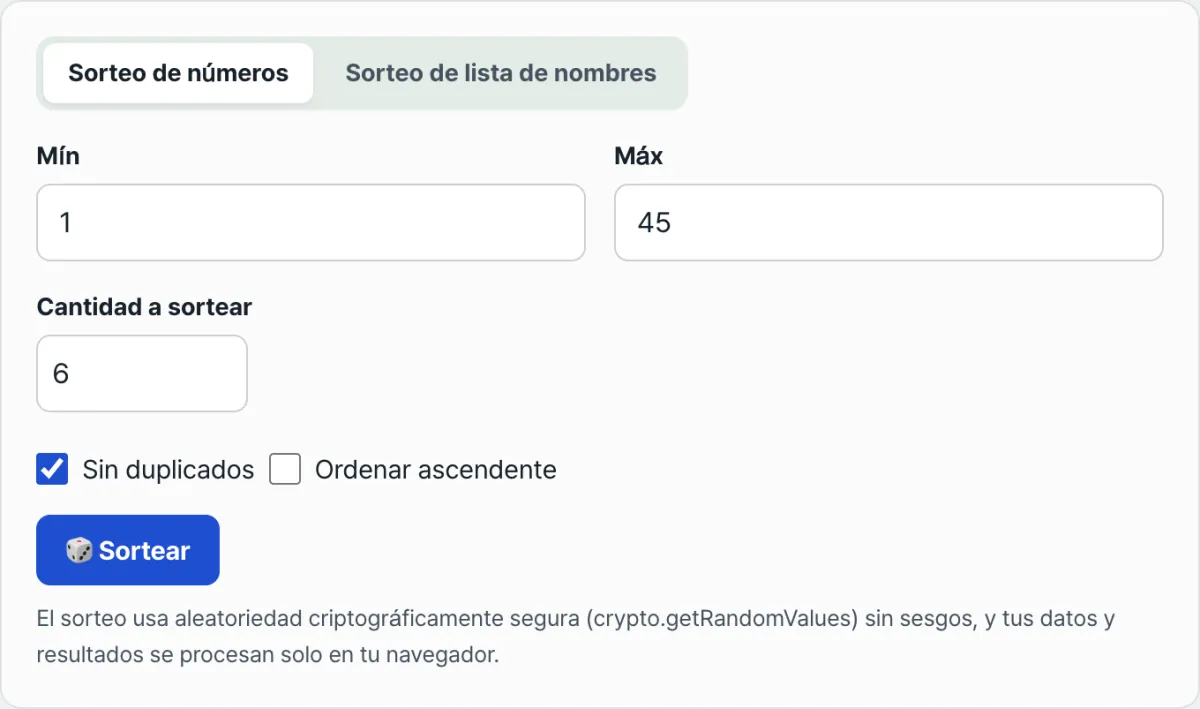
crypto.getRandomValues()con el barajado de Fisher-Yates y el muestreo por reservorio, puedes sortear de forma imparcial y sin sesgos.- ③ Si te resulta engorroso implementarlo por tu cuenta, puedes usar directamente el sorteo imparcial basado en CSPRNG de nuestra herramienta gratuita, "Sorteo de números aleatorios".
¿Por qué el método de generación de números aleatorios determina el resultado del sorteo?
Un ordenador es un sistema determinista que ejecuta algoritmos definidos. Por eso, el software por sí solo no puede producir valores totalmente aleatorios y recurre a números pseudoaleatorios (Pseudo-Random Number), es decir, valores que se calculan y que solo parecen aleatorios. Según cómo se haga ese cálculo, la imparcialidad del sorteo cambia.
Las limitaciones de Math.random()
Math.random() funciona sobre un generador de números pseudoaleatorios (PRNG, Pseudo-Random Number Generator). Los motores de JavaScript como V8 utilizan internamente algoritmos de la familia xorshift128+ o LCG (Linear Congruential Generator).
- Determinismo basado en la semilla (Seed): una vez fijados el valor inicial de la semilla y el estado interno, la secuencia que se genera después queda fija.
- Previsibilidad: si observas varios números aleatorios consecutivos, puedes reconstruir matemáticamente el estado anterior o el siguiente valor y predecirlo.
- Riesgo de manipulación: en el sorteo de premios o en la elección de ganadores de un evento, alguien podría calcular el siguiente patrón para aumentar su probabilidad de ganar y cometer fraude.
El sesgo que genera un código de barajado incorrecto
El código array.sort(() => Math.random() - 0.5), que se usa a menudo para mezclar una lista al azar o extraer K elementos sin repetición, parece funcionar sin problemas en arrays cortos, pero genera un sesgo estadístico.
El número de permutaciones posibles de N elementos es N! (N factorial). Sin embargo, el número de casos de decisión internos que se producen cuando el algoritmo de ordenación de JavaScript (QuickSort, Timsort, etc.) llama a una función de comparación aleatoria se acerca más a la forma N^N. Como N^N casi nunca es un múltiplo entero de N!, algunas permutaciones aparecen con más frecuencia que otras, lo que produce un desequilibrio probabilístico.
Cómo sortear de forma justa y sin sesgos
Para eliminar los sesgos tienes que combinar tres cosas: (1) una fuente de números aleatorios impredecible, (2) un algoritmo de shuffle en el que todas las permutaciones tengan exactamente la misma probabilidad y (3) un método de extracción que siga siendo seguro incluso con grandes volúmenes de datos. A continuación tienes los principios y el código que necesitas para implementarlo por tu cuenta.
1) Crear números aleatorios impredecibles con crypto.getRandomValues()
crypto.getRandomValues() utiliza un generador de números pseudoaleatorios criptográficamente seguro (CSPRNG, Cryptographically Secure PRNG).
- Fuente de entropía: el propio sistema operativo recoge entropía de fenómenos físicos como el movimiento del ratón, las marcas de tiempo de las interrupciones de la CPU o el ruido de las pulsaciones del teclado.
- Irreversibilidad: aunque conozcas todos los números generados en el pasado, en la práctica resulta imposible predecir el siguiente valor o reconstruir la semilla interna.
- Justicia: allí donde la fiabilidad es crítica —premios en metálico, sorteos de ganadores, generación de claves criptográficas— hay que usar un CSPRNG.
Cuando conviertes un entero de 32 bits obtenido con crypto.getRandomValues() (de 0 a 2^32-1) al rango que te interesa, [0, M-1], aplicar solo % M (la operación módulo) provoca un sesgo de módulo. La razón es que, salvo que 2^32 sea múltiplo de M, los primeros números tienen una probabilidad ligeramente mayor de salir. Para eliminarlo se calcula un límite mediante muestreo por rechazo (Rejection Sampling).
Límite de rechazo = 2^32 − (2^32 mod M)
Si el número aleatorio R extraído es igual o mayor que ese límite, se descarta y se vuelve a extraer. De este modo se consigue una distribución de probabilidad uniforme.
2) Conseguir que todas las permutaciones tengan la misma probabilidad con el shuffle de Fisher-Yates
El shuffle de Fisher-Yates (variante de Durstenfeld) empieza por el final del array (N-1) y, en cada paso, elige un índice aleatorio j dentro de la zona que aún no está fijada (0~i) e intercambia ambas posiciones.
- Complejidad temporal: O(N), recorre el array una sola vez.
- Complejidad espacial: O(1), mezcla in situ sin arrays adicionales.
Si calculas la probabilidad de que un elemento concreto acabe en la posición i, verás por qué este método es uniforme.
- La probabilidad de que un elemento concreto salga en la última posición del array (N-1) es 1/N.
- La probabilidad de que un elemento concreto salga en la penúltima posición (N-2) es (1 − 1/N) × 1/(N-1) = (N-1)/N × 1/(N-1) = 1/N, porque tiene que no haber salido en el paso anterior y salir en este.
- Generalizando, la probabilidad de que un elemento concreto salga en la k-ésima posición es (N-1)/N × (N-2)/(N-1) × … × (k-1)/k × 1/(k-1) = 1/N.
Es decir, todos los elementos tienen exactamente la misma probabilidad, 1/N, de ocupar cualquier posición, y las N! permutaciones posibles también son equiprobables: cada una sale con probabilidad 1/N!.
3) Trabajar con grandes volúmenes de datos mediante muestreo por reservorio (Reservoir Sampling)
Cuando necesitas extraer solo unos pocos elementos sin repetición de un rango enorme, como de 1 a 1.000.000, o elegir K elementos de un flujo de datos cuyo total no conoces de antemano, crear el array completo en memoria y mezclarlo resulta ineficiente. En esos casos se usa el muestreo por reservorio.
Preparas un array reservorio de tamaño K y vas leyendo el flujo de datos elemento a elemento del siguiente modo. Aquí i es un índice que empieza en 0, igual que en el código.
- Los primeros K elementos (índices 0~K-1) se copian al array reservorio sin ninguna condición.
- Cuando llega un elemento con índice i (siendo i mayor o igual que K), se genera un entero aleatorio j entre 0 e i.
- Si j es menor que K, se sustituye el elemento j-ésimo del reservorio por el valor de entrada del índice i actual.
Veamos ahora la probabilidad de que un elemento concreto siga en el reservorio una vez terminado el proceso, cuando el total de datos es N. La probabilidad de que el elemento que entró en la posición n del flujo (contando desde 1; con índices basados en 0, como en el código, corresponde a i = n − 1) permanezca en el reservorio hasta el final es la siguiente.
P(ganar) = K/n × (1 − 1/(n+1)) × (1 − 1/(n+2)) × … × (1 − 1/N) = K/n × n/(n+1) × (n+1)/(n+2) × … × (N-1)/N = K/N
Así, sin conocer de antemano el tamaño total N de los datos, puedes extraer K de N sin reemplazo y de forma justa con un solo recorrido (O(N)) y un uso de memoria del orden de O(K).
Código de implementación: CSPRNG + Fisher-Yates + muestreo por reservorio
El siguiente código es un ejemplo en TypeScript que incluye la eliminación del sesgo de módulo sobre CSPRNG, el shuffle de Fisher-Yates y el muestreo por reservorio.
/**
 * Genera un entero aleatorio basado en CSPRNG (sin sesgo de módulo)
 * @param min valor mínimo (incluido)
 * @param max valor máximo (incluido)
 */
export function getRandomIntSecure(min: number, max: number): number {
  if (min > max) {
    throw new Error("min은 max보다 작거나 같아야 합니다.");
  }
  const range = max - min + 1;
  if (range === 1) return min;

  const totalValues = 0x100000000; // 2^32
  const limit = totalValues - (totalValues % range);

  const array = new Uint32Array(1);
  let randomValue: number;

  do {
    crypto.getRandomValues(array);
    randomValue = array[0];
  } while (randomValue >= limit);

  return min + (randomValue % range);
}

/**
 * Extracción aleatoria sin repetición de K elementos con Fisher-Yates basado en CSPRNG
 * @param array array original de participantes/números
 * @param k número de ganadores a extraer (si no se indica, se mezcla todo)
 */
export function pickRandomItems<T>(array: T[], k?: number): T[] {
  const result = [...array];
  const count = k !== undefined ? Math.min(k, result.length) : result.length;

  for (let i = result.length - 1; i > result.length - 1 - count; i--) {
    const j = getRandomIntSecure(0, i);
    [result[i], result[j]] = [result[j], result[i]];
  }

  return result.slice(result.length - count);
}

/**
 * Muestreo por reservorio (Reservoir Sampling) para rangos o flujos de datos grandes
 * @param min valor inicial del rango
 * @param max valor final del rango
 * @param k número de ganadores a extraer
 */
export function reservoirSampleRange(min: number, max: number, k: number): number[] {
  const total = max - min + 1;
  const sampleCount = Math.min(k, total);
  const reservoir: number[] = [];

  // 1. Rellenar el reservorio con los K primeros elementos
  for (let i = 0; i < sampleCount; i++) {
    reservoir.push(min + i);
  }

  // 2. Decidir el reemplazo aleatorio del elemento i-ésimo
  for (let i = sampleCount; i < total; i++) {
    const currentValue = min + i;
    const j = getRandomIntSecure(0, i);
    if (j < sampleCount) {
      reservoir[j] = currentValue;
    }
  }

  return reservoir;
}
Comprobar si el resultado del sorteo es justo: prueba de bondad de ajuste chi-cuadrado
Para saber si una herramienta de sorteo se inclina por un número o un participante concreto puedes recurrir a una prueba estadística. Si en un experimento de N extracciones tienes K categorías, con una frecuencia observada Oᵢ y una frecuencia teórica esperada Eᵢ = N/K, el estadístico chi-cuadrado χ² se define así.
χ² = Σ(desde i = 1 hasta K) (Oᵢ − Eᵢ)² / Eᵢ
- Hipótesis nula (H₀): el algoritmo de extracción sigue una distribución de probabilidad uniforme, sin sesgos.
- Grados de libertad (gl): K − 1
- Criterio de decisión: si el estadístico χ² calculado es menor que el valor crítico de chi-cuadrado para un nivel de significación α = 0.05, se considera que ese sorteo no presenta sesgo desde el punto de vista estadístico.
Implementar estas pruebas por tu cuenta y comprobarlas cada vez es un trabajo engorroso. La herramienta Sorteo de números aleatorios que tienes más abajo ya aplica la eliminación del sesgo de módulo sobre CSPRNG y el shuffle de Fisher-Yates, así que obtienes resultados sin sesgo sin necesidad de escribir código de verificación aparte.
Gratis · Basado en números aleatorios criptográficos · Sorteo justo sin repetición
Comparación entre Math.random() y crypto.getRandomValues()
| Aspecto | Math.random() | crypto.getRandomValues() |
|---|---|---|
| Método de generación | Números pseudoaleatorios (PRNG) | Números pseudoaleatorios criptográficos (CSPRNG) |
| Previsibilidad | Es posible estimar el siguiente valor a partir de los anteriores | La ingeniería inversa es prácticamente imposible |
| Fuente de la semilla | Estado interno del algoritmo | Entropía física a nivel del sistema operativo |
| Usos adecuados | Efectos para juegos, efectos aleatorios simples | Sorteos de premios y ganadores, generación de claves criptográficas |
Cómo garantizar la imparcialidad en la práctica
La transparencia del proceso operativo es tan importante como el algoritmo.
- Anuncia de antemano la semilla o el hash: si publicas en el canal oficial el valor hash SHA-256 o la semilla de la lista de participantes antes del sorteo, después cualquiera podrá reproducir y verificar el mismo resultado.
- Graba la pantalla y conserva los registros: graba desde la introducción de la lista hasta el clic en el botón de sorteo y la pantalla de resultados, y conserva los valores aleatorios extraídos y los registros con la hora para presentarlos cuando sea necesario.
- Limpia los datos duplicados: antes del sorteo, consolida en un solo registro las participaciones duplicadas de una misma persona (teléfono, correo electrónico, ID de cuenta).
- Usa herramientas que se ejecuten en el cliente: para reducir la posibilidad de manipulación en el servidor, conviene usar una herramienta de sorteo que se ejecute en el cliente y llame directamente a
crypto.getRandomValues()en el navegador.
En resumen
Para que un sorteo sea justo, en lugar de usar el predecible Math.random(), utiliza un CSPRNG basado en crypto.getRandomValues() y genera la permutación con el algoritmo de Fisher-Yates, no con array.sort(). Con conjuntos de datos grandes puedes extraer elementos sin cargar la memoria mediante el muestreo por reservorio, y comprobar la uniformidad de los resultados con una prueba de chi-cuadrado. Si prefieres no implementarlo por tu cuenta y quieres obtener directamente un resultado justo, puedes usar la herramienta que encontrarás a continuación.
Gratis · Basado en números aleatorios criptográficos · Sorteo justo sin repetición
Preguntas frecuentes
Q1. ¿Puede haber problemas legales si el ganador se elige con Math.random()?
En sorteos internos de pequeña escala o que son solo por diversión, es poco probable que usar Math.random() suponga un problema. Sin embargo, en premios de alto valor canjeables por dinero o en eventos oficiales de organismos públicos o empresas, conviene usar un algoritmo aleatorio basado en CSPRNG para reducir las sospechas de previsibilidad y sesgo.
Q2. ¿Cambian las probabilidades de ganar si se sortea empezando por el primer premio o por el quinto?
Si se usa una mezcla aleatoria uniforme como la del algoritmo de Fisher-Yates, todos los participantes tienen la misma probabilidad de ganar, independientemente del orden de extracción. Eso sí, de cara al desarrollo del evento, anunciar primero los premios menores ayuda a generar interés.
Q3. ¿Cuándo conviene usar el muestreo con reemplazo (se permite repetir) y cuándo el muestreo sin reemplazo (no se permite repetir)?
Cuando un número o una persona que ya ha salido no puede volver a salir, como al generar números de lotería o elegir ganadores de premios, se usa el muestreo sin reemplazo (sin repetición). Cuando hay que mantener la misma probabilidad en cada intento, como al lanzar un dado, se usa el muestreo con reemplazo (con repetición).
Este artículo está adaptado de nuestro original en coreano. Leer el original en coreano