
標準偏差計算機:平均・中央値が異なる理由と求め方
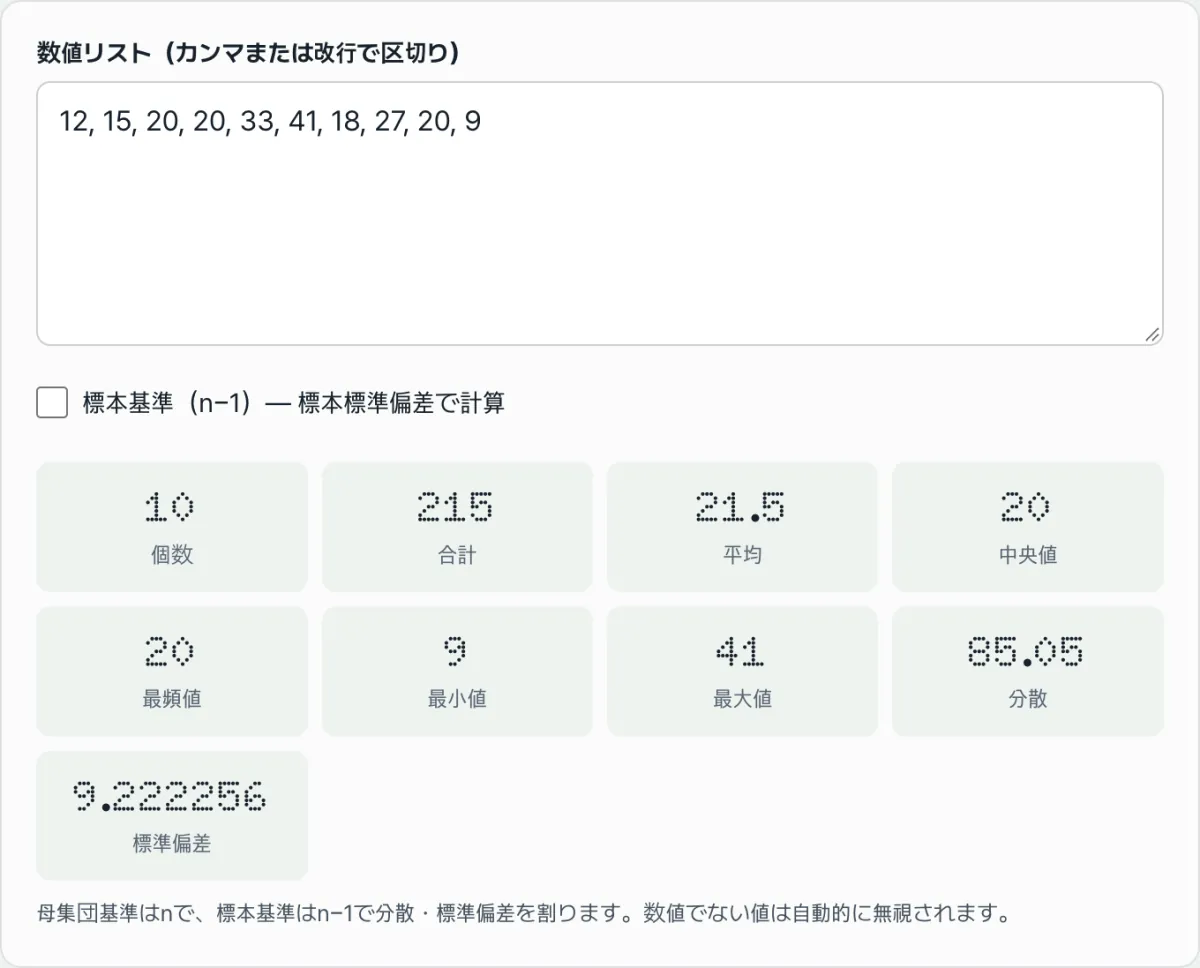
同じ数値リストでも、平均・中央値・最頻値は計算方法が異なるため、それぞれ違う値になることがあります。標準偏差も、割る数を n にするか n−1 にするかで値が変わります。成績やアンケートの回答、実験データを整理していて、こうした違いに戸惑った方のために、この記事では計算の過程を順番にたどりながら、なぜ違いが生まれるのかを見ていきます。
要約 ① 平均は合計を個数で割った値、中央値は並べ替えたときの真ん中の値、最頻値は最も多く登場した値です。計算方法そのものが違うため、同じデータでも異なる値になります。 ② 分散は、各値と平均との差(偏差)を2乗して足し合わせ、それを割った値です。標準偏差はその分散の平方根です。 ③ 偏差平方和を割る数が n(母集団基準)か n−1(標本基準)かによって、分散・標準偏差の値は変わります。n−1 で割った方が常に大きいか、等しくなります。
平均だけを見ると戸惑う場面
6人のチームで通勤時間をまとめ、「平均通勤時間は33分」と共有したとします。ところが、メンバーの多くから「自分はそれよりずっと短いんだけど?」と聞き返されました。
実際のデータは 15, 20, 20, 25, 30, 90(分)です。6人のうち5人は30分以内で、90分かかっているのは1人だけです。
平均はこの90分1つに大きく引っ張られて33.3分まで上がります。一方、並べ替えたときの真ん中の値である中央値や、最も多く出てきた値である最頻値は、その影響をそのまま受けるわけではありません。3つの値がどう違う計算で求められるのかを見ないまま「平均33分」という数字だけを見ても、このチームの通勤の実態を正しく読み取ることはできません。
ツールを使わず手計算する手順
上のデータ 15, 20, 20, 25, 30, 90(分)を最後まで手で計算すると、次の手順になります。
平均・中央値・最頻値を求める(ステップ1〜3)
ステップ1 — 個数・合計・平均。 個数は6個、合計は 15+20+20+25+30+90 = 200 です。平均は合計を個数で割った 200 ÷ 6 ≈ 33.33分になります。
ステップ2 — 並べ替えて中央値。 小さい順に並べると 15, 20, 20, 25, 30, 90 です。個数が6個(偶数)なので、真ん中の2つの値(3番目の20と4番目の25)の平均である (20+25) ÷ 2 = 22.5分が中央値です。個数が奇数なら、真ん中の値1つがそのまま中央値になります。
ステップ3 — 頻度を数えて最頻値。 各値の登場回数を数えると、20が2回で最も多いため、最頻値は20分です。すべての値が1回ずつしか登場しない場合、最頻値は「なし」として扱います。
偏差と分散を求める(ステップ4〜5)
ステップ4 — 偏差と偏差平方和。 各値から平均(33.33)を引いた偏差は、順に -18.33, -13.33, -13.33, -8.33, -3.33, 56.67 です。これを2乗してすべて足すと、偏差平方和は約3983.5になります。
ステップ5 — 分散。 偏差平方和を何で割るかによって、分散は分かれます。手元の6個の値そのものを全体(母集団)とみなす場合は、個数の6で割ります。この6個をより大きな全体から取り出した一部(標本)とみなす場合は、6から1を引いた5で割ります。
n(6)で割ると 3983.5 ÷ 6 ≈ 663.9、n−1(5)で割ると 3983.5 ÷ 5 ≈ 796.7 です。割る数が小さい n−1 の方が、分散は常に大きいか、等しくなります。
標準偏差を求める(ステップ6)
ステップ6 — 標準偏差。 標準偏差は分散の平方根です。母集団基準の標準偏差は √663.9 ≈ 25.77分、標本基準の標準偏差は √796.7 ≈ 28.23分です。
同じ計算を6つのステップで手作業で繰り返す代わりに、数値リストを貼り付けるだけで、同じ値をまとめて確認できます。「平均・標準偏差計算機」で確認してみてください。
数値リストを貼り付けると、個数・平均・中央値・最頻値・分散・標準偏差をブラウザ上ですぐに計算します。入力したデータはサーバーに送信されません。
混同しやすいポイント
平均・中央値・最頻値が異なる値になるのは、計算ミスではありません。 この3つは、そもそもデータを異なる方法で要約しています。平均はすべての値を足して個数で割るため、極端に大きい値や小さい値が1つあるだけで影響を受けます。中央値は並べ替えたうえで真ん中の位置を見るので、極端な値の大きさ自体には左右されません。最頻値は頻度だけを数えます。
最頻値が「なし」と表示されることもあります。 入力した値がすべて異なり、1回ずつしか登場しない場合は、最も多く出てきた値を1つに決められないためです。逆に、複数の値が同じ最高頻度を持つ場合は、それらの値がまとめて表示されます。
分散の単位は、元のデータの単位とは異なります。 偏差を2乗する過程で、単位も2乗されるためです(分単位のデータなら、分散の単位は「分²」にあたります)。標準偏差は、分散の平方根をとって元のデータと同じ単位に戻した値です。
n と n−1、どちらが大きいか
n と n−1 の違いを表にまとめると、次のようになります。
| 区分 | 分散の計算式 | 同じデータでの大きさ |
|---|---|---|
| 母集団基準(n) | 偏差平方和 ÷ n | 相対的に小さい |
| 標本基準(n−1) | 偏差平方和 ÷ (n−1) | 相対的に大きい |
数学的には、標本基準(n−1)の分散は、値が1個だけだと分母が0になり、定義されません。データの個数が1個のときは、この計算自体が成り立たないということです。
まとめ
- 平均は合計 ÷ 個数、中央値は並べ替えたときの真ん中の値(偶数個なら真ん中2つの値の平均)、最頻値は最も多く登場した値です。計算方法が異なるため、同じデータでも3つの値が異なることがあります。
- 分散は、各値と平均との差(偏差)を2乗して足し合わせ、それを割った値です。標準偏差はその平方根です。
- 割る数が n(母集団基準)か n−1(標本基準)かによって、分散・標準偏差の値は変わります。n−1 の方が常に大きいか、等しくなります。
- 極端な値が1つあると、平均は大きく動きますが、中央値・最頻値は比較的動きにくくなります。
- 計算は、個数・合計・並べ替え・頻度・偏差平方和の順に進みます。この順序どおりにたどれば、手計算でも検算できます。
数値リストを貼り付けると、個数・平均・中央値・最頻値・分散・標準偏差をブラウザ上ですぐに計算します。入力したデータはサーバーに送信されません。
よくある質問
母標準偏差と標本標準偏差は、計算式のどこが違いますか?
偏差平方和までの計算過程は同じです。違うのは、その値を割る数だけです。母集団基準では個数(n)で割り、標本基準では個数から1を引いた値(n−1)で割ります。割る数が小さい標本基準の方が、分散・標準偏差は常に大きいか、等しくなります。
最頻値が「なし」と表示されるのはなぜですか?
入力した数値がすべて異なり、1回ずつしか登場しない場合は、最も多く出てきた値を1つに決められないため、「なし」と表示されます。逆に、複数の値が同じ最高頻度を持つ場合は、それらの値がまとめて表示されます。
カンマと改行を混ぜて入力しても大丈夫ですか?
大丈夫です。入力したテキストは、空白とカンマを区切りとして分割され、それぞれ数値に変換されます。そのため、カンマ区切りでも改行区切りでも、混ぜて入力しても認識されます。数値に変換できない項目は、自動的に計算から除外されます。
入力した数値リストはサーバーに保存されますか?
保存されません。個数・平均・中央値・最頻値・分散・標準偏差の計算はすべてブラウザ内で即座に行われ、入力した数値リストがサーバーに送信されたり保存されたりすることはありません。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む