
Schimpfwortfilter: Text zensieren ohne Fehltreffer
Inhalt
- Teilübereinstimmung vs. exakte Übereinstimmung: der entscheidende Unterschied
- Grundsatz „Längstes Wort zuerst" (Greedy Matching)
- Die Technik dahinter: Aho-Corasick-Algorithmus und Trie
- Vier Filtermethoden im Vergleich
- Die 5 häufigsten Fehler bei der Umsetzung eines Schimpfwortfilters
- In 5 Schritten zur Maskierung ohne Fehltreffer
- 7 Praxistipps zum Schimpfwortfilter von Produktverantwortlichen
- Entscheidungshilfe: Welche Abgleichoption passt?
- Textzensur & String-Matching: die wichtigsten Begriffe im Überblick
- Häufig gestellte Fragen
Wer eine Online-Community, einen Spiele-Chat oder ein Bewertungsforum betreibt, braucht früher oder später einen Schimpfwortfilter, der Beleidigungen und Vulgärsprache automatisch unkenntlich macht.
Setzt man dafür jedoch einfache reguläre Ausdrücke oder simples Ersetzen ein, stößt man schnell auf zwei Probleme. Zum einen werden harmlose Wörter wie '시발점' (始發點, „Ausgangspunkt"), '개나리' („Forsythie") oder '바보온달' mit Sternchen (***) überdeckt. Dieses Phänomen heißt Überzensur oder Scunthorpe-Problem. Zum anderen erkennt der Filter Umgehungsversuche nicht, bei denen Punkte (.) oder Leerzeichen zwischen die Buchstaben eines Schimpfworts gesetzt werden.
Dieser Leitfaden erklärt den Unterschied zwischen Teilübereinstimmung und exakter Übereinstimmung (Wortgrenze \b), den Mehrmuster-Suchalgorithmus von Aho-Corasick und zeigt, wie Sie Text maskieren, ohne harmlose Wörter zu treffen.
Das Wichtigste in Kürze ① Reihenfolge beim Abgleich (nach Länge absteigend): Längere zusammengesetzte Wörter ('개새끼') müssen vor kürzeren Wörtern ('개') geprüft werden. Sonst wird das Wort zerstückelt und es bleibt ein Rest stehen. ② Teilübereinstimmung vs. exakte Übereinstimmung: Die Teilübereinstimmung überdeckt auch das '개' in '무지개'. Die exakte Übereinstimmung erfasst nur eigenständige Wörter und verringert so Fehltreffer. ③ Scunthorpe-Problem vermeiden: Damit Eigennamen und Fachbegriffe nicht fälschlich zensiert werden, sollten Sie zusätzlich eine Ausnahmeliste (Whitelist) führen. ④ 100 % clientseitig: Das Tool „Schimpfwortfilter: Text zensieren" sendet Ihren Text nicht an einen externen Server, sondern ersetzt per regulärem Ausdruck direkt im Browser in Echtzeit.
Teilübereinstimmung vs. exakte Übereinstimmung: der entscheidende Unterschied
Die wichtigste Einstellung bei einem Schimpfwortfilter ist der Geltungsbereich (Scope) des Abgleichs:
1. Teilübereinstimmung (Partial Match)
- Funktionsweise: Sobald eine gesperrte Zeichenfolge irgendwo im Satz vorkommt, wird sie erkannt und maskiert.
- Vorteil: Auch Schimpfwörter, die im Text versteckt sind, werden konsequent erfasst.
- Nachteil: Es kommt zu Fehltreffern (False Positives): Harmlose Wörter wie '개나리', '무지개' oder '시발점' werden zu '나리' oder '무지' verstümmelt.
2. Exakte Übereinstimmung (Exact / Whole Word Match)
- Funktionsweise: Erkannt wird nur, wenn das Wort als eigenständiges Wort dasteht, also vor und nach dem Wort Leerzeichen, Punkt, Komma oder ein anderes Satzzeichen steht. Technisch geschieht das über die Wortgrenze (
\b) im regulären Ausdruck. - Vorteil: Die Überzensur harmloser Wörter wird zuverlässig verhindert.
- Nachteil: Im Koreanischen hängen Partikeln direkt am Wort. Bei Formen wie '바보가' oder '바보를' kann der Filter das Wort daher übersehen.
Grundsatz „Längstes Wort zuerst" (Greedy Matching)
Enthält die Filterliste Wörter unterschiedlicher Länge (zum Beispiel '개' und '개새끼'), müssen Sie die Wörter nach Zeichenanzahl absteigend sortieren und in dieser Reihenfolge ersetzen.
Ersetzen Sie zuerst das kurze Wort '개', wird aus '개새끼' im Satz '***새끼'. Der eigentliche Kern des Schimpfworts bleibt dann unverändert sichtbar, ein gravierender Fehler.
Kostenlos · ohne Installation · Schimpfwörter in Sekunden automatisch erkennen und durch Sternchen ersetzen, einfach Text eingeben
Die Technik dahinter: Aho-Corasick-Algorithmus und Trie
Hier sehen wir uns den Algorithmus aus der Informatik an, der Tausende gesperrte Wörter in einer Millisekunde vollständig durchsucht.
1. Trie-Datenstruktur und Fehlerlinks (Failure Links)
- Bei einer Liste mit zehntausenden gesperrten Wörtern wächst die Zeitkomplexität auf O(N × K), wenn Sie für jedes Wort wiederholt String.replace() mit einem regulären Ausdruck aufrufen. Der Server kommt dadurch ins Stocken.
- Aho-Corasick-Algorithmus: Alle gesperrten Wörter werden in einem Trie (Präfixbaum) abgelegt und mit Fehlerlinks nach dem KMP-Prinzip (Knuth-Morris-Pratt) verbunden.
- Der Text wird nur ein einziges Mal durchlaufen. Mit linearer Zeitkomplexität O(N + M) werden so zehntausende Schimpfwörter in 0,001 Sekunden auf einmal gefunden.
2. Formel zur Normalisierung bei der Zerlegung koreanischer Silben (Jamo)
- Die Unicode-Formel zur Zerlegung einer Hangul-Silbe in Anlaut, Mittellaut und Endlaut: Zeichencode = 0xAC00 + (Anlaut × 588) + (Mittellaut × 28) + Endlaut
- Mischen Nutzer Ziffern unter, etwa bei 'ㅅ1ㅂㅏㄹ', lässt sich das ursprüngliche Schimpfwort durch Unicode-Normalisierung (NFKD) und das Entfernen störender Zeichen per regulärem Ausdruck (/[^가-힣a-zA-Z]/g) wiederherstellen und erkennen.
Vier Filtermethoden im Vergleich
| Filtermethode | Suchgeschwindigkeit | Fehltrefferquote (Scunthorpe-Problem) | Schutz vor Umgehungsversuchen | Empfohlenes Einsatzgebiet |
|---|---|---|---|---|
| Einfache Teilübereinstimmung (Standard) | Schnell | Sehr hoch (harmlose Wörter werden verstümmelt) | Gering (anfällig für Sonderzeichen) | Zensur einfacher Textnotizen |
| Wortgrenze (exakte Übereinstimmung) | Sehr schnell | Sehr niedrig (sicher) | Mittel (bei angehängten Partikeln lückenhaft) | Englischsprachige Texte, eigenständige Wörter |
| Aho-Corasick + Whitelist | Extrem schnell (O(N)) | Niedrig (mit gepflegter Ausnahmeliste) | Gut | Große Web-Communities, Spiele-Chats |
| KI-Kontextanalyse mit Deep Learning (LLM) | Langsam (rechenintensiv) | Praktisch 0 % (versteht den Kontext) | Sehr gut (deutet auch Szenesprache) | Anspruchsvoller Kundenservice, rechtliche Prüfung von Bewertungen |
Die 5 häufigsten Fehler bei der Umsetzung eines Schimpfwortfilters
- Kurze Wörter zuerst ersetzen: Wird '개' zuerst ersetzt, wird aus '개새끼' ➔ '***새끼'. Das Schimpfwort zerfällt und bleibt teilweise lesbar.
- Keine Whitelist (Ausnahmeliste) angelegt: Gewöhnliche koreanische Substantive wie '시발점', '개나리' oder '조카' werden maskiert.
- Normalisierung ohne Entfernen von Sonderzeichen und Leerzeichen: Wer Kommas oder Punkte zwischen die Buchstaben eines Schimpfworts setzt, umgeht den Filter.
- Partikeln im Koreanischen nicht berücksichtigt: Im Modus „Exakte Übereinstimmung" wird '바보' übersehen, sobald '는/을/를' daran hängt.
- Ersatzzeichen () in falscher Länge: Wird ein Schimpfwort mit 4 Zeichen durch nur einen Stern () ersetzt, geraten Satzrhythmus und Layout des Originals durcheinander.
In 5 Schritten zur Maskierung ohne Fehltreffer
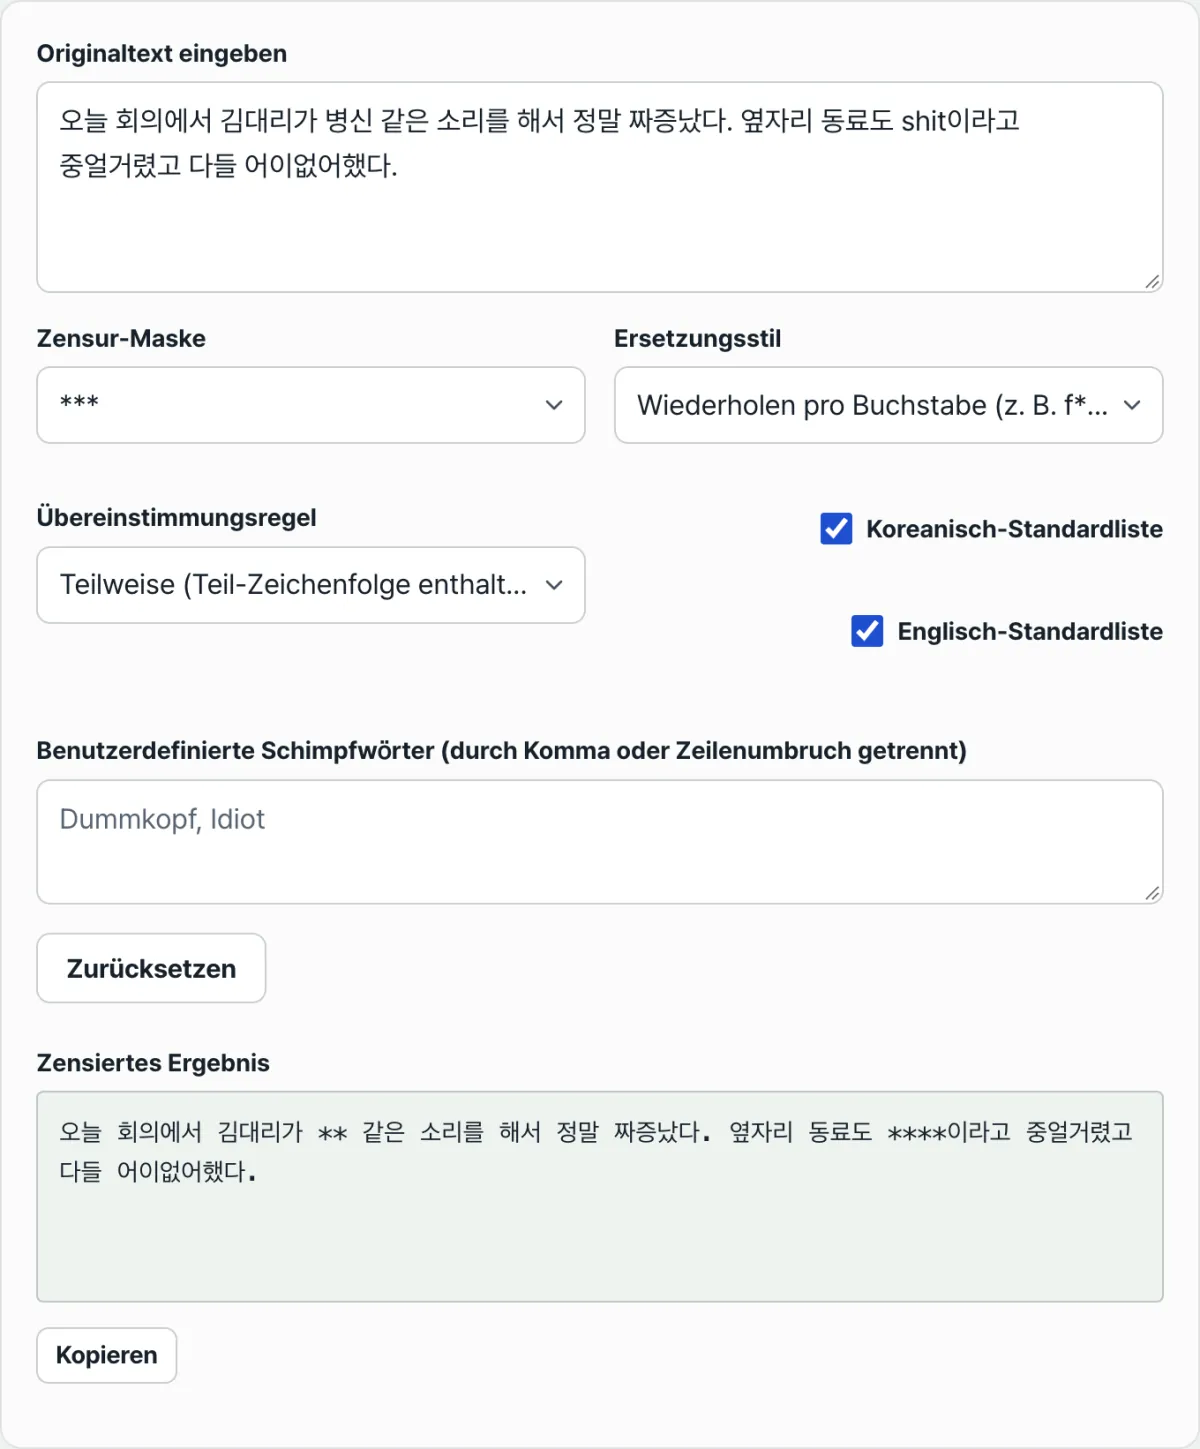
- Schritt 1 (Text eingeben): Fügen Sie Bewertungen, Kommentare oder Chatprotokolle in das Eingabefeld von „Schimpfwortfilter: Text zensieren" ein.
- Schritt 2 (Abgleichmodus wählen): Wählen Sie Teilübereinstimmung, wenn Sie streng sperren möchten, und exakte Übereinstimmung, wenn harmlose Wörter erhalten bleiben sollen.
- Schritt 3 (Eigene Sperrwörter ergänzen): Tragen Sie zusätzlich Schmähbegriffe ein, die zu Ihrem Angebot passen, oder markenspezifische Sperrwörter.
- Schritt 4 (Ersatzzeichen festlegen): Bestimmen Sie den gewünschten Maskierungsstil, zum Beispiel Sternchen (***), [CENSORED] oder Herzen (♥♥).
- Schritt 5 (Bereinigten Text mit einem Klick kopieren): Kopieren Sie den in einer Sekunde bereinigten Text und veröffentlichen Sie ihn in einer Ankündigung oder im Web.
7 Praxistipps zum Schimpfwortfilter von Produktverantwortlichen
- Maskierung in der Länge des Originalworts: Ersetzen Sie ein Schimpfwort mit 3 Zeichen durch '***' und eines mit 2 Zeichen durch '**'. So bleibt der Satzfluss natürlich.
- Normalisierung wiederholter Zeichen: Muster mit langgezogenen Vokalen wie '씨이이이발' komprimieren Sie mit dem regulären Ausdruck /(.)\1{2,}/g auf ein Zeichen und gleichen sie erst danach ab.
- Groß-/Kleinschreibung ignorieren (i-Flag): Um Schreibweisen wie 'fUcK' oder 'ShIt' zu erfassen, sollte das Flag für „Groß-/Kleinschreibung ignorieren" immer aktiv sein.
- Zuordnung von Zahlen-Ersetzungen (Leetspeak): Hinterlegen Sie ein Wörterbuch für Zahlen-Varianten, etwa '1' ➔ 'I/ㅣ', '0' ➔ 'O/ㅇ', '8' ➔ 'B'.
- Sperrliste regelmäßig aktualisieren: Beobachten Sie neue Wortschöpfungen und modische Beleidigungen und aktualisieren Sie die Liste einmal im Monat.
- Anbindung an eine Blacklist auf Basis von Meldungen: Wer den Filter umgeht, wird nach 3 Nutzermeldungen automatisch vorübergehend gesperrt.
- Dieses Tool als Lesezeichen speichern: Wenn Sie Beiträge aus Blogs oder Communities als Screenshot oder Zitat verwenden, entfernen Sie anstößige Schimpfwörter in einer Sekunde.
Entscheidungshilfe: Welche Abgleichoption passt?
- Fall A (Zitat per Blog-Screenshot, Aufbereitung von Beiträgen für Behörden) ➔ Teilübereinstimmung + Sternchen (***) (gründliche Bereinigung)
- Fall B (Casual-Community mit ungezwungenem Austausch) ➔ Exakte Übereinstimmung + Whitelist (möglichst wenige Scunthorpe-Fehltreffer)
- Fall C (Chat auf Kinder- oder Bildungsplattformen) ➔ Teilübereinstimmung + Normalisierung mit vollständigem Entfernen von Sonderzeichen und Leerzeichen
- Fall D (Live-Streaming-Chat mit hohem Datenaufkommen in Echtzeit) ➔ Hochperformantes C/WASM-Modul auf Basis von Aho-Corasick
Textzensur & String-Matching: die wichtigsten Begriffe im Überblick
- Scunthorpe-Problem: Ein Filter blockiert ein harmloses Wort, weil darin zufällig die Buchstabenfolge eines gesperrten Begriffs vorkommt.
- Wortgrenze (Word Boundary, \b): Ein Metazeichen in regulären Ausdrücken, das die Grenze zwischen Buchstaben (lateinisch oder koreanisch) und Leerzeichen oder Satzzeichen markiert.
- Aho-Corasick-Algorithmus: Ein endlicher Automat, der mehrere Suchmuster gleichzeitig in nur einem Durchlauf durch den Text findet.
- Maskierung (Masking): Verfahren, bei dem sensible Wörter oder personenbezogene Daten durch bestimmte Symbole (z. B. *, #) verdeckt werden.
Häufig gestellte Fragen
Warum wird das Wort „무지개“ zu „무지***“ zensiert?
Das liegt daran, dass die Option „Teilweise Übereinstimmung“ aktiviert ist und „개“ in der Sperrwortliste steht. In diesem Modus wird jeder Buchstabe verdeckt, der innerhalb eines Wortes vorkommt. Wenn Sie nur eigenständige Schimpfwörter zensieren möchten, wechseln Sie einfach zur Option „Exakte Übereinstimmung“.
Werden Schimpfwörter auch erkannt, wenn Sonderzeichen dazwischenstehen?
Ein einfacher Abgleich mit regulären Ausdrücken vergleicht zusammenhängende Zeichenfolgen. Um Schimpfwörter mit eingestreuten Sonderzeichen zu erfassen, empfiehlt sich eine zweite Prüfung: Dabei werden Leerzeichen und Sonderzeichen vor der Eingabe in den Text vorübergehend entfernt und erst dann wird geprüft.
Werden meine eingegebenen sensiblen Sätze an einen Server gesendet oder gespeichert?
Nein, auf keinen Fall. Alle Textersetzungen mit regulären Ausdrücken im Schimpfwortfilter „Text zensieren“ laufen lokal in der JavaScript-Engine Ihres Webbrowsers ab. Ihr Text wird zu keinem Zeitpunkt auf einem externen Server gespeichert.
Dieser Artikel basiert auf unserem koreanischen Original. Koreanisches Original lesen