
Filtro de palabrotas: enmascarar texto sin falsos positivos
Contenido
- Coincidencia parcial vs. coincidencia exacta: la diferencia decisiva en el criterio de búsqueda
- Principio de coincidencia de la palabra más larga primero (Greedy Matching)
- El mecanismo técnico clave: el algoritmo Aho-Corasick y el árbol Trie
- Comparativa de los 4 métodos de algoritmos de filtrado de palabrotas
- Los 5 errores habituales al implementar un filtro de palabrotas
- Flujo de trabajo práctico en 5 pasos para enmascarar palabrotas sin falsos positivos
- 7 consejos de filtrado de palabrotas que revela un planificador de producto
- Árbol de decisión final: ¿qué opción de coincidencia deberías usar?
- Chuleta de términos clave sobre censura de texto y coincidencia de cadenas
- Preguntas frecuentes
Cuando gestionas comunidades online, chats de videojuegos o tableros de reseñas de clientes, un sistema de filtrado de palabrotas que oculte de forma automática la avalancha de comentarios maliciosos y palabras malsonantes es imprescindible.
Sin embargo, si aplicas una simple expresión regular o una sustitución de palabras, acabas topándote con la sobrecensura (el problema de Scunthorpe): palabras perfectamente normales como «시발점» (punto de partida, 始發點), «개나리» (forsitia) o «바보온달» quedan tapadas con asteriscos (***). O, al contrario, te encuentras con el límite de no detectar en absoluto las palabrotas alteradas que meten un punto (.) o un espacio entre letra y letra.
Aquí tienes todo bien ordenado: la diferencia entre «coincidencia parcial» y «coincidencia exacta (límite de palabra \b)», que es la clave del filtrado de palabrotas, el algoritmo de búsqueda de múltiples patrones Aho-Corasick y el método de enmascarado de texto sin falsos positivos.
Resumen clave ① Prioridad de coincidencia (de mayor a menor número de caracteres): hay que buscar primero las palabras compuestas largas («개새끼») y no las cortas («개»), para evitar el error de que la palabra se parta y quede algo raro a la vista. ② Coincidencia parcial vs. coincidencia exacta: la parcial tapa incluso el «개» que hay dentro de «무지개» (arcoíris); la exacta solo tapa palabras independientes y reduce los falsos positivos. ③ Prevenir el problema de Scunthorpe: hay que combinar el filtro con una lista blanca (whitelist) de excepciones permitidas para que los nombres propios o los términos académicos normales no se censuren por error. ④ Seguridad 100 % en el cliente: esta herramienta no envía a ningún servidor externo el texto que introduces; hace la sustitución con expresiones regulares al instante dentro del navegador.
Coincidencia parcial vs. coincidencia exacta: la diferencia decisiva en el criterio de búsqueda
El ajuste más importante de un motor de filtrado de palabrotas es cómo defines el alcance (Scope) de la coincidencia:
1. Coincidencia parcial (Partial Match)
- Cómo funciona: si la cadena de la palabra prohibida aparece en cualquier parte de la frase, la detecta y la enmascara sin excepción.
- Ventajas: atrapa con rigor y sin dejar ninguna las palabrotas escondidas en el contexto.
- Desventajas: provoca falsos positivos (False Positive) y estropea palabras normales como «개나리», «무지개» o «시발점», que acaban como «나리» o «무지».
2. Coincidencia exacta (Exact / Whole Word Match)
- Cómo funciona: solo detecta cuando se trata de una palabra independiente, separada delante y detrás por espacios, puntos, comas u otra puntuación, usando el límite de palabra (\b) de la expresión regular.
- Ventajas: bloquea por completo la sobrecensura que tapa palabras normales sin motivo.
- Desventajas: como el coreano es una lengua aglutinante y las partículas se pegan directamente detrás de la palabra, puede no detectar casos como «바보가» o «바보를», donde la partícula va unida.
Principio de coincidencia de la palabra más larga primero (Greedy Matching)
Cuando en el diccionario del filtro hay palabras de distinta longitud (por ejemplo «개» y «개새끼»), debes ordenarlas de mayor a menor número de caracteres y sustituir primero las más largas.
Si sustituyes antes la palabra corta «개», el «개새끼» de la frase se convierte en «***새끼» y el insulto que queda detrás se muestra tal cual: un bug fatal.
Gratis · sin instalación · detecta y enmascara palabrotas con asteriscos en 1 segundo con solo pegar tu texto
El mecanismo técnico clave: el algoritmo Aho-Corasick y el árbol Trie
Analizamos el algoritmo de informática que rastrea de forma exhaustiva miles de palabras prohibidas a una velocidad extrema, en 1 milisegundo.
1. La estructura de datos Trie y los enlaces de fallo (Failure Link)
- Con una lista de decenas de miles de palabras prohibidas, si repites String.replace() con expresiones regulares para cada palabra, la complejidad temporal se dispara a O(N × K) y el servidor se cae.
- Algoritmo Aho-Corasick: construye todas las palabras prohibidas en un árbol Trie y conecta los enlaces de fallo de KMP (Knuth-Morris-Pratt).
- Con una complejidad temporal lineal O(N + M), recorre el cuerpo del texto una sola vez y busca en bloque decenas de miles de palabrotas en 0,001 segundos.
2. Fórmula de normalización por descomposición de jamo en Unicode coreano
- Fórmula de descomposición Unicode del coreano que separa inicial, media y final: Char Code = 0xAC00 + (inicial × 588) + (media × 28) + final
- Aunque el usuario escriba mezclando números, como «ㅅ1ㅂㅏㄹ», al pasar por la normalización Unicode (NFKD) y por la eliminación de espacios con la expresión regular (/[^가-힣a-zA-Z]/g), vuelve a la palabrota original y se puede detectar.
Comparativa de los 4 métodos de algoritmos de filtrado de palabrotas
| Método de filtrado | Velocidad de búsqueda | Tasa de falsos positivos (problema de Scunthorpe) | Bloqueo de evasiones con palabrotas alteradas | Campo de aplicación recomendado |
|---|---|---|---|---|
| Coincidencia parcial simple (básica) | Rápida | Muy alta (daña palabras normales) | Baja (vulnerable a caracteres especiales) | Censura de notas de texto simples |
| Límite de palabra (coincidencia exacta) | Muy rápida | Muy baja (segura) | Media (se escapa si va unida a una partícula) | Textos en inglés, palabras independientes |
| Aho-Corasick + lista blanca | Extremadamente rápida (O(N)) | Baja (gestión de un diccionario de excepciones) | Buena | Grandes comunidades web, chat de juegos |
| Análisis de contexto con IA de aprendizaje profundo (LLM) | Lenta (mucho cálculo) | Prácticamente 0 % (entiende el contexto) | Bloqueo perfecto (interpreta la jerga) | Atención al cliente de precisión, reseñas con implicaciones legales |
Los 5 errores habituales al implementar un filtro de palabrotas
- Sustituir primero la palabra corta: cambiar antes «개» hace que «개새끼» ➔ «***새끼», así que el insulto se rompe y queda a la vista.
- No construir una lista blanca (diccionario de excepciones): se enmascaran sustantivos del coreano puro como «시발점», «개나리» o «조카».
- Olvidar la normalización que elimina caracteres especiales y espacios: el filtro cae ante el truco de meter comas o puntos entre las letras de la palabrota.
- Manejo insuficiente de las partículas del coreano aglutinante: en el modo de coincidencia exacta se escapan los casos en que «바보» lleva «는/을/를» pegado detrás.
- Longitud del carácter de reemplazo desajustada: si cambias una palabrota de 4 letras por un solo asterisco (*), se rompen el ritmo y la maquetación de la frase original.
Flujo de trabajo práctico en 5 pasos para enmascarar palabrotas sin falsos positivos
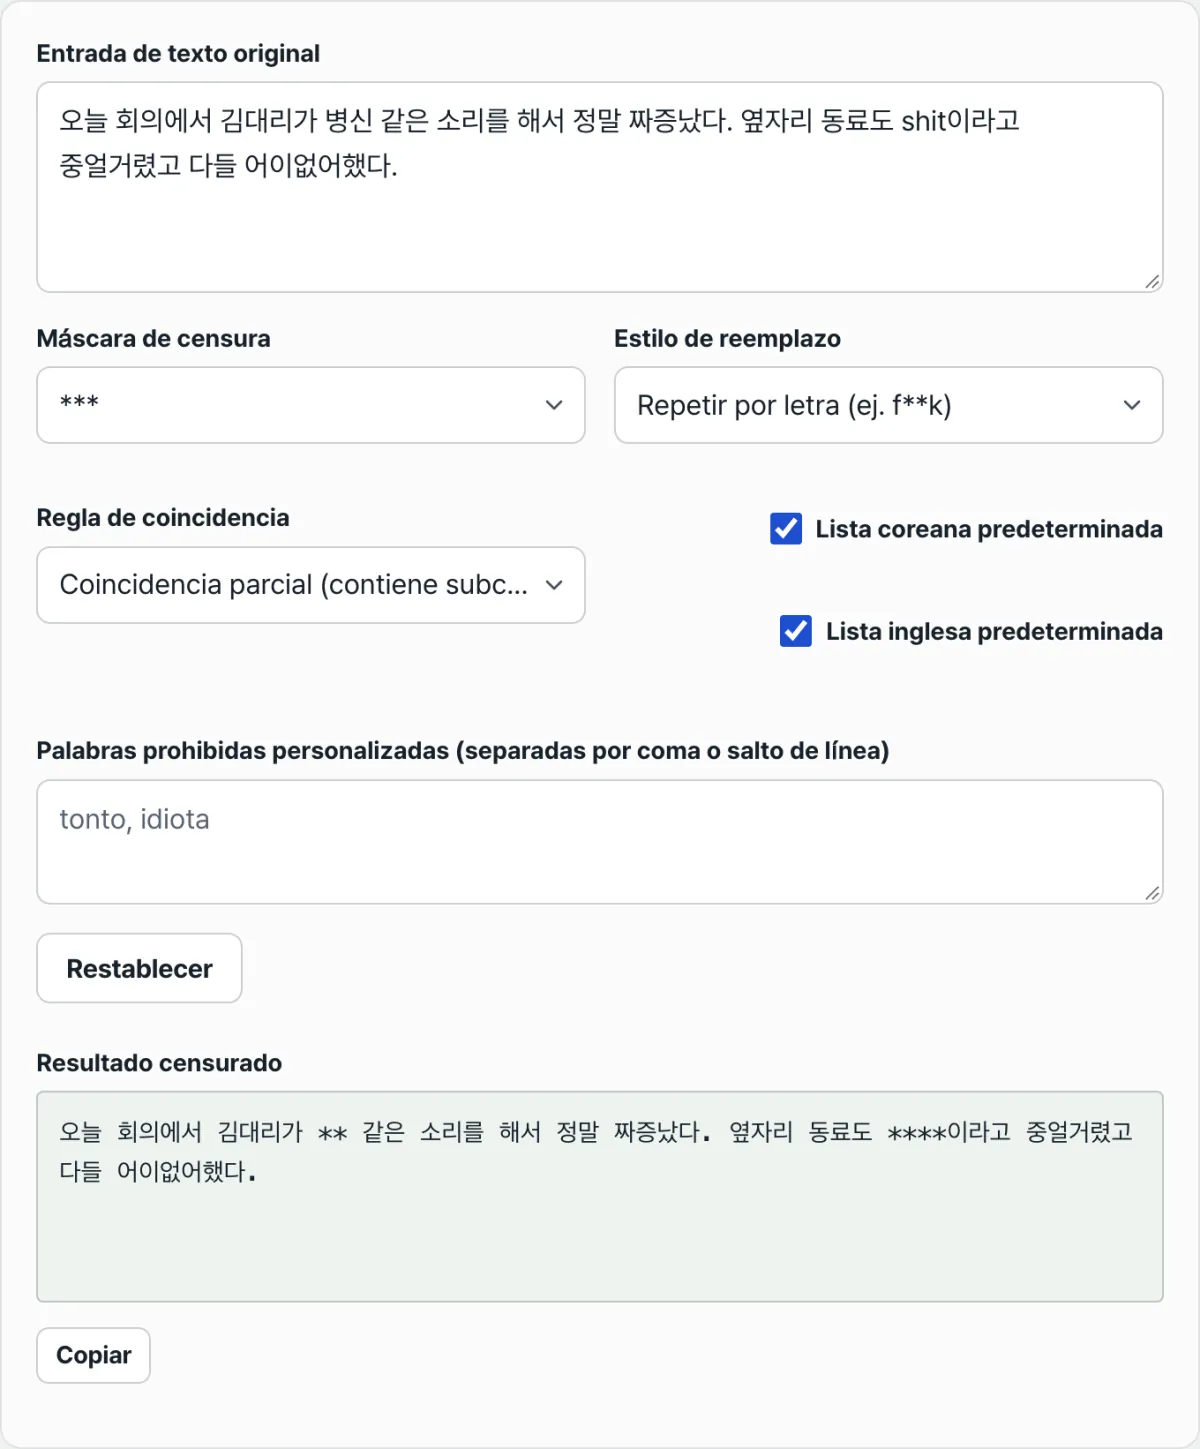
- Paso 1 (introducir el texto que quieres censurar): pega reseñas, comentarios o registros de chat en el campo de entrada de nuestra herramienta gratuita, Filtro de palabrotas y censura de texto.
- Paso 2 (elegir el criterio de coincidencia): si necesitas un bloqueo estricto, elige coincidencia parcial; si lo importante es conservar las palabras normales, elige coincidencia exacta.
- Paso 3 (añadir palabras prohibidas personalizadas): registra insultos concretos o palabras prohibidas propias de tu marca que encajen con la naturaleza de tu servicio.
- Paso 4 (configurar el símbolo de reemplazo): define el estilo de enmascarado que quieras, como asteriscos (***), [CENSORED] o corazones (♥♥).
- Paso 5 (copiar el texto limpio con un clic): en 1 segundo copias un texto seguro y bien limpio y lo publicas en los avisos o en la web.
7 consejos de filtrado de palabrotas que revela un planificador de producto
- Enmascarar con la misma longitud que el texto: sustituye una palabrota de 3 letras por «***» y una de 2 letras por «**» para que el ritmo de la frase quede natural.
- Normalizar comprimiendo caracteres repetidos: los patrones en que se alarga la vocal, como «씨이이이발», se comprimen a 1 carácter con la expresión regular /(.)\1{2,}/g y después se buscan.
- Ignorar mayúsculas y minúsculas (flag i): para atrapar palabrotas con mayúsculas mezcladas como «fUcK» o «ShIt», activa siempre el flag de ignorar mayúsculas y minúsculas.
- Mapear cadenas con sustitución por números (Leet): registra un diccionario de jerga transformada con números, como '1' ➔ 'I/ㅣ', '0' ➔ 'O/ㅇ', '8' ➔ 'B'.
- Actualizar el diccionario de palabras prohibidas con regularidad: monitoriza los neologismos y las expresiones despectivas de moda y renueva el diccionario una vez al mes.
- Vincular una lista negra basada en acumulación de reportes: a los usuarios que esquivan el filtro, aplícales una regla de bloqueo temporal automático al acumular 3 reportes.
- Añadir el Filtro de palabrotas y censura de texto a favoritos: cuando captures o cites publicaciones de blogs o comunidades, borra en 1 segundo las palabrotas delicadas.
Árbol de decisión final: ¿qué opción de coincidencia deberías usar?
- Situación A (citar capturas de blogs, limpiar publicaciones de organismos públicos) ➔ Coincidencia parcial + enmascarado con asteriscos (***) (limpieza a fondo)
- Situación B (una comunidad informal donde la comunicación libre es importante) ➔ Coincidencia exacta + lista blanca (mínimos falsos positivos de Scunthorpe)
- Situación C (chat de plataformas infantiles o educativas) ➔ Coincidencia parcial + normalización que elimina por completo caracteres especiales y espacios
- Situación D (chat de streaming en directo de gran volumen y en tiempo real) ➔ Aplicar un módulo C/WASM de altísima velocidad basado en Aho-Corasick
Chuleta de términos clave sobre censura de texto y coincidencia de cadenas
- Problema de Scunthorpe (Scunthorpe Problem): fenómeno por el cual un sistema bloquea palabras totalmente inocentes porque dentro de ellas aparecen las letras de una palabra prohibida.
- Límite de palabra (Word Boundary, \b): metacarácter de las expresiones regulares que marca el punto entre un carácter alfabético (latino o hangul) y un espacio o un signo de puntuación.
- Aho-Corasick: algoritmo de autómata finito que localiza varios patrones de texto a la vez con un solo recorrido del texto.
- Enmascarado (Masking): técnica que oculta palabras sensibles o datos personales con símbolos concretos (*, #, etc.).
Preguntas frecuentes
¿Por qué si escribo la palabra «무지개» (arcoíris) aparece como «무지***»?
Porque tienes activada la opción de «coincidencia parcial» y la palabra prohibida «개» está en la lista. Ese modo oculta también las letras que van dentro de una palabra, así que si solo quieres tapar los insultos que aparecen como palabra independiente, cambia a la opción «coincidencia exacta».
¿También se filtran automáticamente los insultos escritos con símbolos intercalados?
La coincidencia básica con expresiones regulares compara cadenas consecutivas, así que para detectar insultos con espacios o caracteres especiales intercalados conviene sumar una segunda verificación: quitar temporalmente los espacios y los caracteres especiales del texto antes de revisarlo.
¿El texto sensible que escribo se envía a un servidor o se guarda?
En absoluto. Todas las sustituciones con expresiones regulares de nuestra herramienta Filtro de palabrotas y censura de texto se ejecutan de forma local en el motor de JavaScript de tu navegador, así que el texto nunca se guarda en un servidor externo.
Este artículo está adaptado de nuestro original en coreano. Leer el original en coreano