
NGワードの伏字変換 誤検出を防ぐ判定の仕組み
目次
オンラインコミュニティやゲームのチャット欄、お客様のレビュー掲示板を運営していると、押し寄せる悪質なコメントや暴言を自動的に隠してくれる暴言フィルタリングシステムが欠かせません。
しかし単純な正規表現や単語置換を適用した結果、'시발점(始発点)'や'개나리(レンギョウ)'、'바보온달'のような正常な語彙までアスタリスク(***)で伏せてしまう過検閲(スカンソープ問題、Scunthorpe Problem)が起きたり、逆に暴言の間に点(.)や空白を挟んだ変則的な暴言をまったく検出できなかったりする限界に突き当たります。
暴言フィルタリングの核心である「部分一致」と「完全一致(単語境界 \b)」の違い、Aho-Corasick(アホ・コラシック)の複数パターン探索アルゴリズム、そして誤検知のないテキストマスキング処理の方法を徹底的に解説します。
要点まとめ ① マッチングの優先順位(文字数の降順): 短い単語('개')よりも長い複合語('개새끼')を先にマッチングさせることで、単語が分割されて不自然に残るエラーを防ぎます。 ② 部分一致 vs 完全一致: 「部分一致」は'무지개'の中の'개'まで伏せてしまい、「完全一致」は独立した単語だけを伏せるので誤検知を減らせます。 ③ スカンソープ問題の防止: 正常な固有名詞や学術用語が誤って検閲されないよう、例外許可ホワイトリスト(Whitelist)を併用する必要があります。 ④ 100% クライアントサイドのセキュリティ: 「NGワード・暴言フィルター(伏字変換)」は入力したテキストを外部サーバーに送信せず、ブラウザ内で即座にリアルタイムの正規表現置換を行います。
部分一致 vs 完全一致: マッチング基準の決定的な違い
暴言フィルターエンジンで最も重要な設定は、マッチングの範囲(Scope)をどう定義するかです。
1. 部分一致(Partial Match)
- 動作: 文中のどこに位置していても、禁止語の文字列が含まれていれば無条件に検出してマスキングします。
- メリット: 文脈に隠れた暴言を漏らさず、厳しく検出します。
- デメリット: '개나리'、'무지개'、'시발점'のような正常な単語まで'나리'、'무지'などのように損なう誤検知(False Positive)が発生します。
2. 完全一致(Exact / Whole Word Match)
- 動作: 前後が空白やピリオド、カンマなどの句読点で区切られた独立した単語のときだけ、正規表現の単語境界(\b)で検出します。
- メリット: 正常な語彙が不当に伏せられる過検閲を完全に防ぎます。
- デメリット: 単語の直後に助詞が付く韓国語の膠着語的な性質上、'바보가'や'바보를'のように助詞が付くと検出できない場合があります。
長い単語を優先するマッチング原則(Greedy Matching)
フィルタリング辞書に文字数の異なる単語が存在する場合(例:'개'と'개새끼')、必ず文字数の長い単語から降順に並べて先に置換する必要があります。
もし短い単語'개'を先に置換してしまうと、文中の'개새끼'が'***새끼'に変わり、後ろ側の暴言本体がそのまま露出する致命的なバグが発生します。
無料・インストール不要・テキストを入力するだけで、1秒で不適切な言葉を自動検出してアスタリスクで伏字にします
コア技術のメカニズム: Aho-CorasickとTrie木アルゴリズム
数千個の禁止語を1ミリ秒で超高速に全件探索するコンピュータサイエンスのアルゴリズムを分析します。
1. Trie(トライ)データ構造と失敗リンク(Failure Link)
- 数万件の禁止語リストがあるとき、単語ごとに正規表現のString.replace()を繰り返すと時間計算量がO(N × K)に膨れ上がり、サーバーが停止します。
- Aho-Corasickアルゴリズム: すべての禁止語をTrie木として構築し、KMP(Knuth-Morris-Pratt)の失敗リンクを接続します。
- テキスト本文をたった一度だけ走査するO(N + M)の線形時間計算量で、数万個の暴言を0.001秒で一括探索します。
2. ハングルのUnicode字母分離正規化の数式
- 初声・中声・終声を分離するハングルUnicodeの分解公式: Char Code = 0xAC00 + (initial × 588) + (medial × 28) + final
- ユーザーが'ㅅ1ㅂㅏㄹ'のように数字を混ぜて書いても、Unicode正規化(NFKD)と正規表現による空白除去(/[^가-힣a-zA-Z]/g)を経れば、元の原型の暴言に還元して検出できます。
暴言フィルタリングアルゴリズム4方式の比較
| フィルタリング方式 | 探索速度 | 誤検知率(スカンソープ問題) | 変則暴言の回避ブロック | 推奨される適用分野 |
|---|---|---|---|---|
| 単純な部分一致(基本) | 速い | 非常に高い(正常語を損なう) | 低い(特殊文字に弱い) | 単純なテキストメモの検閲 |
| 単語境界(完全一致) | 非常に速い | 非常に低い(安全) | 普通(助詞の結合時に漏れる) | 英語圏のテキスト、独立した単語 |
| Aho-Corasick + ホワイトリスト | 極めて速い(O(N)) | 低い(例外辞書で管理) | 優れている | 大規模なWebコミュニティ、ゲームチャット |
| ディープラーニングAIの文脈分析(LLM) | 遅い(演算量が多い) | 実質0%(文脈を理解) | 完全にブロック(隠語を解釈) | 精緻な顧客対応、法的レビュー |
暴言フィルタリング実装でよくある5つのミス
- 短い単語を先に置換: '개'を先に変えると'개새끼' ➔ '***새끼'となり、暴言が壊れて露出する。
- ホワイトリスト(例外辞書)の未整備: '시발점'、'개나리'、'조카'のような純粋な韓国語の名詞がマスキングされる。
- 特殊文字・空白の除去正規化の漏れ: 暴言の文字の間にカンマや点を打つ姑息な回避策を通してしまう。
- ハングル膠着語の助詞処理が不十分: 完全一致モードで'바보'の後に'는/을/를'が付いたときに見逃す現象。
- 代替文字()の長さの不一致: 4文字の暴言を1個のアスタリスク()に変えると、元の文の呼吸やレイアウトが崩れる。
誤検知のない暴言マスキング5ステップ実践ワークフロー
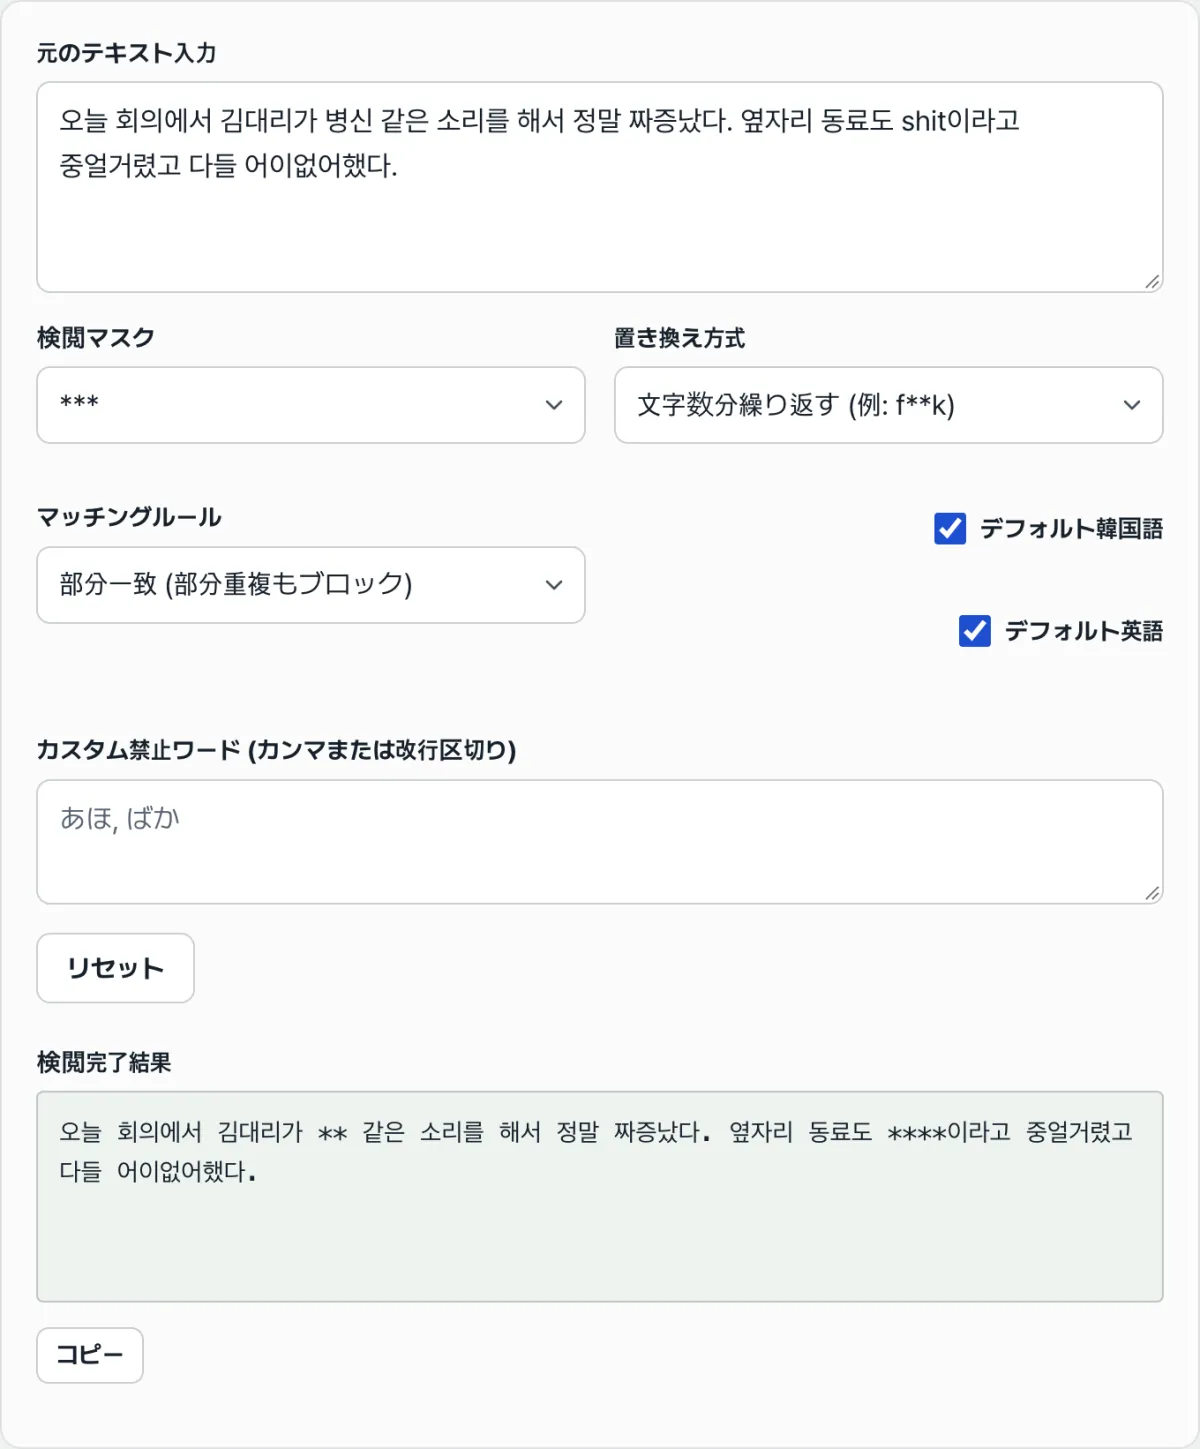
- ステップ1(検閲対象テキストの入力): レビュー、コメント、チャットログを「NGワード・暴言フィルター(伏字変換)」の入力欄に貼り付けます。
- ステップ2(マッチング基準の選択): 厳格にブロックしたいなら部分一致、正常な単語を残したいなら完全一致を選びます。
- ステップ3(カスタム禁止語の追加): サービスの特性に合わせた特定の誹謗中傷語やブランド固有の禁止語を追加登録します。
- ステップ4(代替記号の設定): アスタリスク(***)、[CENSORED]、ハート(♥♥)など、好みのマスキングスタイルを指定します。
- ステップ5(整形済みテキストをワンクリックでコピー): 1秒で整った安全なテキストをコピーし、お知らせやWebに掲載します。
サービス企画者が公開する暴言フィルタリングのコツ7選
- 文字数と同じ長さのマスキングを適用: 3文字の暴言は'***'、2文字の暴言は'**'に置換すると、文の流れが自然になります。
- 繰り返し文字の圧縮正規化: '씨이이이발'のように母音を長く伸ばすパターンは、/(.)\1{2,}/gの正規表現で1文字に圧縮してからマッチングします。
- 英字の大文字・小文字を無視(iフラグ): 'fUcK'、'ShIt'など大文字と小文字を混ぜた暴言を捕捉するため、必ず大文字・小文字を無視するフラグを有効にします。
- 数字置換文字列(Leet)のマッピング: '1' ➔ 'I/ㅣ'、'0' ➔ 'O/ㅇ'、'8' ➔ 'B'など、数字に変形した隠語辞書を登録します。
- 禁止語辞書の定期的な更新: 新語や流行語による侮蔑的な発言をモニタリングし、月1回辞書を更新します。
- 通報の累積に基づくブラックリスト連携: フィルタリングを回避するユーザーには、通報が3回累積した時点で自動的に一時ブロックするルールを適用します。
- 本ツールをお気に入りに追加: ブログやコミュニティの記事をキャプチャ・引用するとき、1秒でセンシティブな暴言をきれいに消せます。
最終決定ツリー:どのマッチングオプションを使うべきか?
- 状況A(ブログのキャプチャ引用、公共機関の投稿文の整形) ➔ 部分一致 + アスタリスク(***)マスキング(徹底したクリーン化)
- 状況B(自由なコミュニケーションが重視されるカジュアルなコミュニティ) ➔ 完全一致 + ホワイトリスト(スカンソープ問題の誤検知を最小化)
- 状況C(子ども向け・教育向けプラットフォームのチャット欄) ➔ 部分一致 + 特殊文字・空白の完全除去正規化
- 状況D(大容量のリアルタイムライブストリーミングチャット) ➔ Aho-Corasickベースの超高速C/WASMモジュールを適用
テキスト検閲 & 文字列マッチング 主要用語チートシート
- スカンソープ問題(Scunthorpe Problem): 正常な単語の中に禁止語の綴りが含まれているために、システムが無害な単語をブロックしてしまう現象。
- 単語境界(Word Boundary、\b): アルファベットやハングルの文字と、空白・句読点との境界点を表す正規表現のメタ文字。
- Aho-Corasick(アホ・コラシック): 複数のパターン文字列を、本文を一度走査するだけで同時に見つけ出す有限オートマトンのアルゴリズム。
- マスキング(Masking): 機密性の高い単語や個人情報を特定の記号(*、# など)で隠す手法。
よくある質問
「무지개」(虹)と入力しただけなのに「무지***」と伏字になるのはなぜですか?
「部分一致」オプションがオンになっていて、禁止ワード一覧に「개」が登録されているためです。単語の中に含まれる文字までまとめて伏字にするモードなので、独立した暴言だけを伏字にしたい場合は「完全一致」オプションに変更してください。
記号を混ぜて書いた暴言も自動的に検出されますか?
基本的な正規表現マッチングは連続した文字列を比較する仕組みなので、記号を混ぜた暴言を捉えたいときは、テキストを入力する前に空白と記号を一時的に取り除いてから検査する2次検証を併用するのがおすすめです。
入力した機密性の高い文章がサーバーに送信されたり保存されたりすることはありますか?
まったくありません。本ツールのテキスト正規表現置換は、すべてユーザーのウェブブラウザ内のJavaScriptエンジンでローカルに実行されるため、テキストが外部サーバーに保存されることは一切ありません。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む