
Base64 エンコード・デコードの仕組みと文字化け対策
目次
ウェブ開発をしていたり、APIのレスポンスを覗いていたりすると、「eyJhbGciOiJIUzI1NiJ9...」 のようなJWTトークンや、「data:image/png;base64,iVBORw0KGgo...」 で始まる意味不明な長い文字列に毎日のように出くわします。
人間には読めない不規則な文字の並びから、これをパスワードの暗号化(Encryption)だと勘違いされることも多いのですが、実のところこれは、コンピュータネットワーク上で2進数のバイナリを安全に送るための「Base64エンコード」です。
Base64が8ビットのデータを6ビットずつに分割し、容量が33%増えるという数学的な仕組み、末尾に付く等号(==)パディングのルール、日本語が文字化けしないUTF-8変換の方法、そして暗号化との決定的な違いまで、すべて整理してお伝えします。
要点まとめ ① 6ビット・64文字へのマッピング: 3バイト(24ビット)のデータを6ビットずつ4つに分け、A-Z、a-z、0-9、+、/ の64個の安全なASCII文字に変換します。 ② 33%の容量膨張: 8ビットの情報を6ビットの文字に載せるため、エンコード後のデータサイズは元データのちょうど4/3倍(約+33%) に増えます。 ③ パディング等号(=)のルール: 元のバイト数が3の倍数でないとき、足りない桁を埋めるために、1バイト不足なら「==」、2バイト不足なら「=」が付きます。 ④ エンコードは暗号化ではない: 秘密鍵がなくても誰でも0.1秒で元の文にデコードできるため、パスワードや個人情報を隠す用途に使ってはいけません。
Base64はなぜ生まれたのか: 7ビットのメール網を生き抜くための戦略
初期のコンピュータネットワークとメール送信規格(SMTP)は、7ビットの英字ASCIIしか扱えないように設計されていました。 8ビットのバイナリ(画像、圧縮ファイル、英語以外の文字)をそのまま送ると、最上位ビット(MSB)が0に切り落とされてデータが壊れるおそれがありました。
これを解決するために、どんな古いネットワーク機器やメールサーバーを経由しても絶対に変化しない64個の共通ASCII文字(A-Z、a-z、0-9、+、/) だけでバイナリデータを安全に包み込む(ラップする)方式が、ほかでもないBase64です。
手を動かして追うBase64エンコードの原理: 「Cat」
3文字の英単語「Cat」(3バイト = 24ビット)が変換されるビット演算の流れです。
- バイトへの変換: 'C'(67 = 01000011)、'a'(97 = 01100001)、't'(116 = 01110100)
- 24ビットのストリームとして結合: 010000110110000101110100
- 6ビットずつ4つに分割:
- 010000(10進数16)➔ Q
- 110110(10進数54)➔ 2
- 000101(10進数5)➔ F
- 110100(10進数52)➔ 0
- 最終的なエンコード結果: Q2F0(きっちり4文字で完成)
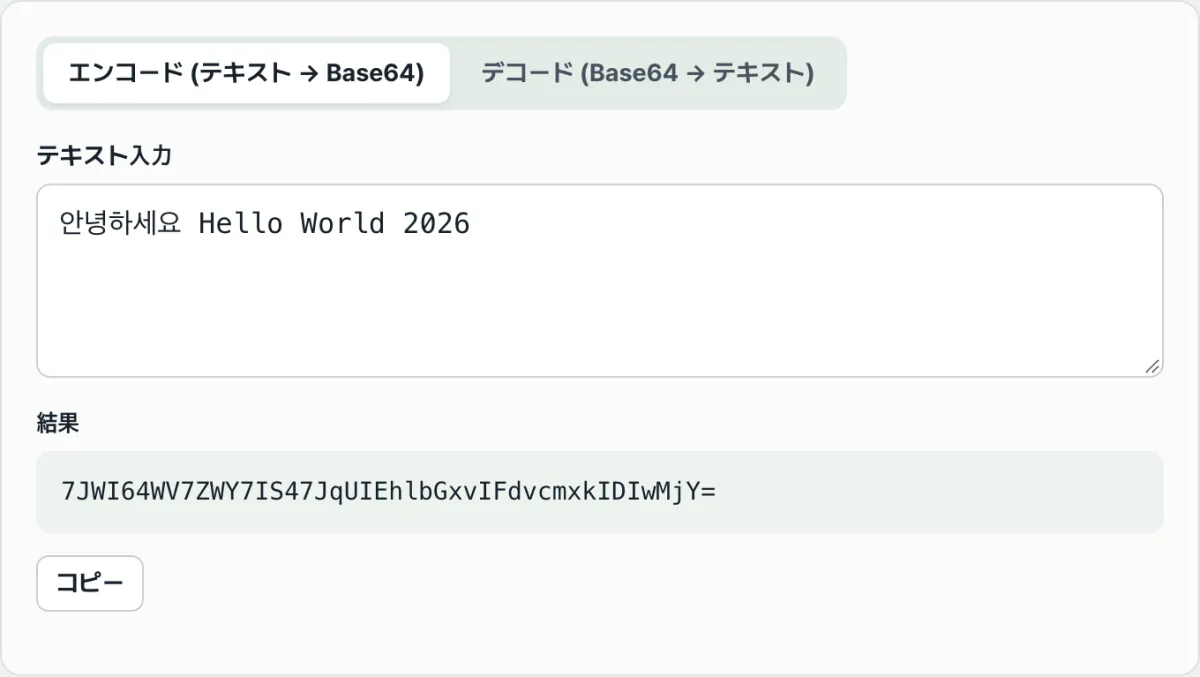
無料 · テキストを入力するだけで、日本語や絵文字も欠けることなく1秒でBase64に相互変換
中核となる技術メカニズム: 3バイト➔4文字のビット演算とパディング等号(=)の公式
Base64の変換エンジンがメモリ上でビットを操作する数学的な原理を分析します。
1. 24ビットという最小公倍数(LCM)のマッピング
- データサイズの増加率: 4 Characters × 8 Bits/3 Bytes × 8 Bits = 4/3 ≈ 133.33%(+33.3%の膨張)
2. パディング等号(=)を決めるアルゴリズム
- R = 1(1バイト余る): 8ビット ➔ 6ビット1個 + 2ビット(0で埋める)1個 ➔ 有効文字2個 + パディング「==」(2個)
- R = 2(2バイト余る): 16ビット ➔ 6ビット2個 + 4ビット(0で埋める)1個 ➔ 有効文字3個 + パディング「=」(1個)
- R = 0(3バイトの倍数): 24ビット ➔ 有効文字4個 + パディングなし(0個)
3. 日本語をUTF-8で欠損なく変換するパイプライン
// 安全なモダンなマルチバイト文字のBase64エンコード
function safeBase64Encode(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = "";
  bytes.forEach(b => binary += String.fromCharCode(b));
  return btoa(binary);
}
標準Base64 vs Base64URL vs Hex(Base16)比較マトリクス
| 比較項目 | 標準Base64(RFC 4648) | Base64URL(RFC 7515) | Hex / Base16(16進数) |
|---|---|---|---|
| 62番目の文字 | +(プラス) | -(マイナス) | 該当なし |
| 63番目の文字 | /(スラッシュ) | _(アンダースコア) | 該当なし |
| パディング等号(=) | 必須(1〜2個を追加) | 省略(No Padding) | なし |
| URLパラメータでの安全性 | 不安(+、/ がURL予約文字) | 安全(URL-Safe) | 安全 |
| 容量の膨張率 | +33% | +33% | +100%(2倍に膨張) |
| 主な用途 | メール添付、画像のData URI | JWTトークン、OAuth2のURLパラメータ | ハッシュダイジェスト、暗号鍵 |
Base64を扱うときによくある5つのミス
- Base64をパスワードの暗号化だと勘違いする: 誰でも復号できるため、セキュリティ目的で単独利用してはいけません。
- 日本語や特殊文字のエンコードでbtoa()を直接呼び出す: ブラウザのLatin1例外でクラッシュします(TextEncoderが必須)。
- URLのクエリ文字列に標準Base64をそのまま入れる: 「+」が空白に変わったり、「/」がパスとして分割されたりするバグになります。
- 数MBを超える大きな画像をData URIとしてHTMLに埋め込む: HTMLの容量が数十MBに膨れ上がり、レンダリングが重くなります(10KB以下のアイコンだけ推奨)。
- デコード時の改行・空白の処理が不十分: コピーの過程で入った改行(CRLF)が原因でデコーダーエラーになります。
ミスのないBase64変換・5ステップの実践ワークフロー
- ステップ1(変換方向の選択): テキストをBase64に変換するか(エンコード)、Base64をテキストに戻すか(デコード)を選びます。
- ステップ2(文字列の入力): 変換したい元のテキストやJWTトークン、ハッシュ文字列を入力欄に入れます。
- ステップ3(UTF-8への自動バイト処理): 本ツールが日本語、絵文字(Emoji)、特殊文字をUTF-8のバイナリに自動で正規化します。
- ステップ4(1秒のリアルタイム演算): 6ビット単位のビットシフト演算で変換したBase64の結果と等号パディングを、画面にすぐ出力します。
- ステップ5(結果のコピーとコードへの貼り付け): 完成した安全なBase64テキストをワンクリックでコピーし、APIリクエストやソースコードに貼り付けます。
Base64の実践テクニック7選
- JWT(JSON Web Token)の構造を読み解く: xxxx.yyyy.zzzz 形式のJWTでは、ドット(.)で区切られた前の2つの部分をBase64URLデコードすると、ヘッダーとペイロードのJSONをすぐに確認できます。
- 10KB以下の小さなアイコンだけをData URIでインライン埋め込み: HTTPリクエストの回数が減って初回表示が速くなりますが、50KB以上のものは別ファイルに分けたほうがキャッシュの面で有利です。
- URL-Safe Base64への手動変換: str.replace(/+/g, '-').replace(///g, '_').replace(/=+$/, '')
- Node.jsのネイティブ変換: Buffer.from(text, 'utf-8').toString('base64') および逆変換 Buffer.from(b64, 'base64').toString('utf-8')
- 絵文字(UTF-8 4バイト)を完全に保持: UTF-8バイト配列ベースのエンコーダーを使えば、炎(🔥)やハート(❤️)などの複合絵文字も文字化けせずに復元されます。
- 改行の自動フィルタリング: メール本文からコピーしたBase64に76文字ごとに入る改行(
\n)は、デコード前に正規表現/s/gで取り除く必要があります。 - 「Base64 エンコード・デコード」をブラウザのブックマークに登録: 開発中のAPIデバッグやトークンの解読が必要なときに、1秒でブラウザ上で解決できます。
最終決定ツリー:どのエンコーディングを使うべきか?
- ケースA(JWTトークンの発行、OAuthパラメータの受け渡し、REST APIのクエリ) ➔ Base64URL(URL-Safe、パディング除去)
- ケースB(HTML/CSS内への小さなロゴのインライン埋め込み、メール添付) ➔ 標準Base64(Data URI)
- ケースC(ユーザーのパスワード保存、機密データの保管) ➔ エンコード禁止 ➔ bcrypt / Argon2 による一方向ハッシュが必須
- ケースD(秘密のメッセージの送受信、決済データの送信) ➔ AES-256-GCMで対称暗号化してからBase64でパッケージング
Base64 & ネットワーク通信 主要用語チートシート
- Base64: 8ビットのバイナリデータを64種類の印字可能なASCII文字に置き換える6ビットのエンコーディング規格。
- パディング(Padding、=): 3バイトの倍数にならないデータの最後の空き部分を埋めて、4文字の倍数に揃えるための記号。
- Data URI: 外部ファイルへのリンクの代わりに、画像やフォントのデータを data:image/png;base64,... の形でHTMLに直接埋め込む手法。
- JWT(JSON Web Token): 当事者間で情報をJSONオブジェクトとして安全に送信するために、Base64URLでシリアライズしたウェブ標準のトークン。
よくある質問
Base64文字列の末尾に「=」が付くのはなぜですか?
元データのバイト数が3の倍数で割り切れないとき、Base64文字列全体の長さを4の倍数に合わせるために、余った空きを埋める標準規格のパディング文字だからです。
Base64は暗号化ですか?
いいえ、まったく違います。暗号化は秘密鍵(Key)がなければ復号できませんが、Base64は世界中で公開されている共通のルールに従えば誰でも元の文に戻せる「単なるデータ表現の変換」です。
「Base64 エンコード・デコード」に入力したテキストやトークンはサーバーログに残りますか?
一切残りません。Base64のエンコードとデコードはすべてユーザーのブラウザ内のローカルJavaScriptエンジンで即座に処理され、どんなデータも外部サーバーへ送信されることはありません。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む