
camelCaseとsnake_caseの変換ルールを総整理
目次
camelCaseとsnake_caseが紛らわしく感じられるのは、表記法の名前に馴染みがないからではありません。テキストがどの地点で単語に区切られ、その単語がどの記号でつなぎ直されるのか、そのルールを知らないからです。
このルールを押さえておけば、myVariableNameがmy_variable_nameに変わる過程も、数字や特殊文字が混ざったテキストが思いがけない位置で区切られる理由も、すべて説明できます。
変数名やファイル名の表記法を扱う開発者の方や、変換結果を目で確かめたい方に向けた内容です。
要約 ① 単語は、ローマ字の小文字・数字のすぐ後ろに大文字が来る地点と、文字・数字・ハングル以外の記号が連続する地点で区切られます。 ② camelCase・PascalCaseは、区切った単語を記号なしでつなぎ、snake_case・kebab-case・CONSTANT_CASEはアンダースコアやハイフンでつなぎます。 ③ Title Case・文章形(Sentence case)はこの単語分割ルールを使わないため、スペースのないcamelCaseのテキストをそのまま入れても、単語ごとには分かれません。
表記法の変換が必要になる場面
API仕様書やデザインスペックには、「User Profile Image」のように人が読みやすい名前が書かれていることがよくあります。この名前をそのままコードに使うのは難しく、実際のコードでは次のように使い分けます。
- JavaScriptの変数名: camelCase(例: userProfileImage)
- データベースのカラム名: snake_case(例: user_profile_image)
- CSSカスタムプロパティ・URLパス: kebab-case(例: user-profile-image)
- 環境変数: CONSTANT_CASE(例: USER_PROFILE_IMAGE)
問題になるのは、名前に数字や略語が混ざったときです。getUserIDやhtml5Videoのように大文字・数字・小文字が入り混じったテキストを手作業で分けようとすると、どこで区切るかの判断が人によって変わりがちです。
その結果、同じ名前がチーム内でgetUserId、getUserID、get_user_idとバラバラに表記されることがあります。表記法ごとに単語の分け方とつなぎ方が厳密に決まっていると分かっていれば、こうした表記ゆれをルールに照らして検証できます。
ツールを使わずに単語を分けて表記法を適用する方法
表記法の変換は2つの段階で行われます。まずテキストを単語単位に区切り、次にその単語を表記法ごとのルールでつなぎ直します。この2段階を手作業でそのまま再現すれば、ツールがなくても同じ結果が得られます。
ステップ1: 単語の境界を見つける
camelCase・PascalCase・snake_case・kebab-case・CONSTANT_CASEの5つは、次の2つのルールで単語の境界を見つけます。
- ルール1(大文字・小文字の境界): ローマ字の小文字または数字のすぐ後ろに大文字が来たら、その間で区切ります。myVariableNameはmy / Variable / Nameに、html5Videoはhtml5 / Videoに分かれます。
- ルール2(記号の境界): ローマ字・数字・ハングル以外の文字(スペース、アンダースコア、ハイフン、ピリオドなど)が1つでも複数でも連続していれば、その区間全体を境界とみなし、両隣の文字だけを単語として残します。hello___worldは、アンダースコアが3つ続いていても、hello / worldの2語にしか分かれません。
一方、Title Caseと文章形は、この2つのルールのうちルール2に近い考え方で、スペースや記号で区切られたひとかたまりを1つの単語として扱います。ルール1(大文字・小文字の境界)は適用しません。
そのため、スペースなしでつないだcamelCaseのテキストをそのままTitle Caseに入れると、getUserIDのようなテキストは単語ごとに分かれず、先頭の1文字だけが大文字になったひとかたまり(Getuserid)になります。
同じテキストをcamelCaseに変換すると、get / User / IDの3語に正しく分かれ、getUserIdになります。
ステップ2: 分けた単語を表記法ごとのルールでつなぎ直す
| 表記法 | 単語をつなぎ直すルール |
|---|---|
| 大文字 (UPPER) | テキスト全体を大文字にします(単語の分割なし) |
| 小文字 (lower) | テキスト全体を小文字にします(単語の分割なし) |
| Title Case | スペースや記号で区切られたかたまりごとに、先頭の1文字だけを大文字にします |
| 文章形 (Sentence) | 全体を小文字にしたうえで、文の先頭の1文字だけを大文字にします |
| camelCase | 最初の単語は小文字、2語目以降は先頭の1文字だけを大文字にして、記号なしでつなぎます |
| PascalCase | すべての単語の先頭の1文字を大文字にして、記号なしでつなぎます |
| snake_case | すべての単語を小文字にして、アンダースコア(_)でつなぎます |
| kebab-case | すべての単語を小文字にして、ハイフン(-)でつなぎます |
| CONSTANT_CASE | すべての単語を大文字にして、アンダースコア(_)でつなぎます |
camelCase・PascalCaseでいう「先頭の1文字だけを大文字にする」とは、残りの文字をすべて小文字に強制変換するという意味です。
そのため、単語の中にもともと大文字が複数あった略語(IDやURLなど)は、先頭の1文字だけが残り、残りは小文字になります。この点は、以下の確認方法にもつながります。
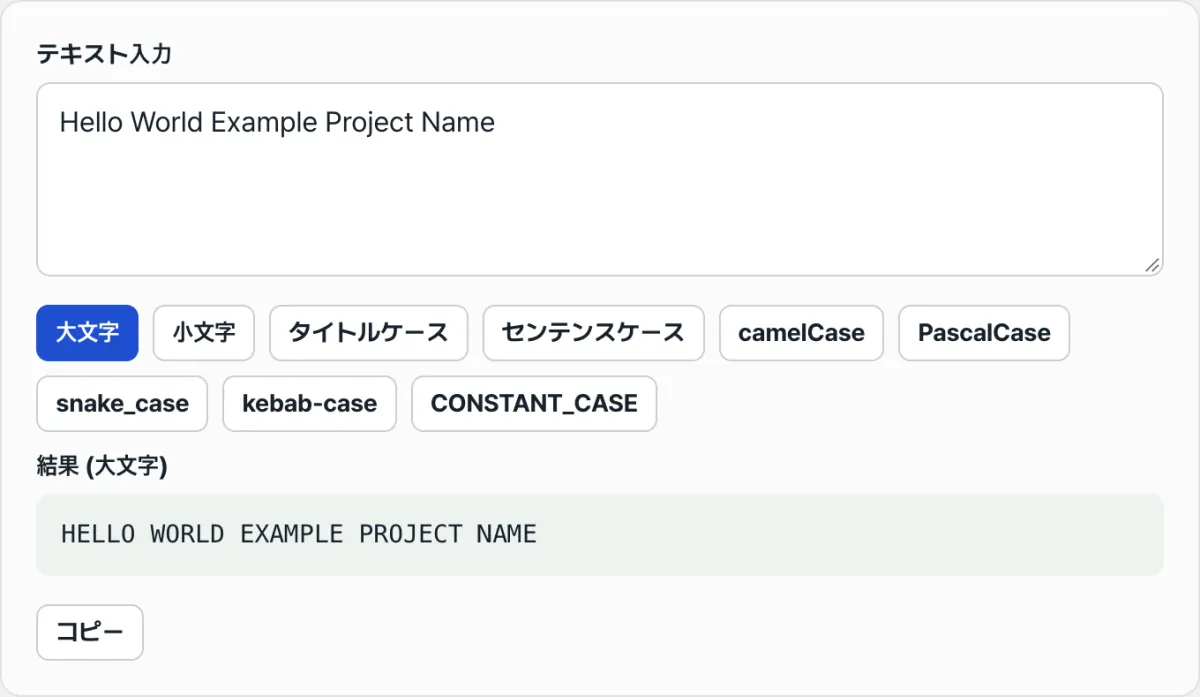
「大文字・小文字/ケース変換(camelCase・snake_case)」で確認してみましょう。
テキストを大文字・小文字・Title・文章形式・camelCase・PascalCase・snake_case・kebab-case・CONSTANT_CASEにすぐ変換できます。インストールや会員登録は不要で、無料で使えます。
間違えやすい変換結果
同じ入力を複数の表記法に入れてみると、ルールだけでは予想しにくい結果になる場面があります。ここでは、実際につまずきやすいケースを紹介します。
| 紛らわしい場面 | 実際のルール |
|---|---|
| getUserIDをcamelCaseに変換するとgetUserIdになり、IDではなくIdに見える | 単語をつなぐとき、各単語の先頭の1文字だけを大文字のまま残し、残りはすべて小文字にするためです。CONSTANT_CASE(GET_USER_ID)のように単語全体を大文字にする表記法では、略語がそのまま保たれます。 |
| html5Videoがhtml5 Videoと、5の後ろで区切られる | 小文字または数字のすぐ後ろに大文字が来ると、その地点を単語の境界とみなすためです。数字の前後が小文字でつながっている場合(例: user2name)は、境界とはみなしません。 |
| myVariableNameをTitle Caseに入れても、単語ごとに分かれない | Title Caseと文章形が認識するのは、スペースと記号による境界だけです。大文字・小文字の境界で分けるルールが適用されるのは、camelCase系の5つだけです。 |
이름Nameのようにハングルの直後に英字の大文字が続いても区切られない | 大文字・小文字の境界ルールが働くのは、ローマ字の小文字・数字と大文字の間だけです。ハングルはこのルールの対象ではありません。 |
| hello___worldのように区切り記号が複数連続しても、空の単語はできない | 連続した記号をひとつの境界にまとめて処理するためです。 |
まとめ
- 変換方式は大きく2つのグループに分かれます。テキスト全体をまとめて扱うグループ(大文字・小文字・Title Case・文章形)と、単語に分けてからつなぎ直すグループ(camelCase・PascalCase・snake_case・kebab-case・CONSTANT_CASE)です。
- 単語に分けるグループは、ローマ字の小文字・数字のすぐ後ろに大文字が来る地点と、ローマ字・数字・ハングル以外の記号が連続する地点で区切られます。
- camelCase・PascalCaseは各単語の先頭の1文字だけを残して残りを小文字にするため、大文字が連続する略語は元の形を失います。
- Title Caseと文章形は大文字・小文字の境界を認識せず、スペースと記号だけを境界とするため、スペースのないcamelCaseのテキストを入れると単語ごとには分かれません。
- ハングルは大文字・小文字の区別がない文字なので、どの表記法を選んでもそのまま残ります。
テキストを大文字・小文字・Title・文章形式・camelCase・PascalCase・snake_case・kebab-case・CONSTANT_CASEにすぐ変換できます。インストールや会員登録は不要で、無料で使えます。
仕組みを解説: 正規表現による境界認識アルゴリズムとトークナイザ
一見シンプルに見えるケース変換ですが、内部では複雑な文字列処理と正規表現(Regular Expression)による境界認識が行われています。特に、略語を保ちながら大文字・小文字が切り替わる位置を正確に見つける処理は、コンピュータサイエンスの観点でもなかなか難しいトークン化(Tokenization)の問題です。
正規表現の先読みと後読み(Lookaround)
通常の正規表現だけでは、連続した文字列をうまく区切れません。そこで、Lookbehind(後読み)とLookahead(先読み)のアサーション(Assertion)を組み合わせて、仮想的な区切り位置をつくります。
もっとも基本的なキャメルケースの分割用正規表現パターンは次のとおりです。
正規表現: (?<=[a-z0-9])(?=[A-Z])
このパターンは「直前が小文字か数字で、直後が大文字になる位置(文字と文字の間)」にマッチします。そのため、myVariableName は my、Variable、Name に分割されます。
ただし、略語が連続している場合は問題が起こります。HTTPServer のような単語は、上の正規表現だけでは HTTP と Server に分かれません。そこで、2つ目のルールを追加します。
正規表現: (?<=[A-Z])(?=[A-Z][a-z])
このパターンは「直前が大文字で、直後が大文字+小文字の組み合わせになる位置」にマッチし、HTTP と Server の境界を正確に見つけ出します。
文字列のトークン化(Tokenization)パイプライン
ケース変換ツールは、一般的に次の4段階のパイプラインで処理を行います。
- 正規化(Normalization): 入力された文字列の前後の空白を取り除き、連続する特殊文字や区切り文字を1つの空白に置き換えます。
- トークン分割(Split into tokens): 前述の正規表現のLookaround技法を使って、文字列を独立した単語(Token)の配列に分割します。
- トークンごとの大文字・小文字変換(Casing transformation per token): 変換先の表記法に合わせて、各トークンの大文字・小文字を強制的に変換します。PascalCaseなら、すべてのトークンの先頭を大文字、残りを小文字にします。
- 区切り文字での結合(Join with delimiter): 変換したトークンを、変換先の区切り文字(空文字列、アンダースコア _、ハイフン -)でもう一度つなぎ合わせます。
略語の扱いという難題(Acronym Preservation Challenge)
変換ツールの開発者を最も悩ませるのが、XMLHTTPRequest のような略語の処理です。これをスネークケースに変換するとき、xml_http_request と賢く分割するツールもあれば、正規表現が洗練されていない単純なツールでは xml_httprequest のようにつなげてしまったり、さらには x_m_l_h_t_t_p_request のように1文字ずつ細かくバラバラにしてしまったりすることもあります。言語ごとのコーディング規約やチームのコンベンションに応じて、どの方式が適切か、事前に合意しておく必要があります。
言語ごとの公式命名規則の違い
プログラミング言語のエコシステムには、それぞれ独自の公式スタイルガイドがあります。
- Python (PEP 8): 関数名と変数名は
snake_case、クラス名はPascalCase。 - Java (Google Java Style Guide): メソッドと変数は
camelCase、定数はCONSTANT_CASE。 - Go (Effective Go): パッケージ外に公開(Export)する場合は
PascalCase(MixedCaps)、内部ではcamelCase。 - Rust (RFC 430): 変数と関数は
snake_case、型とトレイトはPascalCase。 - TypeScript / JavaScript: 変数と関数は
camelCase、クラスとインターフェースはPascalCase、ファイル名にはよくkebab-caseが使われます。
7つの命名規則(Casing Conventions)の比較表
| 表記法 | 特徴・構造 | 主な用途(言語・エコシステム) | 代表的な例 | 正規表現による分割・結合パターン |
|---|---|---|---|---|
| camelCase | 最初の単語は小文字、以降の単語は先頭を大文字にし、空白なし | Java、TS/JS、C#の変数名・関数名 | myVariableName, getUserId | 分割: (?<=[a-z])(?=[A-Z])、結合: 空白なしでつなぐ |
| PascalCase | すべての単語の先頭を大文字にし、空白なし (UpperCamelCase) | C#、TSのインターフェース、Javaのクラス、GoのExport | MyVariableName, GetUserId | 分割: (?<=[a-z])(?=[A-Z])、結合: 空白なしでつなぐ |
| snake_case | すべての単語を小文字にし、スペースをアンダースコア(_)に置き換える | Pythonの変数、DBのカラム名、Rustの関数 | my_variable_name, get_user_id | 区切り文字(_)でsplitおよびjoin |
| kebab-case | すべての単語を小文字にし、スペースをハイフン(-)に置き換える | URLのパス、CSSのプロパティ、HTMLのタグ、フォルダ名 | my-variable-name, get-user-id | 区切り文字(-)でsplitおよびjoin |
| CONSTANT_CASE | すべての単語を大文字にし、スペースをアンダースコア(_)に置き換える (UPPER_SNAKE_CASE) | 環境変数(.env)、グローバル定数の設定 | MY_VARIABLE_NAME, GET_USER_ID | 区切り文字(_)でsplitおよびjoin |
| Title Case | 各単語の先頭を大文字にし、空白は維持 | ブログ記事のタイトル、書籍のタイトル、メニューのラベル | My Variable Name, Get User Id | 空白( )を基準に先頭を大文字化 |
| Train-Case | すべての単語を大文字にし、スペースをハイフン(-)に置き換える (COBOL-CASE) | LISP系の言語、旧来のメインフレームシステム | MY-VARIABLE-NAME, GET-USER-ID | 区切り文字(-)でsplitおよびjoin |
ケース変換でやりがちな5つの重大ミス
表記法を手作業で変換したり、不適切なスクリプトを使ったりしたときに、よく起こる5つの問題です。
- 単純な正規表現による略語の境界の崩れ (Losing Acronym Boundaries):
getURLをスネークケースに変える際、大文字の前に単純にアンダースコアを入れる正規表現を使うと、get_u_r_lのように意味のない1文字ずつに分断されてしまいます。Lookaround を使った精度の高い正規表現か、専用ツールの利用が欠かせません。
- 英字と数字が混在する場合の分割ミス (Mixing Numbers with Letters):
v2Apiという文字列を変換すると、変換ツールによってv_2_apiに分けたりv2_apiに分けたりと、動作がばらばらです。数字を独立した単語として扱うのか、直前の文字列の続きとして扱うのか、チーム内で明確なルールを決めておく必要があります。
非ASCII文字や日本語・韓国語などの文字を含む場合の正規表現の誤動作: ハングルや絵文字などのUnicode文字が混ざった識別子(例:
get유저Info)では、ローマ字のアルファベットだけを前提に書かれた古い正規表現ベースの変換ツールだと境界の認識に失敗し、get유저infoのような意図しない結果になったり、エラーが出たりします。大規模チームでの命名規則のばらつきの放置: 同じプロジェクト内で、ある人は
user_id、ある人はuserId、さらにuser_IDまで混在して使っているケースです。コードの可読性を大きく損なううえ、検索(grep)を使った全体のリファクタリングやテキスト置換もできなくなります。JSONシリアライズ(Serialization)時のケース変換ルールの設定漏れ: バックエンド(スネークケース)とフロントエンド(キャメルケース)が通信する際、間にあるAPIゲートウェイやDTOのシリアライザ(例: Jackson、GSON、class-transformer)でフィールド名の変換オプションを有効にしていないと、クライアント側では undefined の値が表示されてしまいます。
レガシーコードを整える、命名リファクタリング5ステップ
- チームのスタイルガイドを定め、ツールで強制する (.editorconfig / ESLint):
口頭で決めただけのルールは意味がありません。プロジェクトのルートに
.editorconfigと.eslintrc(または.prettierrc)を設定し、全メンバーのIDEで表記法が強制的に統制される仕組みをつくりましょう。 - 現状の識別子の一貫性を監査する (Audit Current Identifier Consistency): SonarQubeなどの静的解析ツールでベースラインとなるコードをスキャンします。どのモジュールで命名規則の違反が最も多いかを把握し、段階的なリファクタリング計画を立てます。
- シリアライズ変換を自動化するミドルウェアを構成する: Spring BootやNestJSなどのフレームワーク側で、送受信するJSONペイロードのキーを自動変換してくれるミドルウェアやデコレーター(PropertyNamingStrategy)を、全体に対して有効にします。
- 専用のケース変換ツールで一括リネームする (Batch Renames): IDEの Refactor - Rename 機能や、このページ上部の「大文字・小文字/ケース変換(camelCase・snake_case)」ツールを活用して、数十個の変数名を一度に安全に変換します。手作業は typo のもとです。
- CIパイプラインにリントチェックを組み込む (Run CI Lint Checks): GitHub ActionsなどのCI/CDに、リント(Lint)による検証ステップを必ず組み込み、ルールに合わない識別子を含むPR(Pull Request)は自動的にマージ(Merge)できないようにして守りを固めます。
命名・表記のコツ7つ
- 個人の好みより、言語やフレームワークの慣用表現(Idiom)に必ず従いましょう。 Pythonでキャメルケースを使ったり、Javaでスネークケースを使ったりすると、チームメンバーに大きな認知負荷をかけてしまいます。
- 連続する大文字の略語の表記を明確に取り決めましょう。
HTTPRequestにするのかHttpRequestにするのか、userIDなのかuserIdなのか、チームのルールを文書にしておく必要があります。最近は、一般の単語のように先頭の1文字だけを大文字にするHttpRequestの形が好まれる傾向にあります。 - 自動シリアライズ用のデコレーターを活用しましょう。 Javaの
@JsonProperty("user_id")、TSの@Expose({ name: "user_id" })、Goのjson:"user_id"タグを使えば、コード内部ではキャメルケースを保ったまま、DBやAPIのスネークケースときれいに対応づけられます。 - URLのパスやREST APIのエンドポイントは、原則としてkebab-caseを使いましょう。
/get_user_profile(X)や/getUserProfile(X)よりも、/get-user-profile(O)の形が、検索エンジン最適化(SEO)と可読性の面でグローバルスタンダードです。 - 定数(CONSTANT_CASE)は、本当に不変(Immutable)の値にだけ使いましょう。 実行時に値が変わりうる通常の変数を大文字のスネークケースで宣言するのは、定数が持つ意味上の目的に反するアンチパターンです。
- Lookaround を使った正規表現の仕組みを理解し、自作スクリプトを書いてみましょう。 一度きりの変換でなければ、先ほど説明した
(?<=[a-z0-9])(?=[A-Z])のパターンを使った正規表現の置換マクロをエディタに登録しておくと、作業効率が大きく上がります。 - このケース変換ツールをブラウザのブックマークに保存しておきましょう。 急ぎでDBのクエリを書いたり、DTOのインターフェースを入力したりするときに、手作業で書き換える時間を大幅に減らしてくれる便利なユーティリティになります。
迷わず選べる表記法の決定ツリー (Decision Tree)
「この変数名は、いったいどのケースで付ければいいのだろう?」と迷ったときは、次の決定ツリーをたどれば、すぐに答えが出ます。
- 設定ファイル(.env)、不変の定数、またはグローバルな環境変数ですか?
- YES ➔ CONSTANT_CASE (例:
MAX_RETRY_COUNT) - NO ➔ 次へ進む
- YES ➔ CONSTANT_CASE (例:
- Web URLのエンドポイント、CSSのクラス名、またはディレクトリ名・ファイル名ですか?
- YES ➔ kebab-case (例:
user-profile-card) - NO ➔ 次へ進む
- YES ➔ kebab-case (例:
- リレーショナルデータベース(RDBMS)のテーブル名やカラム名ですか?
- YES ➔ snake_case (例:
created_at) - NO ➔ 次へ進む
- YES ➔ snake_case (例:
- 使用している言語は Python、Rust、Ruby、または PHP(一部)ですか?
- YES ➔ snake_case (例:
fetch_user_data) - NO (Java、JS、TS、C#、Go など) ➔ 次へ進む
- YES ➔ snake_case (例:
- クラス、インターフェース、型、またはGo言語のエクスポート対象ですか?
- YES ➔ PascalCase (例:
UserDataResponse) - NO (通常の変数、関数、メソッド、パラメータ) ➔ camelCase (例:
fetchUserData)
- YES ➔ PascalCase (例:
プロ向け 重要技術用語チートシート(Terminology)
- camelCase(キャメルケース): 単語を空白なしでつなぎ、最初の単語は小文字、2語目以降は先頭を大文字にする表記法。ラクダのこぶに似ていることからこの名前が付きました。
- PascalCase(パスカルケース): すべての単語の先頭を大文字にする表記法。UpperCamelCaseとも呼ばれます。
- snake_case(スネークケース): ヘビのように長くつながるという意味で、単語間の空白をアンダースコア(Under-score、_)に置き換える表記法。
- kebab-case(ケバブケース): 串に刺したケバブのように、単語の間をハイフン(Dash、-)でつなぐ表記法。主にURLやCSSで使われます。
- CONSTANT_CASE(定数ケース): すべての文字を大文字にし、単語の間をアンダースコアでつなぐ方式(UPPER_SNAKE_CASE)。用途は定数や環境変数の表記に限られます。
- Lookaround 正規表現(Regex Lookaround): 正規表現で、結果に含めずに条件だけを検査できる強力な探索機能。先読み(?=...)と後読み(?<=...)があります。
- DTOのシリアライズ(Serialization): メモリ上のオブジェクトデータ(DTO)を、ネットワーク送信やDB保存のためにJSONなどの形式へ変換する処理。この過程でケース変換が頻繁に発生します。
よくある質問
Q1. IOStreamのように大文字の略語が連続する識別子は、どう変換するのが最も安全ですか?
大文字の略語が連続する識別子は、従来のcamelCase変換ツールが最も苦手とする部分です。IOStreamをキャメルケースにすると、iOStreamになるシステムもあれば、ioStreamになるものもあります。最も安全で現代的な方法は、略語も1つの単語として扱い、IoStream(パスカルケース)またはioStream(キャメルケース)と記述することです。こうしておけば、後でsnake_caseに自動変換されたときもio_streamときれいに分割でき、相互運用性が最大限に高まります。
Q2. 識別子に数字が含まれる場合、単語の区切りはどのルールに従いますか?
数字の扱いは、ツールやフレームワークによって微妙に異なります。一般的には、数字もローマ字の小文字と同じ扱いです。そのためuser2Nameはuser2 / Nameに分割され、user2_nameになります。ただし、前後がどちらも文字の場合(例: v2Api)には、数字を独立した単語として扱いv_2_apiと区切る厳格なlintルールもあります。予測しにくさを減らすには、そもそも識別子の途中に数字を入れる命名を避け、数字は識別子の末尾に置くのが最もおすすめです。
Q3. ケース変換ツールは、ハングルやCJK(中国語・日本語・韓国語)の文字をどう処理しますか?
ハングルには大文字と小文字の概念がないため、変換の対象にはならず、元の形のまま保持されます。問題になるのは単語の境界の認識です。Unicodeに完全対応した正規表現ベースの現代的な変換ツール(この「大文字・小文字/ケース変換(camelCase・snake_case)」のようなもの)は、英字とハングルの境界を、英字どうしの境界と同じように自然に認識します。一方、古い正規表現だけを使ったスクリプトでは、ハングルを空白や特殊文字のように扱ってしまい、変数名が壊れるおそれがあります。ハングルの変数名を使う場合は、必ずUnicode(UTF-8)に対応した変換ツールを使ってください。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む