
camelCase in snake_case umwandeln: Regeln für alle Schreibweisen
Inhalt
- Wann Sie Schreibweisen umwandeln müssen
- Wörter ohne Tool selbst trennen und Schreibweisen anwenden
- Umwandlungsergebnisse, die oft verwirren
- Zusammenfassung
- Technischer Hintergrund: Erkennung von Wortgrenzen per regulärem Ausdruck und Tokenizer
- Die 7 wichtigsten Schreibweisen (Casing Conventions) im Vergleich
- Die 5 häufigsten und folgenreichsten Fehler beim Umwandeln der Schreibweise
- Altlasten bereinigen: Refactoring der Namensgebung in 5 Schritten
- 7 Tipps zu Namensgebung und Schreibweise
- Entscheidungsbaum: Die passende Schreibweise finden
- Fachbegriffe im Überblick: Spickzettel für Profis (Terminologie)
- Häufig gestellte Fragen
Bei camelCase und snake_case entsteht die Verwirrung nicht, weil die Schreibweisen unbekannt wären, sondern weil man die Regeln nicht kennt: An welcher Stelle wird ein Text in Wörter zerlegt, und mit welchem Zeichen werden diese Wörter wieder verbunden?
Mit diesen Regeln lässt sich erklären, wie aus myVariableName der Bezeichner my_variable_name wird. Genauso erklärt sich, warum Texte mit Ziffern und Sonderzeichen anders zerlegt werden, als man erwartet.
Dieser Beitrag richtet sich an Entwickler, die mit Schreibweisen für Variablen- und Dateinamen arbeiten, und an alle, die Umwandlungsergebnisse selbst nachprüfen müssen.
Kurzfassung ① Wörter werden an zwei Stellen getrennt: dort, wo auf einen lateinischen Kleinbuchstaben oder eine Ziffer direkt ein Großbuchstabe folgt, und dort, wo eine Folge von Zeichen steht, die weder Buchstaben noch Ziffern noch Hangul sind. ② camelCase und PascalCase setzen die getrennten Wörter ohne Zeichen zusammen, snake_case, kebab-case und CONSTANT_CASE verbinden sie mit Unterstrich bzw. Bindestrich. ③ Title Case und die Satzschreibweise nutzen diese Regel zur Worttrennung nicht. Wenn Sie einen camelCase-Text ohne Leerzeichen einsetzen, wird er daher nicht in einzelne Wörter zerlegt.
Wann Sie Schreibweisen umwandeln müssen
In API-Dokumentationen oder Design-Spezifikationen stehen oft Namen wie „User Profile Image“, die für Menschen gut lesbar sind. Im Code lassen sich solche Namen nicht einfach übernehmen. Dort sieht es in der Praxis so aus:
- JavaScript-Variablennamen: camelCase (z. B. userProfileImage)
- Spaltennamen in Datenbanken: snake_case (z. B. user_profile_image)
- CSS Custom Properties und URL-Pfade: kebab-case (z. B. user-profile-image)
- Umgebungsvariablen: CONSTANT_CASE (z. B. USER_PROFILE_IMAGE)
Schwierig wird es, wenn Ziffern oder Abkürzungen im Namen vorkommen. Bei Texten wie getUserID oder html5Video, in denen Groß- und Kleinbuchstaben und Ziffern gemischt sind, beurteilt jeder von Hand anders, wo getrennt werden muss.
So kommt es vor, dass derselbe Name im Team mal als getUserId, mal als getUserID und mal als get_user_id geschrieben wird. Wenn Sie wissen, dass für jede Schreibweise genau festgelegt ist, wie Wörter getrennt und zusammengesetzt werden, können Sie solche Abweichungen anhand der Regeln überprüfen.
Wörter ohne Tool selbst trennen und Schreibweisen anwenden
Die Umwandlung läuft in zwei Schritten ab. Zuerst wird der Text in Wörter zerlegt, danach werden die Wörter nach der Regel der jeweiligen Schreibweise wieder zusammengesetzt. Wenn Sie diese beiden Schritte von Hand nachvollziehen, erhalten Sie auch ohne Tool dasselbe Ergebnis.
Schritt 1: Wortgrenzen finden
camelCase, PascalCase, snake_case, kebab-case und CONSTANT_CASE finden Wortgrenzen nach zwei Regeln:
- Regel 1 (Groß-/Kleinschreibung): Folgt auf einen lateinischen Kleinbuchstaben oder eine Ziffer direkt ein Großbuchstabe, wird dazwischen getrennt. myVariableName wird zu my / Variable / Name, html5Video zu html5 / Video.
- Regel 2 (Zeichen als Grenze): Steht ein einzelnes Zeichen oder eine ganze Folge von Zeichen, die weder lateinische Buchstaben noch Ziffern noch Hangul sind (Leerzeichen, Unterstriche, Bindestriche, Punkte usw.), gilt der gesamte Abschnitt als Grenze, und nur die Buchstaben links und rechts bleiben als Wörter übrig. Bei hello___world ergeben sich trotz der drei Unterstriche nur die beiden Wörter hello / world.
Title Case und die Satzschreibweise arbeiten dagegen nur ähnlich wie Regel 2: Als Wort gilt jeweils ein Block, der durch Leerzeichen oder Zeichen abgetrennt ist. Regel 1 (Groß-/Kleinschreibung) wenden sie nicht an.
Wenn Sie also einen camelCase-Text ohne Leerzeichen in Title Case umwandeln, wird getUserID nicht in Wörter zerlegt, sondern bleibt ein einziger Block, bei dem nur der erste Buchstabe groß ist (Getuserid).
Wandeln Sie denselben Text dagegen in camelCase um, wird er korrekt in die drei Wörter get / User / ID zerlegt, und das Ergebnis ist getUserId.
Schritt 2: Die getrennten Wörter nach der Regel der Schreibweise zusammensetzen
| Schreibweise | Regel zum Zusammensetzen der Wörter |
|---|---|
| GROSSBUCHSTABEN (UPPER) | Der gesamte Text wird in Großbuchstaben umgewandelt (keine Worttrennung) |
| kleinbuchstaben (lower) | Der gesamte Text wird in Kleinbuchstaben umgewandelt (keine Worttrennung) |
| Title Case | Bei jedem durch Leerzeichen oder Zeichen abgetrennten Block wird nur der erste Buchstabe großgeschrieben |
| Satzschreibweise (Sentence case) | Der gesamte Text wird kleingeschrieben, danach wird nur der erste Buchstabe des Satzes großgeschrieben |
| camelCase | Das erste Wort wird kleingeschrieben, bei den folgenden Wörtern nur der erste Buchstabe großgeschrieben, alles ohne Zeichen aneinandergehängt |
| PascalCase | Bei allen Wörtern wird der erste Buchstabe großgeschrieben, alles ohne Zeichen aneinandergehängt |
| snake_case | Alle Wörter werden kleingeschrieben und mit Unterstrich (_) verbunden |
| kebab-case | Alle Wörter werden kleingeschrieben und mit Bindestrich (-) verbunden |
| CONSTANT_CASE | Alle Wörter werden großgeschrieben und mit Unterstrich (_) verbunden |
Bei camelCase und PascalCase bedeutet „nur den ersten Buchstaben großschreiben“, dass alle übrigen Buchstaben zwangsweise in Kleinbuchstaben umgewandelt werden.
Abkürzungen wie ID oder URL, die in einem Wort bereits aus mehreren Großbuchstaben bestehen, behalten deshalb nur den ersten Buchstaben als Großbuchstaben, der Rest wird klein. Das hilft beim Nachprüfen, wie unten beschrieben.
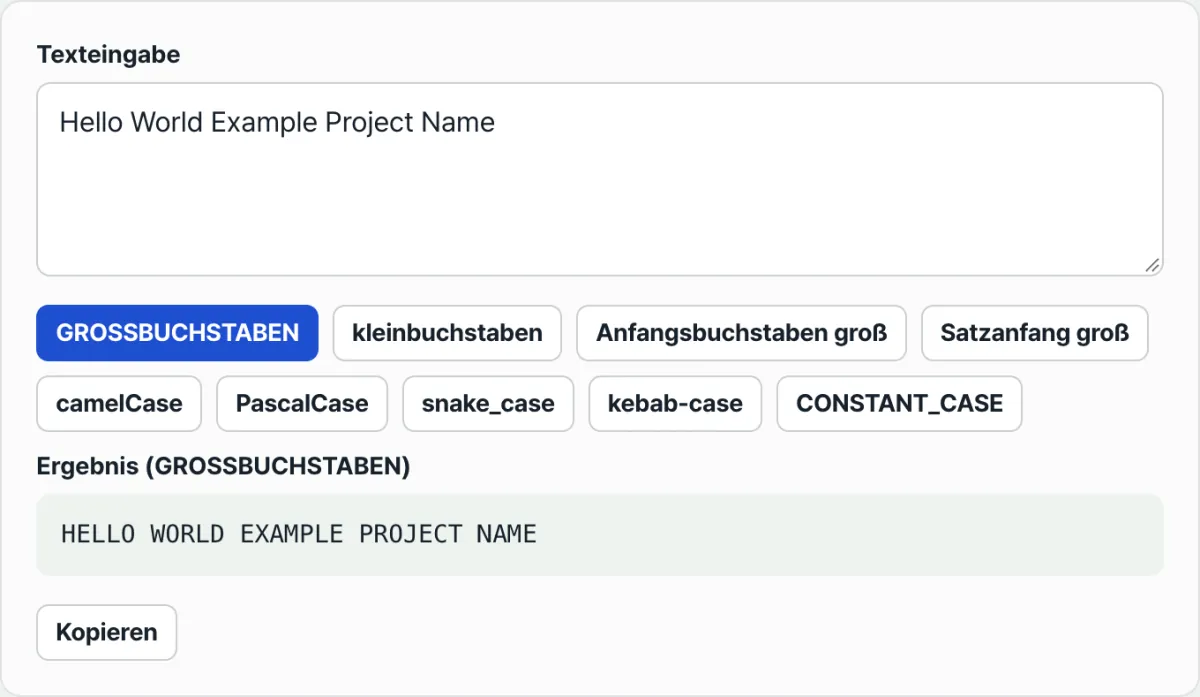
Probieren Sie es mit unserem Tool „Bezeichner umwandeln: camelCase, snake_case, kebab-case, CONSTANT_CASE“ aus.
Wandelt Text sofort in GROSSBUCHSTABEN, kleinbuchstaben, Title Case, Satzschreibweise, camelCase, PascalCase, snake_case, kebab-case und CONSTANT_CASE um. Kostenlos, ohne Installation und Anmeldung.
Umwandlungsergebnisse, die oft verwirren
Gibt man denselben Text in mehrere Schreibweisen ein, kommen manchmal Ergebnisse heraus, die sich anhand der Regeln allein schwer vorhersagen lassen. Die folgenden Fälle treten in der Praxis besonders häufig auf.
| Verwirrende Situation | Tatsächliche Regel |
|---|---|
| getUserID wird in camelCase zu getUserId, es steht also Id statt ID | Beim Zusammensetzen bleibt von jedem Wort nur der erste Buchstabe ein Großbuchstabe, alle anderen werden klein. Schreibweisen, die ganze Wörter großschreiben, wie CONSTANT_CASE (GET_USER_ID), behalten die Abkürzung unverändert bei. |
| html5Video wird nach der 5 getrennt: html5 Video | Folgt auf einen Kleinbuchstaben oder eine Ziffer direkt ein Großbuchstabe, gilt diese Stelle als Wortgrenze. Steht eine Ziffer zwischen Kleinbuchstaben (z. B. user2name), wird dort nicht getrennt. |
| myVariableName wird in Title Case nicht in einzelne Wörter zerlegt | Title Case und die Satzschreibweise erkennen nur Leerzeichen und Zeichen als Grenzen. Die Trennung nach Groß-/Kleinschreibung gilt nur für die fünf Schreibweisen der camelCase-Familie. |
Bei 이름Name, wo auf Hangul direkt ein lateinischer Großbuchstabe folgt, wird nicht getrennt | Die Regel zur Groß-/Kleinschreibung greift nur zwischen lateinischen Kleinbuchstaben bzw. Ziffern und Großbuchstaben. Hangul ist von dieser Regel nicht betroffen. |
| Bei hello___world entsteht trotz mehrerer aufeinanderfolgender Trennzeichen kein leeres Wort | Aufeinanderfolgende Zeichen werden zu einer einzigen Grenze zusammengefasst. |
Zusammenfassung
- Die Umwandlungsarten lassen sich in zwei Gruppen einteilen: Die eine behandelt den Text als Ganzes (GROSSBUCHSTABEN, kleinbuchstaben, Title Case, Satzschreibweise), die andere zerlegt ihn in Wörter und setzt diese wieder zusammen (camelCase, PascalCase, snake_case, kebab-case, CONSTANT_CASE).
- In der Gruppe mit Worttrennung wird dort getrennt, wo auf einen lateinischen Kleinbuchstaben oder eine Ziffer direkt ein Großbuchstabe folgt, und dort, wo eine Folge von Zeichen steht, die weder lateinische Buchstaben noch Ziffern noch Hangul sind.
- camelCase und PascalCase behalten von jedem Wort nur den ersten Buchstaben groß und machen den Rest klein. Abkürzungen aus aufeinanderfolgenden Großbuchstaben verlieren dadurch ihre ursprüngliche Form.
- Title Case und die Satzschreibweise erkennen keine Grenzen nach Groß-/Kleinschreibung, sondern nur Leerzeichen und Zeichen. Ein camelCase-Text ohne Leerzeichen wird deshalb nicht in einzelne Wörter zerlegt.
- Hangul kennt keine Groß- und Kleinschreibung und bleibt daher bei jeder Schreibweise unverändert.
Wandelt Text sofort in GROSSBUCHSTABEN, kleinbuchstaben, Title Case, Satzschreibweise, camelCase, PascalCase, snake_case, kebab-case und CONSTANT_CASE um. Kostenlos, ohne Installation und Anmeldung.
Technischer Hintergrund: Erkennung von Wortgrenzen per regulärem Ausdruck und Tokenizer
Hinter der scheinbar simplen Umwandlung von Schreibweisen stecken aufwendige String-Verarbeitung und die Grenzerkennung regulärer Ausdrücke (Regular Expressions). Vor allem Abkürzungen zu erhalten und die Übergänge zwischen Groß- und Kleinschreibung exakt zu erfassen, ist auch aus informatischer Sicht ein recht kniffliges Tokenisierungsproblem (Tokenization).
Lookahead und Lookbehind in regulären Ausdrücken (Lookaround)
Mit gewöhnlichen regulären Ausdrücken lässt sich eine zusammenhängende Zeichenkette nur schwer zerschneiden. Deshalb kombiniert man Lookbehind- und Lookahead-Assertions (Rückwärts- und Vorwärtssuche), um virtuelle Trenngrenzen zu erzeugen.
Das grundlegende Muster zum Aufteilen von camelCase lautet:
Regulärer Ausdruck: (?<=[a-z0-9])(?=[A-Z])
Dieses Muster trifft auf die Position zu, vor der ein Kleinbuchstabe oder eine Ziffer steht und nach der ein Großbuchstabe folgt. So wird myVariableName in my, Variable und Name zerlegt.
Problematisch wird es, wenn mehrere Abkürzungen aufeinanderfolgen. Ein Wort wie HTTPServer wird mit dem obigen Ausdruck allein nicht in HTTP und Server getrennt. Dafür kommt eine zweite Regel hinzu:
Regulärer Ausdruck: (?<=[A-Z])(?=[A-Z][a-z])
Dieses Muster trifft auf die Position zu, vor der ein Großbuchstabe steht und nach der die Kombination aus Großbuchstabe und Kleinbuchstabe folgt. Damit findet es die Grenze zwischen HTTP und Server exakt.
Die Tokenisierungs-Pipeline für Zeichenketten
Ein Konverter für Schreibweisen durchläuft in der Regel eine Pipeline mit vier Schritten:
- Normalisierung (Normalization): Leerzeichen am Anfang und Ende der Eingabe werden entfernt, aufeinanderfolgende Sonderzeichen oder Trennzeichen durch ein einzelnes Leerzeichen ersetzt.
- Zerlegung in Tokens (Split into tokens): Mit der oben beschriebenen Lookaround-Technik wird die Zeichenkette in ein Array einzelner Wörter (Tokens) zerlegt.
- Groß-/Kleinschreibung pro Token (Casing transformation per token): Die Schreibung jedes Tokens wird an die Zielschreibweise angepasst. Bei PascalCase wird etwa bei jedem Token der erste Buchstabe groß- und der Rest kleingeschrieben.
- Zusammenfügen mit Trennzeichen (Join with delimiter): Die umgewandelten Tokens werden mit dem Zieltrennzeichen wieder verbunden (leerer String, Unterstrich _, Bindestrich -).
Das Problem der Abkürzungen (Acronym Preservation Challenge)
Am meisten Kopfzerbrechen bereitet Entwicklern von Konvertern der Umgang mit Abkürzungen wie XMLHTTPRequest. Bei der Umwandlung in snake_case trennt der eine Konverter sauber zu xml_http_request. Einfache Konverter mit wenig ausgefeiltem regulärem Ausdruck machen daraus dagegen xml_httprequest oder zerlegen sie sogar in einzelne Buchstaben wie x_m_l_h_t_t_p_request. Welche Variante richtig ist, hängt von den Vorgaben der jeweiligen Sprache und den Konventionen im Team ab und sollte vorher abgestimmt werden.
Unterschiede bei den offiziellen Namenskonventionen je Sprache
Jedes Ökosystem einer Programmiersprache hat seinen eigenen offiziellen Styleguide.
- Python (PEP 8): Funktions- und Variablennamen in
snake_case, Klassennamen inPascalCase. - Java (Google Java Style Guide): Methoden und Variablen in
camelCase, Konstanten inCONSTANT_CASE. - Go (Effective Go): Für nach außen sichtbare Bezeichner (Export)
PascalCase(MixedCaps), interncamelCase. - Rust (RFC 430): Variablen und Funktionen in
snake_case, Typen und Traits inPascalCase. - TypeScript / JavaScript: Variablen und Funktionen in
camelCase, Klassen und Interfaces inPascalCase, Dateinamen häufig inkebab-case.
Die 7 wichtigsten Schreibweisen (Casing Conventions) im Vergleich
| Schreibweise | Merkmale und Aufbau | Hauptverwendung (Sprachen/Ökosysteme) | Typische Beispiele | Regex-Muster zum Trennen/Zusammenfügen |
|---|---|---|---|---|
| camelCase | Erstes Wort klein, Anfangsbuchstaben der folgenden Wörter groß, keine Leerzeichen | Variablen-/Funktionsnamen in Java, TS/JS, C# | myVariableName, getUserId | Trennen: (?<=[a-z])(?=[A-Z]), Zusammenfügen: ohne Leerzeichen |
| PascalCase | Anfangsbuchstabe jedes Wortes groß, keine Leerzeichen (UpperCamelCase) | C#, TS-Interfaces, Java-Klassen, Go-Export | MyVariableName, GetUserId | Trennen: (?<=[a-z])(?=[A-Z]), Zusammenfügen: ohne Leerzeichen |
| snake_case | Alle Wörter klein, Leerzeichen durch Unterstrich (_) ersetzt | Python-Variablen, Datenbank-Spaltennamen, Rust-Funktionen | my_variable_name, get_user_id | Mit Trennzeichen (_) per split und join |
| kebab-case | Alle Wörter klein, Leerzeichen durch Bindestrich (-) ersetzt | URL-Pfade, CSS-Eigenschaften, HTML-Tags, Ordnernamen | my-variable-name, get-user-id | Mit Trennzeichen (-) per split und join |
| CONSTANT_CASE | Alle Wörter groß, Leerzeichen durch Unterstrich (_) ersetzt (UPPER_SNAKE_CASE) | Umgebungsvariablen (.env), globale Konstanten | MY_VARIABLE_NAME, GET_USER_ID | Mit Trennzeichen (_) per split und join |
| Title Case | Anfangsbuchstabe jedes Wortes groß, Leerzeichen bleiben erhalten | Titel von Blogbeiträgen, Buchtitel, Menübeschriftungen | My Variable Name, Get User Id | Anhand von Leerzeichen ( ) den ersten Buchstaben großschreiben |
| Train-Case | Alle Wörter groß, Leerzeichen durch Bindestrich (-) ersetzt (COBOL-CASE) | Von LISP abgeleitete Sprachen, ältere Mainframe-Systeme | MY-VARIABLE-NAME, GET-USER-ID | Mit Trennzeichen (-) per split und join |
Die 5 häufigsten und folgenreichsten Fehler beim Umwandeln der Schreibweise
Diese fünf Probleme treten besonders oft auf, wenn Bezeichner von Hand umgewandelt oder fehlerhafte Skripte verwendet werden.
Verlorene Abkürzungsgrenzen durch einfache reguläre Ausdrücke (Losing Acronym Boundaries): Wandeln Sie
getURLin snake_case um und setzen mit einem simplen regulären Ausdruck vor jedem Großbuchstaben einen Unterstrich, wird darausget_u_r_l: Das Kürzel zerfällt in sinnlose Einzelbuchstaben. Ein sorgfältiger Lookaround-Ausdruck oder ein spezielles Werkzeug ist hier unverzichtbar.Trennfehler bei Mischung aus Buchstaben und Ziffern (Mixing Numbers with Letters): Bei einer Zeichenkette wie
v2Apiverhalten sich die Konverter unterschiedlich: Manche erzeugenv_2_api, anderev2_api. Ob Ziffern als eigenes Wort gelten oder als Fortsetzung der vorangehenden Zeichen, sollten Sie im Team klar festlegen.Fehlfunktion regulärer Ausdrücke bei Nicht-ASCII-Zeichen und koreanischen Zeichen: Enthält ein Bezeichner Unicode-Zeichen wie Hangul oder Emojis (zum Beispiel
get유저Info), scheitert die Worterkennung bei veralteten Konvertern, die nur das lateinische Alphabet berücksichtigen. Das Ergebnis ist dann etwaget유저infooder gleich eine Fehlermeldung.Uneinheitliche Namenskonventionen in großen Teams werden geduldet: Im selben Projekt schreibt der eine
user_id, die andereuserIdund ein Dritter sogaruser_ID. Das beeinträchtigt die Lesbarkeit des Codes erheblich und macht projektweites Refactoring oder Ersetzen per Textsuche (grep) unmöglich.Fehlende Regeln zur Groß- und Kleinschreibung bei der JSON-Serialisierung: Kommunizieren Backend (snake_case) und Frontend (camelCase) miteinander, muss die Umwandlung der Feldnamen im API-Gateway oder im DTO-Serializer (zum Beispiel Jackson, GSON, class-transformer) aktiviert sein. Andernfalls zeigt der Client
undefined-Werte an.
Altlasten bereinigen: Refactoring der Namensgebung in 5 Schritten
- Team-Styleguide festlegen und per Werkzeug durchsetzen (.editorconfig / ESLint):
Mündlich vereinbarte Konventionen nützen nichts. Legen Sie im Projektstamm eine
.editorconfigund eine.eslintrc(oder.prettierrc) an, damit die Schreibweise in der IDE aller Teammitglieder verbindlich geprüft wird. - Konsistenz der vorhandenen Bezeichner prüfen (Audit Current Identifier Consistency): Lassen Sie ein Werkzeug zur statischen Codeanalyse (zum Beispiel SonarQube) über den bestehenden Code laufen. So erkennen Sie, in welchen Modulen die Verstöße gegen die Namensregeln am gravierendsten sind, und können das Refactoring schrittweise planen.
- Middleware für die automatische Serialisierungsumwandlung einrichten: Aktivieren Sie in Frameworks wie Spring Boot oder NestJS global eine Middleware oder einen Decorator (PropertyNamingStrategy), der die Schlüssel eingehender und ausgehender JSON-Payloads automatisch umwandelt.
- Stapelweise Umbenennung mit einem speziellen Umwandlungswerkzeug (Batch Renames): Nutzen Sie die Funktion „Refactor – Rename“ Ihrer IDE oder das Werkzeug „Bezeichner umwandeln: camelCase, snake_case, kebab-case, CONSTANT_CASE“ oben auf dieser Seite, um Dutzende Variablennamen in einem Rutsch sicher umzuwandeln. Handarbeit führt zu Tippfehlern.
- Strenge Lint-Prüfungen in die CI-Pipeline einbinden (Run CI Lint Checks): Bauen Sie in Ihren CI/CD-Prozess, etwa mit GitHub Actions, einen verpflichtenden Lint-Schritt ein. Pull Requests (PR) mit Bezeichnern, die gegen die Regeln verstoßen, werden dadurch automatisch am Merge gehindert.
7 Tipps zu Namensgebung und Schreibweise
- Folgen Sie konsequent den Idiomen der Sprache und des Frameworks statt persönlichem Geschmack. Wer in Python camelCase oder in Java snake_case verwendet, belastet die Kolleginnen und Kollegen beim Lesen erheblich.
- Einigen Sie sich eindeutig auf die Schreibweise aufeinanderfolgender Großbuchstaben in Abkürzungen. Ob
HTTPRequestoderHttpRequest, obuserIDoderuserId: Halten Sie die Regel des Teams schriftlich fest. Der aktuelle Trend geht zuHttpRequest, bei dem nur der erste Buchstabe wie bei einem gewöhnlichen Wort großgeschrieben wird. - Nutzen Sie automatische Serialisierungs-Annotationen. Mit
@JsonProperty("user_id")in Java,@Expose({ name: "user_id" })in TypeScript oder dem Tagjson:"user_id"in Go bleibt im Code camelCase erhalten, und die Felder lassen sich trotzdem sauber auf snake_case in Datenbank oder API abbilden. - Verwenden Sie für URL-Pfade und REST-API-Endpunkte grundsätzlich kebab-case. Statt
/get_user_profile(falsch) oder/getUserProfile(falsch) ist/get-user-profile(richtig) hinsichtlich Suchmaschinenoptimierung (SEO) und Lesbarkeit der weltweite Standard. - Vergeben Sie CONSTANT_CASE nur für wirklich unveränderliche (immutable) Werte. Eine gewöhnliche Variable, deren Wert sich zur Laufzeit ändern kann, in Großbuchstaben mit Unterstrichen zu deklarieren, widerspricht dem semantischen Zweck einer Konstante und ist ein Anti-Pattern.
- Verstehen Sie das Prinzip der Lookaround-Ausdrücke und schreiben Sie eigene Skripte. Wenn es nicht bei einer einmaligen Umwandlung bleibt, steigert ein im Editor hinterlegtes Makro zum Ersetzen mit dem oben beschriebenen Muster
(?<=[a-z0-9])(?=[A-Z])Ihre Produktivität enorm. - Speichern Sie dieses Umwandlungswerkzeug als Lesezeichen im Browser. Wenn Sie schnell eine Datenbankabfrage schreiben oder ein DTO-Interface tippen müssen, spart es Ihnen viel Zeit gegenüber dem Umschreiben von Hand.
Entscheidungsbaum: Die passende Schreibweise finden
Wenn Sie sich fragen: „In welcher Schreibweise sollte ich diesen Variablennamen eigentlich halten?“, führt Sie der folgende Entscheidungsbaum in einer Sekunde zur Antwort.
- Handelt es sich um eine Konfigurationsdatei (.env), eine unveränderliche Konstante oder eine globale Umgebungsvariable?
- JA ➔ CONSTANT_CASE (z. B.
MAX_RETRY_COUNT) - NEIN ➔ weiter zum nächsten Punkt
- JA ➔ CONSTANT_CASE (z. B.
- Handelt es sich um einen Web-URL-Endpunkt, einen CSS-Klassennamen oder einen Verzeichnis- bzw. Dateinamen?
- JA ➔ kebab-case (z. B.
user-profile-card) - NEIN ➔ weiter zum nächsten Punkt
- JA ➔ kebab-case (z. B.
- Handelt es sich um einen Tabellen- oder Spaltennamen in einer relationalen Datenbank (RDBMS)?
- JA ➔ snake_case (z. B.
created_at) - NEIN ➔ weiter zum nächsten Punkt
- JA ➔ snake_case (z. B.
- Verwenden Sie Python, Rust, Ruby oder PHP (teilweise)?
- JA ➔ snake_case (z. B.
fetch_user_data) - NEIN (Java, JS, TS, C#, Go usw.) ➔ weiter zum nächsten Punkt
- JA ➔ snake_case (z. B.
- Handelt es sich um eine Klasse, ein Interface, einen Typ oder etwas, das in Go exportiert werden soll?
- JA ➔ PascalCase (z. B.
UserDataResponse) - NEIN (gewöhnliche Variable, Funktion, Methode, Parameter) ➔ camelCase (z. B.
fetchUserData)
- JA ➔ PascalCase (z. B.
Fachbegriffe im Überblick: Spickzettel für Profis (Terminologie)
- camelCase (Kamelschreibweise): Die Wörter werden ohne Leerzeichen aneinandergehängt. Das erste Wort beginnt mit einem Kleinbuchstaben, bei den folgenden Wörtern ist der erste Buchstabe jeweils ein Großbuchstabe. Der Name erinnert an die Höcker eines Kamels.
- PascalCase: Schreibweise, bei der jedes Wort mit einem Großbuchstaben beginnt. Wird auch UpperCamelCase genannt.
- snake_case: Der Name steht für die lange, zusammenhängende Form einer Schlange. Leerzeichen zwischen den Wörtern werden dabei durch Unterstriche (Underscore, _) ersetzt.
- kebab-case: Wie die Fleischstücke auf einem Kebab-Spieß werden die Wörter durch Bindestriche (Dash, -) verbunden. Wird vor allem in URLs und CSS verwendet.
- CONSTANT_CASE: Alle Buchstaben werden großgeschrieben und die Wörter durch Unterstriche verbunden (UPPER_SNAKE_CASE). Wird ausschließlich für Konstanten und Umgebungsvariablen verwendet.
- Lookaround in regulären Ausdrücken (Regex Lookaround): Leistungsfähige Suchfunktion in regulären Ausdrücken, die eine Bedingung prüft, ohne dass der geprüfte Teil im Ergebnis enthalten ist. Es gibt Lookahead (?=...) und Lookbehind (?<=...).
- DTO-Serialisierung (Serialization): Vorgang, bei dem Objektdaten (DTO) aus dem Arbeitsspeicher für die Übertragung über das Netzwerk oder die Speicherung in einer Datenbank in ein Format wie JSON umgewandelt werden. Dabei sind häufig Umwandlungen zwischen Schreibweisen nötig.
Häufig gestellte Fragen
Q1. Wie wandle ich Bezeichner mit aufeinanderfolgenden Großbuchstaben wie IOStream am sichersten um?
Aufeinanderfolgende Großbuchstaben in Abkürzungen sind die größte Schwachstelle klassischer camelCase-Konverter. Wandelt man IOStream in camelCase um, erzeugen manche Systeme iOStream, andere ioStream. Am sichersten und zeitgemäßesten ist es, eine Abkürzung wie ein einzelnes Wort zu behandeln und den Bezeichner als IoStream (PascalCase) oder ioStream (camelCase) zu deklarieren. Bei einer späteren automatischen Umwandlung in snake_case wird er dann sauber zu io_stream getrennt, was die Interoperabilität maximiert.
Q2. Welchen Regeln folgt die Worttrennung, wenn ein Bezeichner Ziffern enthält?
Ziffern werden je nach Werkzeug und Framework etwas unterschiedlich behandelt. In der Regel sind Ziffern den lateinischen Kleinbuchstaben gleichgestellt. Deshalb wird user2Name in user2 / Name getrennt und zu user2_name. Es gibt jedoch strenge Lint-Regeln, die eine Ziffer zwischen zwei Buchstaben (zum Beispiel bei v2Api) als eigenes Wort behandeln und daraus v_2_api machen. Um unvorhersehbares Verhalten zu vermeiden, sollten Sie Ziffern am besten gar nicht mitten im Bezeichner verwenden, sondern ans Ende stellen.
Q3. Wie gehen Konverter für Schreibweisen mit Hangul oder CJK-Zeichen (Chinesisch, Japanisch, Koreanisch) um?
Hangul kennt keine Groß- und Kleinschreibung. Die Zeichen werden daher nicht umgewandelt, sondern bleiben unverändert erhalten. Entscheidend ist die Erkennung der Wortgrenzen. Moderne, auf regulären Ausdrücken basierende Konverter mit vollständiger Unicode-Unterstützung (wie das Werkzeug auf dieser Seite) erkennen die Grenze zwischen lateinischen Buchstaben und Hangul genauso selbstverständlich wie die zwischen zwei lateinischen Buchstaben. Ältere Skripte, die nur veraltete reguläre Ausdrücke verwenden, behandeln Hangul dagegen wie Leerzeichen oder Sonderzeichen, sodass Variablennamen beschädigt werden können. Wenn Sie Variablennamen in Hangul verwenden, sollten Sie unbedingt ein Umwandlungswerkzeug einsetzen, das Unicode (UTF-8) unterstützt.
Dieser Artikel basiert auf unserem koreanischen Original. Koreanisches Original lesen