
camelCase y snake_case: reglas para dividir y unir palabras
Contenido
- Cuándo necesitas de verdad convertir entre notaciones
- Cómo dividir palabras y aplicar la notación sin herramienta
- Resultados que suelen confundir
- En resumen
- Mecanismo técnico clave: algoritmo de reconocimiento de límites con expresiones regulares y tokenizador
- Comparación y análisis de las 7 convenciones de nombres (Casing Conventions)
- Los 5 errores fatales que más se cometen al convertir entre notaciones
- Flujo de trabajo de refactorización de nombres en 5 pasos para limpiar código heredado
- 7 consejos de nomenclatura y notación
- Árbol de decisión de notaciones para elegir siempre bien
- Guía rápida de terminología técnica clave para expertos (Terminología)
- Preguntas frecuentes
La razón por la que camelCase y snake_case se confunden no está en que los nombres de las notaciones resulten extraños, sino en que no conoces la regla que determina exactamente en qué punto se corta el texto en palabras y con qué símbolos se vuelven a unir esas palabras.
En cuanto conoces esa regla, se explica todo: el proceso por el que myVariableName se convierte en my_variable_name y también por qué un texto con números y caracteres especiales se corta de una forma distinta a la que esperas.
Esto es para desarrolladores que trabajan con notaciones de variables y nombres de archivo, o para cualquiera que necesite verificar a ojo el resultado de una conversión.
Resumen ① Las palabras se cortan en el punto donde una mayúscula va justo después de una minúscula latina o de un dígito, y en los tramos donde se encadenan símbolos que no son letras, dígitos ni hangul. ② camelCase y PascalCase unen las palabras cortadas sin símbolos; snake_case, kebab-case y CONSTANT_CASE las unen con guion bajo o guion. ③ Title Case y el formato de oración no usan esta regla de separación de palabras, así que si les pasas tal cual un texto en camelCase sin espacios, no se divide palabra por palabra.
Cuándo necesitas de verdad convertir entre notaciones
En la documentación de una API o en un design spec abundan los nombres fáciles de leer para una persona, como "User Profile Image". Usar ese nombre tal cual en el código es complicado. En el código real se reparte así.
- Nombre de variable en JavaScript: camelCase (ej.: userProfileImage)
- Nombre de columna en la base de datos: snake_case (ej.: user_profile_image)
- Propiedades personalizadas de CSS y rutas de URL: kebab-case (ej.: user-profile-image)
- Variables de entorno: CONSTANT_CASE (ej.: USER_PROFILE_IMAGE)
El problema aparece cuando el nombre mezcla números o siglas. Cuando divides a mano un texto donde se alternan mayúsculas, números y minúsculas, como getUserID o html5Video, es fácil que cada persona decida un punto de corte distinto.
El resultado es que el mismo nombre acaba escrito de formas diferentes dentro del equipo: getUserId, getUserID, get_user_id. Si sabes que cada notación tiene una regla exacta para dividir y volver a unir palabras, puedes verificar esa inconsistencia con la propia regla.
Cómo dividir palabras y aplicar la notación sin herramienta
La conversión entre notaciones tiene dos pasos. Primero se corta el texto en palabras y después esas palabras se vuelven a unir según la regla de cada notación. Si sigues estos dos pasos a mano, obtienes el mismo resultado sin ninguna herramienta.
Paso 1: encontrar las fronteras entre palabras
Las cinco notaciones camelCase, PascalCase, snake_case, kebab-case y CONSTANT_CASE localizan las fronteras de palabra con dos reglas.
- Regla 1 (frontera por mayúsculas): si una mayúscula va justo después de una minúscula latina o de un dígito, se corta en ese punto. myVariableName se divide en my / Variable / Name, y html5Video en html5 / Video.
- Regla 2 (frontera por símbolos): si aparece uno o varios caracteres seguidos que no son latinos, dígitos ni hangul (espacios, guiones bajos, guiones, puntos, etc.), todo ese tramo cuenta como una sola frontera y solo quedan como palabras las letras de los lados. hello___world se divide únicamente en hello / world aunque tenga tres guiones bajos seguidos.
En cambio, Title Case y el formato de oración se parecen solo a la regla 2: consideran una sola palabra cada bloque separado por espacios o símbolos. La regla 1 (frontera por mayúsculas) no se aplica.
Por eso, si pasas tal cual a Title Case un texto en camelCase escrito sin espacios, un texto como getUserID no se divide palabra por palabra: se convierte en un único bloque con solo la primera letra en mayúscula (Getuserid).
Si cambias ese mismo texto a camelCase, se divide correctamente en tres palabras get / User / ID y queda getUserId.
Paso 2: volver a unir las palabras según la regla de cada notación
| Notación | Regla para volver a unir las palabras |
|---|---|
| Mayúsculas (UPPER) | Convierte todo el texto a mayúsculas (sin dividir en palabras) |
| Minúsculas (lower) | Convierte todo el texto a minúsculas (sin dividir en palabras) |
| Title Case | Pone en mayúscula solo la primera letra de cada bloque separado por espacios o símbolos |
| Formato de oración (Sentence) | Pasa todo a minúsculas y luego pone en mayúscula la primera letra del inicio de la oración |
| camelCase | La primera palabra en minúsculas y las siguientes con la primera letra en mayúscula, unidas sin símbolos |
| PascalCase | Todas las palabras con la primera letra en mayúscula, unidas sin símbolos |
| snake_case | Todas las palabras en minúsculas, unidas con guion bajo (_) |
| kebab-case | Todas las palabras en minúsculas, unidas con guion (-) |
| CONSTANT_CASE | Todas las palabras en mayúsculas, unidas con guion bajo (_) |
En camelCase y PascalCase, "poner en mayúscula solo la primera letra" significa forzar todas las demás letras a minúscula.
Por eso las siglas que ya tenían varias mayúsculas dentro de una palabra (ID, URL, etc.) conservan solo la primera y el resto pasa a minúsculas. Esto enlaza con el método de comprobación de abajo.
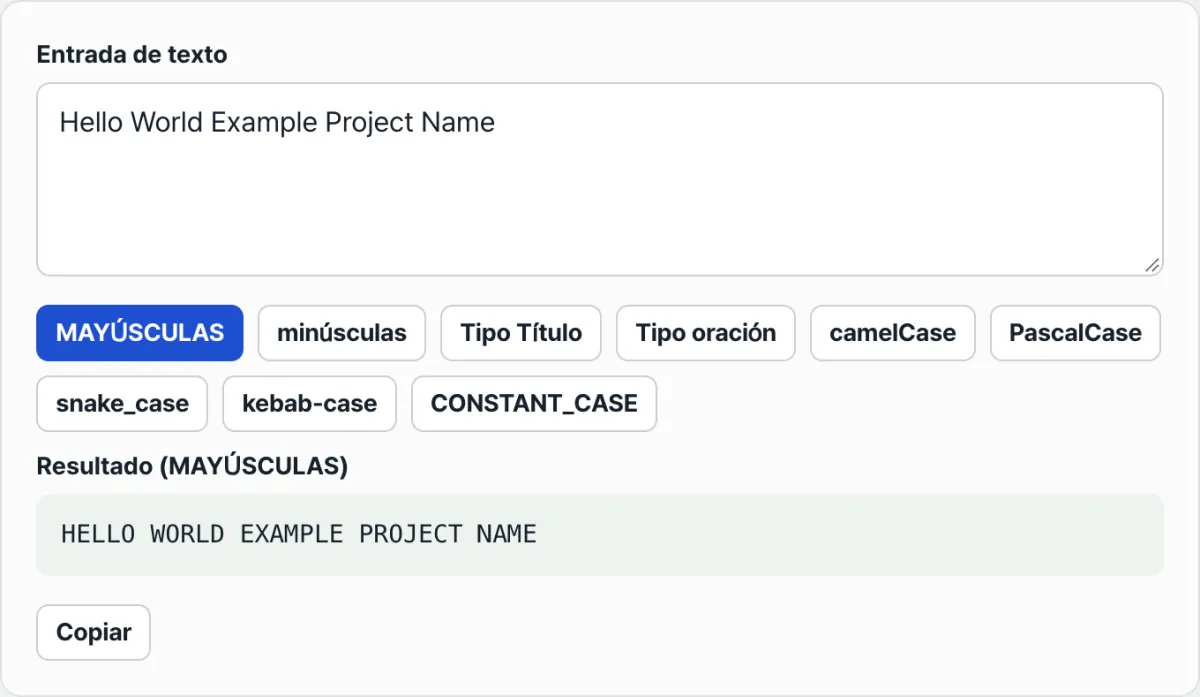
Compruébalo con nuestra herramienta gratuita, camelCase, snake_case y 9 formatos de texto en un clic.
Convierte el texto a MAYÚSCULAS, minúsculas, Title, tipo oración, camelCase, PascalCase, snake_case, kebab-case y CONSTANT_CASE al instante. Es gratis y no requiere instalación ni registro.
Resultados que suelen confundir
Cuando pasas la misma entrada por varias notaciones aparecen puntos en los que el resultado es difícil de prever solo con la regla. Estos son los casos que de verdad se dan a menudo.
| Caso que confunde | Regla real |
|---|---|
| Al convertir getUserID a camelCase queda getUserId, así que parece Id y no ID | Porque al unir las palabras solo se mantiene en mayúscula la primera letra de cada palabra y todo el resto se pasa a minúsculas. En una notación que pone la palabra entera en mayúsculas, como CONSTANT_CASE (GET_USER_ID), la sigla se mantiene tal cual. |
| html5Video se corta como html5 Video, justo después del 5 | Porque cuando una mayúscula va justo después de una minúscula o un dígito, ese punto cuenta como frontera de palabra. Si el número queda entre minúsculas (ej.: user2name), no se considera frontera. |
| Meter myVariableName en Title Case no lo divide palabra por palabra | Title Case y el formato de oración solo reconocen fronteras por espacios y símbolos. La regla que divide por mayúsculas se aplica únicamente a las cinco notaciones de la familia camelCase. |
| Que un término en hangul vaya seguido directamente de una mayúscula latina, como en «이름Name», tampoco lo corta | La regla de frontera por mayúsculas solo actúa entre una minúscula latina o un dígito y una mayúscula. El hangul no entra en esa regla. |
| Aunque haya varios separadores seguidos, como en hello___world, no aparecen palabras vacías | Porque los símbolos consecutivos se agrupan y se tratan como una sola frontera. |
En resumen
- La conversión se divide en dos grandes grupos: los que tratan el texto entero de golpe (Mayúsculas, Minúsculas, Title Case, formato de oración) y los que separan en palabras y las vuelven a unir (camelCase, PascalCase, snake_case, kebab-case, CONSTANT_CASE).
- Las que separan en palabras cortan en el punto donde una mayúscula va justo después de una minúscula latina o de un dígito, y en los tramos de símbolos seguidos que no son latinos, dígitos ni hangul.
- camelCase y PascalCase conservan solo la primera letra de cada palabra y pasan el resto a minúsculas, así que las siglas de mayúsculas consecutivas pierden su forma original.
- Title Case y el formato de oración no reconocen las fronteras por mayúsculas y solo usan espacios y símbolos como frontera, así que si les pasas un texto en camelCase sin espacios no se divide palabra por palabra.
- El hangul no distingue mayúsculas y minúsculas, así que se queda igual sea cual sea la notación que elijas.
Convierte el texto a MAYÚSCULAS, minúsculas, Title, tipo oración, camelCase, PascalCase, snake_case, kebab-case y CONSTANT_CASE al instante. Es gratis y no requiere instalación ni registro.
Mecanismo técnico clave: algoritmo de reconocimiento de límites con expresiones regulares y tokenizador
Detrás de una conversión de mayúsculas y minúsculas que parece sencilla se esconden el procesamiento de cadenas y los mecanismos de reconocimiento de límites de las expresiones regulares. En particular, conservar las siglas y detectar con precisión los puntos en los que cambia el uso de mayúsculas y minúsculas es un problema de tokenización (tokenization) bastante complejo, incluso desde el punto de vista de las ciencias de la computación.
Búsqueda anticipada y retrospectiva en expresiones regulares (Lookaround)
Con una expresión regular común no es fácil dividir una cadena de texto continua. Por eso se combinan aserciones Lookbehind (búsqueda retrospectiva) y Lookahead (búsqueda anticipada) para crear límites de separación virtuales.
El patrón de expresión regular más básico para dividir camelCase es el siguiente.
Expresión regular: (?<=[a-z0-9])(?=[A-Z])
Este patrón coincide con la posición que queda justo entre una letra minúscula o un dígito y una letra mayúscula que viene después. Así, myVariableName se divide en my, Variable y Name.
Sin embargo, surge un problema cuando hay siglas consecutivas. Una palabra como HTTPServer no se separa en HTTP y Server solo con la expresión regular anterior. Para ello se añade una segunda regla.
Expresión regular: (?<=[A-Z])(?=[A-Z][a-z])
Este patrón coincide con la posición que queda entre una letra mayúscula y una combinación de mayúscula y minúscula que viene después, y localiza con exactitud el límite entre HTTP y Server.
Proceso de tokenización (Tokenization) de cadenas
Los conversores de formato de mayúsculas y minúsculas suelen atravesar un proceso de cuatro etapas.
- Normalización: elimina los espacios al principio y al final de la cadena de entrada, y sustituye los caracteres especiales o separadores consecutivos por un único espacio.
- División en tokens: usa la técnica de Lookaround de expresiones regulares mencionada antes para dividir la cadena en una lista de palabras independientes (tokens).
- Conversión de mayúsculas y minúsculas por token: fuerza el cambio de mayúsculas y minúsculas de cada token según la notación de destino. En PascalCase, por ejemplo, convierte en mayúscula la primera letra de todos los tokens y en minúscula el resto.
- Unión con delimitadores: vuelve a unir los tokens transformados con el delimitador de destino (cadena vacía, guion bajo _, guion -).
El reto de conservar las siglas (Acronym Preservation Challenge)
Uno de los aspectos que más complica a los desarrolladores de conversores es el tratamiento de siglas como XMLHTTPRequest. Al convertirla a snake_case, algunos conversores la separan de forma inteligente en xml_http_request, pero los conversores simples cuya expresión regular no es lo bastante precisa pueden acabar uniéndolo todo en xml_httprequest o incluso fragmentarla letra por letra como x_m_l_h_t_t_p_request. Antes de nada, el equipo debe acordar qué enfoque es el correcto según las especificaciones de codificación de cada lenguaje y las convenciones del propio equipo.
Diferencias entre las convenciones de nombres oficiales de cada lenguaje
Cada ecosistema de lenguaje de programación cuenta con su propia guía de estilo oficial.
- Python (PEP 8): los nombres de funciones y variables usan
snake_case, y los de clases,PascalCase. - Java (Google Java Style Guide): los métodos y las variables usan
camelCase, y las constantes,CONSTANT_CASE. - Go (Effective Go): al exportar fuera del paquete se usa
PascalCase(MixedCaps); dentro del paquete,camelCase. - Rust (RFC 430): las variables y las funciones usan
snake_case, y los tipos y los traits,PascalCase. - TypeScript / JavaScript: las variables y las funciones usan
camelCase, las clases y las interfaces usanPascalCase, y los nombres de archivo suelen usarkebab-case.
Comparación y análisis de las 7 convenciones de nombres (Casing Conventions)
| Nombre de la notación | Características y estructura | Usos principales (lenguaje/ecosistema) | Ejemplos representativos | Patrón de división/unión con expresiones regulares |
|---|---|---|---|---|
| camelCase | La primera palabra va en minúscula; la primera letra de las palabras siguientes va en mayúscula; sin espacios | Nombres de variables y funciones en Java, TS/JS y C# | myVariableName, getUserId | División: (?<=[a-z])(?=[A-Z]); unión: sin espacios |
| PascalCase | La primera letra de todas las palabras va en mayúscula; sin espacios (UpperCamelCase) | Interfaces de C# y TS, clases de Java, exportaciones de Go | MyVariableName, GetUserId | División: (?<=[a-z])(?=[A-Z]); unión: sin espacios |
| snake_case | Todas las palabras en minúscula; los espacios se sustituyen por guiones bajos (_) | Variables de Python, nombres de columnas de bases de datos, funciones de Rust | my_variable_name, get_user_id | División y unión con el delimitador (_) |
| kebab-case | Todas las palabras en minúscula; los espacios se sustituyen por guiones (-) | Rutas de URL, propiedades CSS, etiquetas HTML, nombres de carpetas | my-variable-name, get-user-id | División y unión con el delimitador (-) |
| CONSTANT_CASE | Todas las palabras en mayúscula; los espacios se sustituyen por guiones bajos (_) (UPPER_SNAKE_CASE) | Variables de entorno (.env), configuración de constantes globales | MY_VARIABLE_NAME, GET_USER_ID | División y unión con el delimitador (_) |
| Title Case | La primera letra de cada palabra va en mayúscula; se mantienen los espacios | Títulos de entradas de blog, títulos de libros, etiquetas de menús | My Variable Name, Get User Id | Primera letra en mayúscula, usando el espacio ( ) como separador |
| Train-Case | Todas las palabras en mayúscula; los espacios se sustituyen por guiones (-) (COBOL-CASE) | Lenguajes derivados de LISP, sistemas mainframe antiguos | MY-VARIABLE-NAME, GET-USER-ID | División y unión con el delimitador (-) |
Los 5 errores fatales que más se cometen al convertir entre notaciones
Estos son los 5 problemas que aparecen con más frecuencia durante el desarrollo cuando conviertes notaciones a mano o usas un script defectuoso.
Colapso de los límites de las siglas por usar una regex simple (Losing Acronym Boundaries): Cuando pasas
getURLa snake_case, si usas una regex que simplemente mete un guion bajo delante de cada mayúscula, acabas con un desastre comoget_u_r_l, troceado en letras sueltas sin ningún sentido. Es imprescindible usar una regex con lookaround bien construida o una herramienta específica.Errores de separación al mezclar letras y números (Mixing Numbers with Letters): Al convertir la cadena
v2Api, cada conversor actúa a su manera: unos producenv_2_apiy otrosv2_api. El equipo necesita una regla clara sobre si los números son palabras independientes o una continuación de la cadena anterior.Fallo de las regex con caracteres no ASCII y coreano: Con identificadores que mezclan caracteres Unicode, como hangul o emojis (por ejemplo,
getUsuarioInfoescrito con caracteres coreanos), los conversores antiguos basados solo en el alfabeto latino no reconocen los límites y devuelven resultados absurdos comogetusuarioinfoo directamente fallan con un error.Convenciones de nomenclatura fragmentadas y sin control en equipos grandes: En un mismo proyecto unos escriben
user_id, otrosuserIdy hastauser_ID. Eso daña gravemente la legibilidad del código e impide refactorizar de forma global o reemplazar texto mediante la búsqueda (grep).Falta de reglas de conversión de mayúsculas al serializar JSON (Serialization): Cuando el backend (snake_case) y el frontend (camelCase) se comunican, si no activas la opción de conversión de nombres de campo en la pasarela de API intermedia o en el serializador del DTO (por ejemplo, Jackson, GSON, class-transformer), el cliente acabará renderizando valores undefined.
Flujo de trabajo de refactorización de nombres en 5 pasos para limpiar código heredado
- Definir la guía de estilo del equipo y automatizarla (.editorconfig / ESLint):
Una convención hablada no sirve de nada. Configura en la raíz del proyecto
.editorconfigy.eslintrc(o.prettierrc) para que el IDE de cada persona del equipo aplique la notación de forma obligatoria. - Auditar la coherencia actual de los identificadores (Audit Current Identifier Consistency): Pasa una herramienta de análisis estático (SonarQube, etc.) por el código base. Identifica en qué módulos las violaciones de las reglas de nomenclatura son más graves y traza un plan de refactorización progresiva.
- Configurar un middleware de conversión automática en la serialización: Activa de forma global, en el propio framework (Spring Boot, NestJS, etc.), un middleware o decorador (PropertyNamingStrategy) que convierta automáticamente las claves de los payloads JSON de entrada y de salida.
- Renombrar en lote con una herramienta específica de conversión de casos (Batch Renames): Aprovecha la función Refactor - Rename del IDE o la herramienta de conversión de casos que tienes al principio de esta página para cambiar decenas de nombres de variables de una vez y sin riesgos. Hacerlo a mano provoca erratas.
- Conectar comprobaciones de lint potentes al pipeline de CI (Run CI Lint Checks): Añade un paso obligatorio de lint en el proceso de CI/CD, por ejemplo en GitHub Actions, para que cualquier PR (Pull Request) con identificadores fuera de la norma quede bloqueado automáticamente y no se pueda fusionar (merge).
7 consejos de nomenclatura y notación
- Sigue siempre la convención del lenguaje y del framework antes que tu gusto personal. Usar camelCase en Python o snake_case en Java genera una carga cognitiva enorme a tus compañeros.
- Acuerda con claridad cómo se escriben las siglas en mayúsculas consecutivas. Hay que dejar por escrito si el equipo usa
HTTPRequestoHttpRequest,userIDouserId. La tendencia actual prefiereHttpRequest, con solo la primera letra en mayúscula, como una palabra normal. - Aprovecha los decoradores de serialización automática. Con
@JsonProperty("user_id")en Java,@Expose({ name: "user_id" })en TS o la etiquetajson:"user_id"en Go mantienes el camelCase dentro del código y a la vez mapeas a la perfección con el snake_case de la base de datos o de la API. - Usa siempre kebab-case en las rutas URL y en los endpoints de la API REST.
/get_user_profile(X) y/getUserProfile(X) quedan por detrás de/get-user-profile(O): ese formato es el estándar global tanto para la optimización para buscadores (SEO) como para la legibilidad. - Reserva CONSTANT_CASE solo para valores realmente inmutables (Immutable). Declarar en mayúsculas con guion bajo una variable normal que puede cambiar en tiempo de ejecución va contra el propósito semántico de una constante: es un antipatrón.
- Entiende cómo funcionan las regex con lookaround y escribe tu propio script. Si la conversión no es algo puntual, registra en tu editor una macro de sustitución con el patrón
(?<=[a-z0-9])(?=[A-Z])que vimos antes y tu productividad se disparará. - Guarda la herramienta "camelCase, snake_case y 9 formatos de texto en un clic" en los marcadores del navegador. Cuando tengas que escribir a toda prisa una consulta de base de datos o una interfaz DTO, será la mejor utilidad para recortar drásticamente el tiempo que pierdes cambiando los nombres a mano.
Árbol de decisión de notaciones para elegir siempre bien
Cuando te preguntes "¿en qué notación se escribe este nombre de variable?", sigue este árbol de decisión y tendrás la respuesta en un segundo.
- ¿Es un archivo de configuración (.env), una constante inmutable o una variable de entorno global?
- SÍ ➔ CONSTANT_CASE (ej.:
MAX_RETRY_COUNT) - NO ➔ Pasa al siguiente punto
- SÍ ➔ CONSTANT_CASE (ej.:
- ¿Es un endpoint de URL web, un nombre de clase CSS o un nombre de directorio/archivo?
- SÍ ➔ kebab-case (ej.:
user-profile-card) - NO ➔ Pasa al siguiente punto
- SÍ ➔ kebab-case (ej.:
- ¿Es el nombre de una tabla o de una columna de una base de datos relacional (RDBMS)?
- SÍ ➔ snake_case (ej.:
created_at) - NO ➔ Pasa al siguiente punto
- SÍ ➔ snake_case (ej.:
- ¿El lenguaje que usas es Python, Rust, Ruby o PHP (en parte)?
- SÍ ➔ snake_case (ej.:
fetch_user_data) - NO (Java, JS, TS, C#, Go, etc.) ➔ Pasa al siguiente punto
- SÍ ➔ snake_case (ej.:
- ¿Es una clase, una interfaz, un tipo o un identificador exportado de Go?
- SÍ ➔ PascalCase (ej.:
UserDataResponse) - NO (variable normal, función, método, parámetro) ➔ camelCase (ej.:
fetchUserData)
- SÍ ➔ PascalCase (ej.:
Guía rápida de terminología técnica clave para expertos (Terminología)
- camelCase: Las palabras se escriben sin espacios, con la primera palabra en minúscula y la inicial de cada palabra siguiente en mayúscula. El nombre viene de su parecido con las jorobas de un camello.
- PascalCase: Todas las palabras empiezan con mayúscula. También se conoce como UpperCamelCase.
- snake_case: La idea es que la cadena se alargue como una serpiente: los espacios se sustituyen por guiones bajos (underscore, _).
- kebab-case: Como un kebab ensartado en una brocheta, las palabras se unen con guiones (dash, -). Se usa sobre todo en URL y CSS.
- CONSTANT_CASE: Todo se escribe en mayúsculas y las palabras se unen con guiones bajos (UPPER_SNAKE_CASE). Se limita a constantes y variables de entorno.
- Lookaround en expresiones regulares (Regex Lookaround): Función de búsqueda muy potente que comprueba condiciones sin incluir el resultado. Existe el lookahead (?=...) y el lookbehind (?<=...).
- Serialización de DTO (Serialization): Proceso de convertir los datos de un objeto en memoria (DTO) a un formato como JSON para enviarlos por la red o guardarlos en la base de datos. En ese paso se producen conversiones de notación con frecuencia.
Preguntas frecuentes
Q1. ¿Cuál es la forma más segura de convertir identificadores con siglas en mayúsculas consecutivas, como IOStream?
Las siglas en mayúsculas consecutivas son el punto más frágil de los conversores tradicionales de camelCase. Al pasar IOStream a camelCase, algunos sistemas producen iOStream y otros ioStream. El enfoque más seguro y moderno consiste en tratar la sigla como una palabra más y declarar IoStream (PascalCase) o ioStream (camelCase). Así, cuando más adelante se convierta automáticamente a snake_case, quedará separado limpiamente como io_stream y la interoperabilidad será máxima.
Q2. Si un identificador incluye números, ¿qué reglas sigue la separación de palabras?
El tratamiento de los números varía sutilmente según la herramienta y el framework. Por lo general, un número tiene el mismo estatus que una letra minúscula. Por eso user2Name se separa como user2 / Name y queda user2_name. Sin embargo, hay reglas de lint estrictas que, cuando hay letras a ambos lados (por ejemplo, v2Api), tratan el número como una palabra independiente y lo cortan como v_2_api. Para reducir la imprevisibilidad, lo más recomendable es evitar poner números en medio del identificador y colocarlos al final.
Q3. ¿Cómo tratan los conversores de notación el hangul o los caracteres CJK (chino, japonés y coreano)?
El hangul en sí no tiene concepto de mayúsculas y minúsculas, así que no es objeto de conversión y se conserva tal cual. El problema está en reconocer los límites entre palabras. Los conversores modernos basados en expresiones regulares con soporte completo de Unicode (como la herramienta de esta página) reconocen el límite entre una letra latina y el hangul igual que entre dos letras latinas. En cambio, los scripts antiguos que solo usan expresiones regulares obsoletas tratan el hangul como un espacio o un carácter especial, y corren el riesgo de destrozar el nombre de la variable. Si vas a usar nombres de variables en hangul, usa siempre una herramienta de conversión compatible con Unicode (UTF-8).
Este artículo está adaptado de nuestro original en coreano. Leer el original en coreano