
JSON null値の削除方法と消える値・残る値
目次
API レスポンスや設定ファイルに紛れ込んだ null、空文字列("")、空配列([])、空オブジェクト({})をまとめて取り除きたい場合、押さえておくべき判定ルールは実質ひとつだけです。どの値を「空」とみなすのか、そしてその判定が内側の値から外側へ向かう順序で適用される、という点です。この記事では、そのルールをコードに沿ってそのまま説明します。
要約 ① 削除されるのは空文字列、null、undefined、空配列、空オブジェクトだけで、0 と false、空でない文字列はそのまま残ります。 ② 子の値を先に整理してから親を判定するため、ネストしたオブジェクトが空になると、上の階層でも一緒に削除されます。 ③ 標準の JSON.parse を使うので、末尾カンマ・引用符のないキー・リテラルの undefined があると、処理そのものが拒否されます。
なぜこのような整理が必要になるのか
API レスポンスの JSON をファイルに保存して次回の実行で再利用したり、複数のリクエスト結果をまとめてログに残したりすることがあります。このとき、任意項目が空だと、レスポンスにはその位置に null や空文字列、空配列がそのまま入って返ってきます。
ファイルが増えるにつれて、実際に値のあるキーより空のキーのほうが多くなることもあります。こうしたファイルを diff で比較したり目で追ったりするとき、空の値が画面を埋めていると、本当に見たい値を探しにくくなります。
厄介なのは、空の値が最上位にしかないわけではない点です。ネストしたオブジェクトの中や、配列内のオブジェクトの中にさらに入れ子になっていることも多く、1 階層ずつ手で消していくと、消し忘れが出たり構造を壊したりしやすくなります。
ツールを使わずに自分で整理する方法
この整理ルールは特別なものではなく、再帰関数ひとつで表現できます。ブラウザーの開発者ツールのコンソールにそのまま貼り付ければ、ツールを使わなくても同じ結果が得られます。
function isEmpty(v) {
  if (v === "" || v === null || v === undefined) return true;
  if (Array.isArray(v) && v.length === 0) return true;
  if (v && typeof v === "object" && Object.keys(v).length === 0) return true;
  return false;
}

function cleanValues(value) {
  if (Array.isArray(value)) {
    return value.map(cleanValues).filter((v) => !isEmpty(v));
  }
  if (value !== null && typeof value === "object") {
    const result = {};
    for (const [key, val] of Object.entries(value)) {
      const cleaned = cleanValues(val);
      if (!isEmpty(cleaned)) result[key] = cleaned;
    }
    return result;
  }
  return value;
}

const data = JSON.parse(元のJSON文字列);
console.log(JSON.stringify(cleanValues(data), null, 2));
手順だけ整理すると次のとおりです。
- 元の JSON 文字列を JSON.parse でパースします。文法が間違っているとこの段階でエラーになるため、まず文法エラーがないかを確認しておく必要があります。
- 配列の場合は、各要素を先に再帰的に整理し、整理後の結果が空文字列・null・undefined・空配列・空オブジェクトである要素だけを除外します。
- オブジェクトの場合は、各プロパティの値を先に再帰的に整理し、整理後の値が同じ基準で空であれば、そのキー自体を結果のオブジェクトから外します。
- 配列でもオブジェクトでもない値(文字列、数値、真偽値)は、そのまま通します。0 と false はこの判定基準のどれにも当てはまらないため、そのまま残ります。
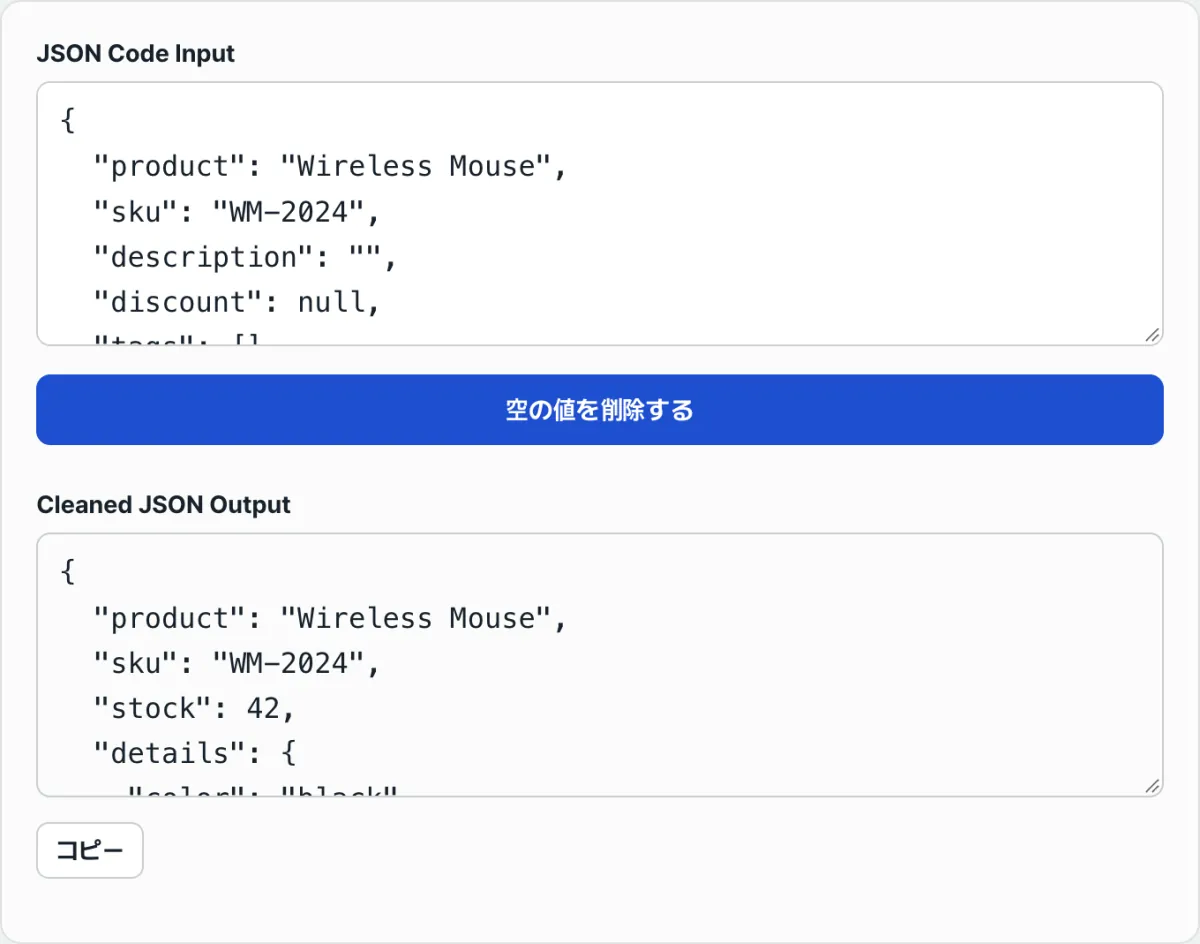
Dynamic Labs の無料ツール「JSON空データクリーナー」でも確認できます。
登録やインストールは不要です。JSONを貼り付けるだけで、空の値をすぐに整理できます。
間違えやすいポイント
判定基準は漠然と「空に見える値」ではなく、決まった一覧に当てはまる値だけが削除対象になります。下の表にまとめました。
| 値 | 処理結果 |
|---|---|
| "" (空文字列) | 削除 |
| null | 削除 |
| undefined | 削除 |
| [] (空配列) | 削除 |
| {} (空オブジェクト) | 削除 |
| 0 | 残す |
| false | 残す |
| " " (半角スペース 1 つ) | 残す (空文字列ではない) |
| "0" (文字列) | 残す |
0 と false が残るのは、判定関数が値を "" 、null、undefined、空配列、空オブジェクトの 5 つとだけ比較しているためです。0 と false はこの 5 つのどれにも属さないので、判定をそのまま通過します。
スペース 1 つ(" ")も同様です。空文字列("")と、1 文字入っている文字列は別の値なので、スペースだけの文字列は削除されず、そのまま残ります。
出力がまったく表示されず、赤いエラーメッセージだけが出る場合は、整理ルールとは関係なく、入力そのものが有効な JSON の文法になっていません。よくある原因は次のとおりです。
- 最後の要素の後ろにカンマが残っている(末尾カンマ):
{"a": 1,} - キーを引用符で囲んでいない:
{a: 1} - 値として undefined リテラルを直接書いている:
{"a": undefined}— JSON には undefined という値自体がなく、有効なのは null だけです - 文字列やキーをシングルクォートで囲んでいる:
{'a': 'b'}
JSON.parse は、JavaScript のオブジェクトリテラルよりも厳格な標準仕様です。これらのうちひとつでも混ざっていると、パースの段階で止まってエラーになり、空の値を取り除くロジック自体が実行されません。
まとめ
- 削除対象は正確に 5 種類です。空文字列、null、undefined、空配列、空オブジェクトです。
- 0、false、スペースを含む空でない文字列・配列・オブジェクトは、そのまま残ります。
- 整理は子の値から親の順に進むため、子が取り除かれて親が空オブジェクトになると、親も次の段階で一緒に削除されます。
- 入力は標準の JSON.parse で検証されるので、末尾カンマ・引用符のないキー・undefined リテラルがあると、整理の前にエラーが表示されます。
登録やインストールは不要です。JSONを貼り付けるだけで、空の値をすぐに整理できます。
技術の仕組み: 再帰的なツリー走査と値の判定ロジック
単純な文字列置換(Replace)や正規表現(Regex)だけでは、深さが予測できないネストしたJSONの空の値を完全に取り除くことはできません。JSONデータが本質的にツリー(Tree)構造をしているためです。ここでは、JSON空データクリーナーのような道具の内部で動くアルゴリズムと計算量、そして標準規格による制約を詳しく見ていきます。
1. ツリー走査アルゴリズム(Tree Traversal Algorithms)
JSONデータを整理するうえで最も重要な考え方が、再帰的な後行順走査(Bottom-up Post-order Traversal)です。
- ボトムアップの後行順走査(Bottom-Up)が必須な理由: 子ノードを先に評価・処理し、その結果をもとに親ノードを評価する方式です。'cleanValues(child) -> isEmpty(cleanedChild)'の順で実行されます。 たとえば '{"parent": {"child": {"grandchild": ""}}}' というデータがあるとします。いちばん内側の 'grandchild' は空文字列なので削除されます。すると 'child' オブジェクトは空オブジェクト '{}' になります。次に 'child' を評価すると空オブジェクトなので、これも削除されます。結果として 'parent' も空オブジェクトになり、最終的にすべての殻がきれいに消えます。
- トップダウンの先行順走査(Pre-order Traversal)の限界: 親を先に評価する方式です。上の例で最初に 'parent' や 'child' を調べる時点では、内部にキーが存在するため「空ではない」と誤判定してしまいます。あとから子の値を消すと親は空オブジェクトとして残りますが、親の評価はすでに終わっているため、意味のない空の殻のオブジェクトがそのまま残るという致命的な欠陥が生じます。
2. 値を見分けるための厳密なロジック(Value Discrimination Logic)
Falsyな値だからといって無条件に削除してはいけません。アプリケーションのビジネスロジックに影響しない「本当に意味のない空の値」だけを選び出す必要があります。
- 削除(枝刈り)の対象(Pruned values):
- '""'(空文字列)
- 'null'
- 'undefined'(JSONのパース後に内部でオブジェクトを操作した際に発生することがあります)
- '[]'(要素が1つもない空配列)
- '{}'(キーが1つもない空オブジェクト)
- 必ず残すべき値(Preserved falsy primitives):
- '0'(数値の0は、銀行残高、数量、インデックスなど非常に重要なデータです)
- 'false'(真偽値のfalseは、権限なし、無効化、未決済といった明確な状態を表します)
- '" "'(空白だけの文字列は、意図的に入力されたスペースの可能性があります)
3. 時間計算量と空間計算量(Time & Space Complexity)
- 時間計算量: O(N) — ここで N はJSONツリー内の全ノード(キーと値のペア)の数です。すべてのノードをちょうど1回ずつ走査して検査するため、データサイズに比例して線形に増加します。
- 空間計算量: O(D) — ここで D はツリーの最大ネスト深度(Maximum Nesting Depth)です。再帰関数が呼び出されるたびにコールスタックが積み上がるため、非常に深いJSONではコールスタックオーバーフローが起こる可能性があります。ただし、一般的なAPIレスポンスの深さは10階層を超えないので、実務ではとても安全かつ高速に動作します。
4. RFC 8259(JSON標準規格)による制約
このクリーニングアルゴリズムの最初の段階には、必ず 'JSON.parse()' を置く必要があります。RFC 8259 は、データ交換の整合性を守るために非常に厳格な文法を求めています。 JavaScriptでは許容されても、標準JSONでは決して許されない(SyntaxErrorの原因になる)要素は次のとおりです。
- 配列やオブジェクトの最後の要素の後ろに付くカンマ(Trailing commas)
- 文字列やオブジェクトのキーを囲むシングルクォート(''')
- クォートなしで書かれたオブジェクトのキー
- 'NaN'、'Infinity'、'-Infinity' といった特殊な数値リテラル
- 'undefined' キーワードの直接使用
そのため、確実にクリーニングするには、規格に沿ってシリアライズされた文字列を受け取り、パースする工程を必ず最初に行う必要があります。
状況別 JSONクリーニング手法の比較表(Comparison Table)
さまざまな環境やライブラリでJSONの空の値を取り除く方法について、長所と短所、対応範囲をひと目で比較できるようにまとめました。
| 比較項目 | Pure Recursive JS(おすすめ) | JSON.stringify(obj, replacer) | Lodash (_.omitBy / _.pickBy) | jqシェルフィルタ(CLI環境) |
|---|---|---|---|---|
| 動作原理 | 完全な後行順走査の再帰アルゴリズム | シリアライズ中にフィルタリング | 浅い階層のオブジェクトプロパティをフィルタリング | 'walk' 関数によるツリー走査 |
| ネストした空の親の削除 | ✅ 完全対応(Bottom-Up) | ❌ 不可(Top-Down方式の限界) | ❌ 不可(1階層のみ適用) | ✅ 完全対応(walk関数の再帰) |
| 0とfalseの保持 | ✅ 完全対応(明示的な型チェック) | ✅ 対応(条件付きで処理可能) | ⚠️ 注意が必要(_.identity を使うと失われる) | ✅ 完全対応('!= null') |
| 配列内の空要素の処理 | ✅ きれいにフィルタリングして詰める | ⚠️ 'null' に置き換わる(配列の長さは維持) | ❌ 配列要素には適用不可 | ✅ 'map' と 'select' で可能 |
| 処理速度・性能 | 非常に高速(O(N) の線形探索) | 高速(ネイティブC++エンジンで最適化) | やや遅い(ライブラリのオーバーヘッド) | 高速(Cベースのコンパイル済みバイナリ) |
| 向いている環境 | ブラウザのフロントエンド、Node.jsのバックエンド | ログの整形、単純な1次元データ | すでにLodashを依存関係に含むプロジェクト | サーバーへのSSH接続、Bashシェルスクリプトでの自動化 |
上の表のとおり、'JSON.stringify' の第2引数である 'replacer' 関数はトップダウンで動作するため、子が削除されて空になった親オブジェクトを検出して消すことができません。また、配列の要素を消そうとしても完全に消えるのではなく、'null' で埋められてしまうという制約があります。したがって、データの整合性という点では、再帰的なカスタム関数(Pure Recursive JS)方式が圧倒的に優れています。
ありがちな致命的ミス5つ
経験豊富なシニア開発者でも、エッジケースを見落としてサービスに大きな打撃を与えるミスをしてしまうことがあります。
- 単純なTruthy/Falsy判定('if (!value)')の多用 JavaScriptの柔軟な型変換を信用して 'if (!value)' で判定すると、データベース上の数値 '0'(例: 残高0ウォン)や 'false'(例: マーケティング情報の受信を拒否)がまとめて消えてしまい、ビジネスロジックが崩れます。
- トップダウン(Top-Down)のフィルタリングで空の殻のオブジェクトが残る 親オブジェクトを先に検査するロジックを組むと、子ノードの空の値が削除された結果として生まれる新しい空の親オブジェクト('{ "user": {} }')を処理できず、ペイロードの軽量化に失敗します。
- 元のオブジェクトを直接変更(In-place Mutation)して副作用(Side Effect)を招く 再帰関数の中で 'delete obj[key]' を使って元のオブジェクトを直接書き換えると、アプリケーションの別のモジュールがそのオブジェクトを参照している場合に、予期しないメモリ参照エラーや状態の不整合によるバグが発生します。常に新しいオブジェクトを返し、イミュータビリティ(Immutability)を保つ必要があります。
- 循環参照(Circular Reference)への対策がない オブジェクトAがオブジェクトBを参照し、BもAを参照する構造(例: 双方向のORMモデル)をクリーニング関数に渡すと、関数が止まらずに再帰を繰り返し、'Maximum call stack size exceeded' エラーを吐いてNode.jsサーバー全体が停止してしまいます。
- 例外処理のないまま JSON.parse() を実行する 外部から入ってきたテキストを検証せずに 'JSON.parse()' に渡し、構文エラー(Syntax Error)が起きると、アプリケーションがクラッシュします。必ず 'try-catch' ブロックで囲むか、安全なラッパー関数を使いましょう。
実務の生産性を高める5ステップのプロダクションレベル・ワークフロー
単なるクリーニングにとどまらず、エンタープライズ環境で安全にJSONを加工・保存するための、体系的な5ステップのパイプラインです。
- ステップ1: スキーマと文法の事前検証 (Syntax Validation)
まず、受け取った文字列データが RFC 8259 の規格に準拠しているかを
try-catchでパースして確認します。必要に応じて、AjvやZodといったスキーマバリデーターでデータの基本構造が想定どおりかを調べ、第一の防御ラインを築きます。 - ステップ2: ボトムアップ再帰クリーニング(Bottom-Up Pruning)の実行
本文で紹介した
cleanValuesのような再帰関数を呼び出し、意味のないnull、""、[]、{}のノードを、深い階層から順にきれいに取り除きます。 - ステップ3: 重要なFalsyデータ(
0、false)が保持されているかの整合性チェック クリーニング後のオブジェクトから、ビジネス上重要な 0 や false の値が失われていないかを、単体テスト(Unit Test)で検証します。特に金融や認証に関わるペイロードでは、このステップを省略しないでください。 - ステップ4: 環境に合わせた最適なシリアライズ (Serialization)
クリーニング済みのJavaScriptオブジェクトを、送信や保存の目的に合わせて文字列に変換します。本番環境でネットワーク送信に使うなら、空白のない
JSON.stringify(cleaned, null, 0)を適用します。人がログを目で読む場合は、JSON.stringify(cleaned, null, 2)で読みやすくします。 - ステップ5: 永続化と下流APIへの安全な配信 余分なものを取り除いて軽くなったJSONペイロードを、PostgreSQLやMongoDBに保存したり、クライアント/サーバーのAPIレスポンスとして安全に送信したりします。
JSONペイロードを整理するコツ7選
大規模なトラフィックを扱うシステムで、ミリ秒(ms)単位のパフォーマンスを引き出すための、シニア開発者向けの高度なテクニックです。
- 本番(Production)APIの送信時はインデント(字下げ)を完全に取り除く:
デバッグ目的でなければ、APIレスポンスの生成時に不要な改行(
\n)やスペースをすべて削除する、コンパクトなシリアライズを適用しましょう。大規模なJSONでは、余白文字が全体の20%を超えることもあります。 - GraphQLやRESTのレスポンス送信直前に null をストリップ(Strip)する:
スキーマの都合で無理に埋められた、中身のない
nullフィールドは、ネットワーク帯域を無駄に消費するだけです。フレームワークのミドルウェアやインターセプター(Interceptor)の層でクリーニング関数を共通適用し、レスポンスサイズを最小限に抑えましょう。 - マイクロサービス間の通信にはスキーマベースのシリアライズツールを導入する:
Node.js環境なら、内部サービス間の通信でネイティブの
JSON.stringifyの代わりにfast-json-stringifyのような、スキーマを事前コンパイルするライブラリを導入すると、CPUの演算オーバーヘッドを大幅に減らせます。 - Webhookペイロードは、DBに永続保存する前に必ずサニタイズ(Sanitize)する: 外部の決済事業者やパートナーAPIから届く大きなWebhookのデータを、そのままRDBMSのJSONカラムに入れてしまうと、ストレージコストが急増します。必ずクリーニングを通した、必要な部分だけを保存しましょう。
- WeakSetで循環参照(Circular Reference)を回避・検出する:
複雑なメモリ上のオブジェクトをJSONに変換したりクリーニングしたりする際は、コールスタックの溢れを防ぐために、再帰関数に入るたびに現在のオブジェクトを
WeakSetに記録し、すでに訪問したオブジェクトかどうかを確認する防御コードを組み込む必要があります。 - ISO 8601形式のDateオブジェクトのシリアライズタイミングを制御する:
空の値を取り除くクリーニング関数が、JavaScriptの
Dateオブジェクトを空のオブジェクト{}と誤認して削除しないように、typeof value === "object"の分岐の中にvalue instanceof Dateの例外処理を加えるか、クリーニングの前に文字列へシリアライズしておく必要があります。 - 本Webツールでエッジケースや複雑なデータを試す:
複雑に入り組んだ数千行のJSONデータをコードにそのまま適用する前に、このページのクリーニングツールに貼り付けて、
0やfalse、配列内のオブジェクトが意図どおり残るかを目で確認する習慣をつけましょう。
最終判断ツリー: どの方法とツールを選ぶべき?
現在の開発環境と要件に合わせて、最適な空データの削除方法を1秒で判断できます。
- ケースA (シェル環境、CI/CDパイプライン、DevOpsのログ分析)
➔
jqコマンドのwalkフィルターを使う: CLI環境では、ブラウザを開かずにパイプ(|)でデータを渡し、walk(if type == "object" then ...)のようなクリーニングスクリプトをすぐ実行するのが最も効率的です。 - ケースB (単純なフラットな設定ファイル、深くネストしていないデータ)
➔
lodashの_.omitByやJSON.stringifyのリプレーサー関数を使う: 深い再帰が不要な平らなオブジェクトなら、プロジェクトに導入済みのユーティリティライブラリやネイティブ機能を使って、ボイラープレートコードを減らすのが賢明です。 - ケースC (深いネスト構造、APIレスポンスの圧縮、整合性が命の金融データ)
➔ 本文で紹介した
cleanValuesのボトムアップ再帰関数を実装する: オブジェクト内の空オブジェクトまできれいに取り除く必要があり、0とfalseの保持が最優先の課題である場合は、独自の再帰ロジックが唯一の正解です。 - ケースD (コーディングなしで、その場限りのデータ整理や見やすい可視化をしたい) ➔ 当サイトの「JSON空データクリーナー」(Webツール)を使う: ライブラリをインストールする時間さえ惜しく、すぐにExcelやレポートに貼り付けられるすっきりしたJSONデータが必要なときに、最適な選択です。
重要用語集 (Terminology Cheatsheet)
複雑なデータエンジニアリングの世界で迷わないための、6つの重要キーワードをまとめました。
- 再帰的な後行順走査 (Bottom-up Post-order Traversal): 最も深い位置にある子ノードから先に処理し、段階的に親ノードを評価していく木構造の探索アルゴリズムです。ネストした空オブジェクトを削除するための核となる考え方です。
- Falsy値 (Falsy Value): JavaScriptで真偽値として評価されたときに
falseと見なされる値です。(false、0、-0、0n、""、null、undefined、NaN) - RFC 8259: インターネット上のデータ交換の基盤となっているJavaScript Object Notation (JSON) フォーマットの、最新のIETF公式標準仕様書です。
- JSON.stringify のリプレーサー (Replacer): JavaScriptオブジェクトをJSON文字列に変換する際に、特定のプロパティを除外したり変換したりするため、第2引数に渡すコールバック関数または配列です。
- 循環参照 (Circular Reference): オブジェクトが自分自身を直接または間接的に再び指している状態です。この状態でJSONシリアライズや再帰関数を実行すると、無限ループに陥って致命的なエラーが発生します。
- ペイロード最適化 (Payload Optimization): ネットワークを介してクライアントとサーバーがやり取りするデータのかたまり(ペイロード)から、不要な空白や意味のない空のキーを取り除き、転送速度とコストを大きく改善する作業です。
よくある質問
単なる疑問にとどまらず、仕組みの理解につながる3つの質問と回答をまとめました。
Q1. 「0」と「false」を削除してはいけないのはなぜですか?例外処理はどうすればよいですか?
A1. API通信における 0 は、割引率0%、残高0ウォン、配列の0番目のインデックスなど、ビジネスロジックにとって重要な意味を持つデータです。false も、認証の失敗や機能の無効化を表します。これらを削除してしまうと、システムが「データがまだ収集されていない」という意味の null や undefined と誤って認識し、決済の漏れや権限チェックの回避といったバグにつながるおそれがあります。これを防ぐには、判定関数(isEmpty)で if (!value) のような広い範囲に当てはまる否定演算子を使わず、v === "" || v === null || v === undefined のように、削除対象を厳密等価(Strict Equality)で明示的に指定し、型の強制変換を避ける必要があります。
Q2. 5階層にネストした親オブジェクトがあり、一番奥の子の空の値を削除したところ、親もすべて空になってしまいました。これらを一度にまとめて削除するにはどうすればよいですか?
A2. 「トップダウン(Top-Down)」ではなく「ボトムアップ(Bottom-Up)」で走査する必要があります。JavaScriptの標準のリプレーサー(Replacer)は上から下へ処理を進めるため、すでに通り過ぎた親オブジェクトが後から空になっても、それを検知できません。一方、本文で紹介した cleanValues 関数は、再帰呼び出しの戻り値を受け取ってから、親のキーに代入するかどうかを判断します(if (!isEmpty(cleaned)) result[key] = cleaned;)。つまり、末端の子が削除されて親が {} になっても、その親を含む祖父母の階層の isEmpty がそれを確実に検出して削除します。
Q3. Bashシェルで jq コマンドを使っても、同じように再帰的なクリーニングはできますか?
A3. はい、問題なく可能です。jq 1.5以降で使える組み込み関数 walk を利用します。walk は内部で完全な後順走査(Post-order Traversal)を行います。シェルで次のように入力してください。
jq 'walk(if type == "object" then with_entries(select(.value != null and .value != "" and .value != [] and .value != {})) else . end)' input.json
この1行のコマンドで、Linuxサーバーの監視ログやcronジョブで生成された数ギガバイト級のダンプファイルも、あっという間にスリムにできます。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む