
文字数は空白込み・抜きどちらで数える?提出前の確認方法
目次
- 同じ文章なのに数える場所によって数字が違う理由
- ツールを使わずに文字数を数える方法
- エントリーシートやレポートはどちらで数えるべきか
- 数字が食い違うポイントの整理
- まとめ
- 核心となる技術の仕組み: 計算ツールによって結果が違うのはなぜ?
- 状況別の文字数・バイト数計算基準 比較表(Comparison Matrix)
- うっかりやりがちな文字数計算のミス5つ
- 履歴書・自己PRの文字数を最適化する5ステップのワークフロー
- 実務者とコピーライターのための7つの上級テクニック
- 自分に合った文字数カウント基準を判定するための決定木(Decision Tree)
- 専門家のようにテキストを扱うための必須用語チートシート
- よくある質問
「1,000字以内」と書かれたエントリーシートなのに、Wordで数えた数字と応募画面に表示される数字が違う、ということがあります。結論から言うと、文字数を指定した側が数える値が基準で、数字が食い違う原因はいくつかに決まっています。
原因は3つだけです。空白を数えるかどうか、改行を空白とみなすかどうか、そして文字ではなくバイトを数えているかどうか。この3つさえ分かれば、どの計算ツールでもルールを自分で突き止められます。
まとめ ① 基準が募集要項に書いてあればそれが優先で、オンライン入力フォームならそのフォームのカウンターが最終判定です。 ② 空白込みは空白抜きより常に大きいか等しいので、「以内」の制限は空白込みで、「以上」の要件は空白抜きで合わせれば、どちらの基準でも安全です。 ③ 2行の短い文を1つ入れてみれば、その計算ツールが改行を数えるかどうかを30秒で確認できます。
同じ文章なのに数える場所によって数字が違う理由
原稿をWordで書いて応募画面に貼り付けたら、Wordでは余裕があったのに画面では文字数オーバーで先に進めなかった、というのが典型的な例です。
このとき原因の多くは改行です。段落を分けるために押したEnterを1文字として数えるところと、まったく数えないところがあり、段落が10個あればそれだけで10文字の差になります。
2つ目は空白の範囲です。ふだん「空白」と呼ぶものにはスペースだけでなく、タブや、日本語入力で作りやすい全角スペース(幅の広い空欄)も含まれます。これを空白とみなす計算ツールは「空白抜き」から除外し、みなさない計算ツールでは文字として残ります。
3つ目は文字ではなくバイトを数える場合です。メッセージサービスや古い掲示板のように長さ制限がバイトでかけられていると、1文字が何バイトかによって入る分量が変わります。
ツールを使わずに文字数を数える方法
計算ツールを開かなくても確認できる方法が2つあります。いま使っているアプリにすでに入っている機能か、ブラウザにすでに入っている機能です。
文書アプリにすでにある機能
Microsoft Wordは「校閲」タブの文字カウントを開くと、「文字数(スペースを含む)」と「文字数(スペースを含めない)」が並んで表示されます。Google ドキュメントは「ツール」メニューの単語数で同じ値を表示します。
ここで大事なのは、どの項目を見るかです。2つの値が並んで出るので、提出先が求めた基準に合う行だけを読めばよいわけです。
ブラウザのコンソールで4つの値を一度に
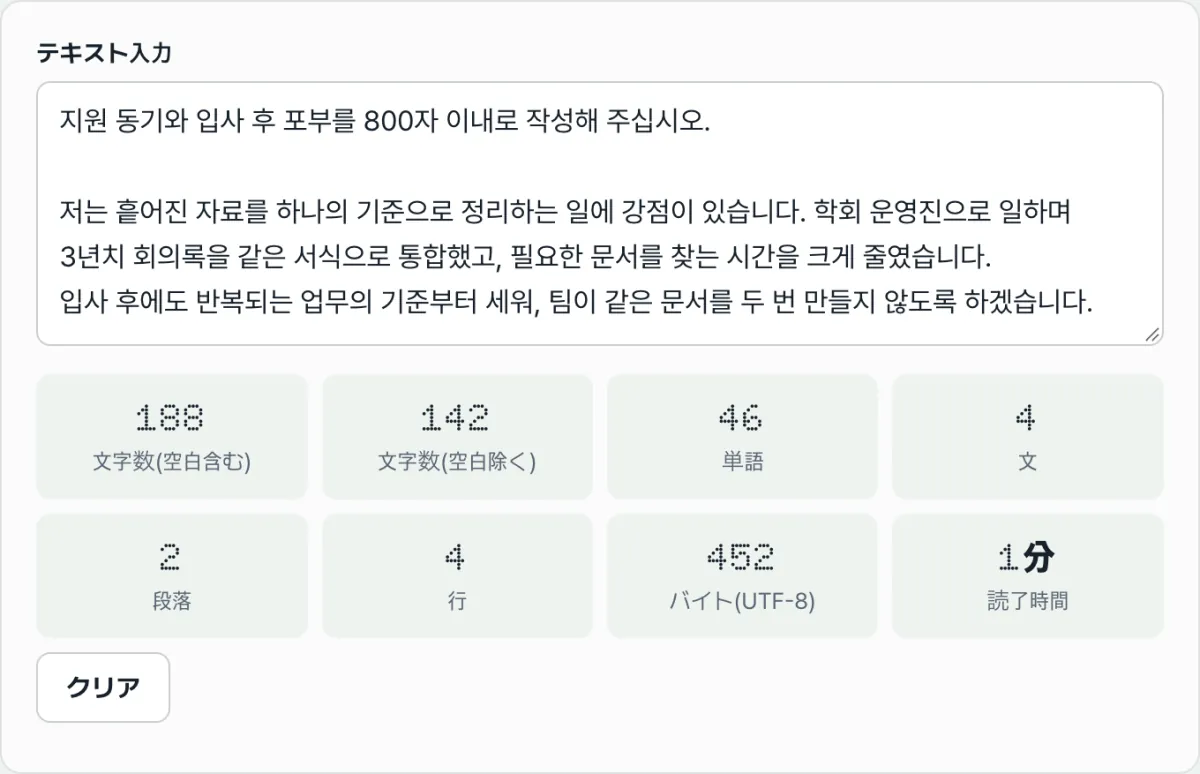
ブラウザの開発者ツール(たいていF12)のコンソールに以下を貼ると、4つの数字がそれぞれ出ます。このうち2〜4行目は、無料ツール「文字数カウント」が文字数(空白込み)・文字数(空白抜き)・バイト数を計算するときに使っている式と同じです。
const s = "ここに文章を貼り付けます";
s.length;                                  // UTF-16コードユニット数(絵文字は2と数えます)
Array.from(s).length;                      // 文字数(空白込み)
Array.from(s.replace(/\s/g, "")).length;  // 文字数(空白抜き)
new TextEncoder().encode(s).length;        // UTF-8バイト数
ここで replace(/\s/g, "") が消すのはスペースだけではありません。タブ・改行・全角スペースまでまとめて消します。そのため、この式で出した「空白抜き」の値には改行が含まれていません。
どの計算ツールでもルールが分かる30秒テスト
計算ツールが改行を数えるかどうかは、この2行を入れてみるだけで分かります。
あい
うえ空白込みが5なら改行を1文字と数えていることになり、4なら数えていないことになります。ちなみに文字数カウントは5と数えます(空白抜きは4です)。
ただ、これを毎回コンソールを開いて確認するのは面倒ですし、複数行の原稿を引用符の中に貼り付けるのも手間がかかります。
文字数カウントで確認する。 入力欄に原稿をそのまま貼り付けると、空白込み・空白抜きの文字数が同じ画面にまとめて表示されます。
インストールや会員登録は不要で、ブラウザ上ですぐに計算できます。貼り付けた文章がサーバーに送信されることはありません。
エントリーシートやレポートはどちらで数えるべきか
順番に判断していけば大丈夫です。
1. 募集要項や課題の案内に書かれた文言が最優先です。 「空白込み1,000字」「空白抜き500字以上」のように明記されていれば、その基準だけを見れば済みます。
2. オンライン入力フォームなら、そのフォームのカウンターが事実上の最終基準です。 送信ボタンを止めるのはその画面なので、Wordで何文字だったかは判定に使われません。貼り付けたあとに画面の数字を確認するのが確実です。
3. 基準が分からないときは不等号の向きで決めます。 空白込みの値は空白抜きの値より常に大きいか等しい。そのため「以内」の制限は空白込みの値を制限内に収め、「以上」の要件は空白抜きの値が要件を超えるように合わせれば、どちらの基準で採点されても引っかかりません。
数字が食い違うポイントの整理
| 食い違うポイント | 計算ツールによって |
|---|---|
| 改行(Enter) | 1文字と数えたり、まったく数えなかったりします |
| タブ・全角スペース | 空白とみなせば「空白抜き」から除外され、みなさなければ文字として残ります |
| 絵文字 | 1文字と数えるところと2文字と数えるところがあります |
| バイト | ハングル1文字がUTF-8では3バイト、EUC-KR系では2バイトです |
絵文字で差が出るのは内部の保存方式が理由です。JavaScriptの 文字列.length はUTF-16コードユニットを数えるため、😀のような絵文字は2とカウントされ、人が見る文字単位で数えると1になります。文字数カウントは文字単位で数えて1と表示します。
もう1つ、韓国語での「単語」数は辞書的な単語ではなく、空白で区切った語の数です。文字数カウントも空白を基準に区切って数えるので、英語の文章の単語数と同じ意味で比較するのは難しいところです。
まとめ
- 数字が食い違う原因は、改行・空白の範囲・バイトの3つでほぼ説明できます。
- 空白込みは空白抜きより常に大きいか等しい。「以内」は空白込みで、「以上」は空白抜きで合わせれば安全です。
- オンライン提出フォームがある場合は、その画面のカウンターが最終判定です。
- 「あい / うえ」の2行を入れて5か4かを見れば、その計算ツールが改行を数えるかどうかすぐに分かります。
- メッセージサービスのように制限がバイトでかけられている場所では、文字数ではなくバイト数を見る必要があります。
インストールや会員登録は不要で、ブラウザ上ですぐに計算できます。貼り付けた文章がサーバーに送信されることはありません。
核心となる技術の仕組み: 計算ツールによって結果が違うのはなぜ?
文字数の計算がずれる根本的な理由は、コンピューターが文字を認識してメモリに保存する方式、つまり「エンコーディング(Encoding)」と「文字列処理エンジン」がプラットフォームごとに異なるからです。
1. 文字列長(String Length)の表現方法の違い
プログラミング言語やブラウザのエンジンは、文字列の長さをそれぞれ違う単位で測ります。
- JavaScriptの標準Lengthプロパティ(UTF-16コードユニット): 最もよく使われるJavaScriptの
string.lengthは、文字をUTF-16コードユニット単位で数えます。英字やハングルなど基本多言語面(BMP)の文字は1として数えますが、追加多言語面(SMP)にある絵文字(例:😀)や一部の特殊記号はサロゲートペア(Surrogate Pair)として扱われ、1文字が長さ2として返されます。 - グラフェムクラスタ(Grapheme Cluster)でのカウント: 人の目に見える直感的な「1文字」単位で数える方法です。
Array.from(str).lengthや最新ブラウザのIntl.Segmenterを使えば、複雑な合成絵文字(👨👩👧👦)やハングルの初声・中声・終声の組み合わせも、人が認識するちょうど1文字として正確に計算できます。 - バイト(Byte)単位のエンコーディングの違い: 文字数ではなく保存容量の大きさを数える場合は、エンコーディング方式が結果を左右します。
- ASCII: 英字、数字、基本記号はどの環境でも1バイトです。
- EUC-KR(CP949): レガシーなWindows環境や古い韓国国内のSMSシステムで主に使われ、ハングル1文字を2バイトで処理します。
- UTF-8: 現在のWeb標準エンコーディングで、ハングル1文字を3バイトで処理します。絵文字などの特殊文字は4バイトを占めます。
2. 改行文字(Line Break)という処理上の変数
文字数をカウントするときに最も混乱を招く原因は改行です。OSによって、Enterキーを押したときに入る文字が異なります。
- LF(Line Feed、
\n): Unix、Linux、macOS環境で使われ、改行を1文字(1バイト)として扱います。 - CRLF(Carriage Return + Line Feed、
\r\n): Windows OSとRFC 2822標準のメール規格で使われ、目には見えませんが2つの文字(2バイト)が組み合わさっているため、厳密な文字数カウンターでは2文字として数えられます。
3. 全角スペースと半角スペースの落とし穴
- 半角スペース(Half-width Space、
\u0020): ふだんスペースキーで入力する基本の空白で、1バイトを占めます。 - 全角スペース(Full-width Space、
\u3000): 日本語やハングルの入力メソッドで特定のキー操作によって入力される、幅の広い空白です。見た目には普通のスペースを何度か押したように見えますが、システム内部では1つの文字であり、UTF-8環境では3バイトを占めます。「空白を除く」正規表現の処理が不十分なカウンターでは、この全角スペースを文字として認識してしまい、文字数の誤差を生むことがあります。
状況別の文字数・バイト数計算基準 比較表(Comparison Matrix)
主要なプラットフォームや企業ポータルが、どのような基準で文字数とバイト数を算出しているのかを明確にまとめたマトリクスです。(※ システムのアップデートにより変わる可能性があります。)
| プラットフォーム/システム | 空白の扱い | 改行(Enter)の扱い | 絵文字/特殊文字 | ハングルのバイト数換算 |
|---|---|---|---|---|
| Microsoft Word(MS Word) | 選択して確認可能 | 文字数に含まれない(0字) | 1文字として認識 | OSの既定エンコーディングに依存 |
| Googleドキュメント(Google Docs) | 選択して確認可能 | 1文字として認識 | 1文字として認識 | UTF-8 |
| サラミン/ジョブコリアの採用フォーム | 企業の設定による | 企業ごとに異なる(通常2字) | 特殊文字はエラーに注意 | システム内部の基準 |
| 国税庁ホームタックス(Hometax) | 空白を含む | CRLF(2バイトとして処理) | 使用不可(エラーになる) | EUC-KRベース(2バイト) |
| 公共企業体のNCSブラインド採用フォーム | 空白を含む(大多数) | 通常2字(プラットフォームにより異なる) | システム側でフィルタリングされる | EUC-KR/UTF-8の混用 |
| X(旧Twitter)の280字制限 | 空白を1字として含む | 1字としてカウント | 2文字分として重み付け | ハングルは2文字(ウェイト適用) |
| SMSショートメッセージ(80~90バイト) | 空白を1バイトとして処理 | LF/CRLFはプラットフォーム依存 | 通常は送信不可/LMSに切り替え | ハングルは2バイト(EUC-KR) |
うっかりやりがちな文字数計算のミス5つ
ちょっとしたミスが、書類選考の不合格や過剰な料金請求といった取り返しのつかない結果につながることがあります。必ず避けたい5つの致命的なミスを確認してください。
- 「空白を含む(With Spaces)」と「空白を除く(Without Spaces)」の混同: 最も頻繁に起きる誤りです。提出先が指定した基準がどちらなのかを確認せず、計算ツールの画面で最も大きく表示される既定の数字だけを信じて提出するのは非常に危険です。
- 段落の多いエッセイで改行の文字数を見落とす行為: 論理的な展開のために段落を細かく分けるのは良いことですが、改行記号(CRLF)が毎回1〜2字ずつ積み重なることを忘れると、1,000字制限のフォームで後半の文が1つ丸ごと切られてしまうことがあります。
- バイト制限のあるフォーム(SMS、レガシー掲示板)での無分別な絵文字の使用: 絵文字はUTF-16で2つ以上のコードユニット、UTF-8で4バイト以上を消費します。80バイト制限のフォームに絵文字を1つ入れた瞬間、ハングル2文字分を削らなければならないペナルティが発生します。
- Microsoft Wordの文字数カウントを鵜呑みにする姿勢: Wordは改行をカウントしないため、Webフォームとは結果が異なります。下書きはWordで書いても、最終的な文字数は必ずその企業のオンライン応募フォームに直接貼り付けて検証してください。
- 書類締切の5分前までカウント検証を先延ばしにする癖: 締切直前はサーバーのトラフィックが集中する時間帯です。1,001字でコピーが拒否された状況で、1字減らすために文脈を損なわず編集するのは大きなストレスになり、サーバーがダウンするリスクもあります。
履歴書・自己PRの文字数を最適化する5ステップのワークフロー
たった1字の違いでシステムエラーが起き、理不尽に落ちてしまうのを防ぐための、確実性を保つワークフローです。
- ステップ1(ガイドラインの確認と基準の確定): 求人票やシステムの案内文に書かれた基準が「空白を含む」なのか「空白を除く」なのか、バイト単位なのかを正確に確認します。
- ステップ2(上限の90〜95%を目標に下書き): 1,000字以内なら900〜950字を目標に書きます。最初から1,000字にぴったり合わせようとすると、修正のたびに文字数オーバーに悩まされることになります。
- ステップ3(Webベースの専用カウンターでシミュレーション): WordやHangulなどのワープロソフトのカウンターを信じず、改行や空白をWeb標準で正確に数える当サイトの「文字数カウント」にコピーして、実際の分量を測ります。
- ステップ4(余計な表現と不要な空白の除去): 文字数がぎりぎり超えている場合は、頻繁な改行をまとめ、目に見えない文末のスペース(Trailing Spaces)を削除し、不要な修飾語を減らします。全角スペースが混じっていないかも確認します。
- ステップ5(締切2時間前に実際のポータルでテスト入力): 実際の応募ポータルのテキストエリア(Textarea)に下書きを貼り付け、ポータル下部に表示される内部カウンターが赤字(超過)の警告を出さないか、締切の少なくとも2時間前に余裕をもって最終確認します。
実務者とコピーライターのための7つの上級テクニック
テキストの分量調整と最適化を自在に扱うための、専門家たちのライティングとカウントのノウハウです。
- 安全第一の「90%ルール」を適用: 企業が求める最大文字数の90%以上を満たしつつ、95%を超えないように合わせるのが最も理想的です。1,000字制限なら900字〜950字の間に収めて、システムのカウント誤差による不利益を完全に防ぎましょう。
- 改行ダイエットで分量を確保: 段落を分けるためにEnterを2回続けて押す(空行を挿入する)癖は、文字数を2〜4字ずつ無意味に消費します。テキストの分量がぎりぎりの場合は、連続した改行を単一の改行とスペースキーに置き換えましょう。
- 受動態の文を能動態に圧縮: 「〜されてしまったのだと考えられます」のような不要な受動・使役表現を「〜しました」のような簡潔な能動態に変えると、文の可読性が飛躍的に上がり、余分な文字数を10%以上削減できます。
- 正規表現(Regex)
s+$を使って末尾の空白を完全削除: 文末のピリオドの後ろに無意味に追加されたスペースキーは、目には見えませんが文字数を密かに削っていきます。エディタの正規表現検索機能を使って、末尾の空白を一網打尽にしましょう。 - 政府・公共機関のシステムは「バイト(Byte)」のサイズを優先して考慮: 公企業の採用や国税庁など、古いレガシーシステムはEUC-KRベースのバイト数を基準にデータを切り捨てます。ハングルが2バイトとして扱われるため、提出前にウェブのバイト計算機で丁寧なクロスチェックが必須です。
- Twitter(X)の独特なハングル加重を理解する: グローバルSNSであるTwitterは280字の制限を設けていますが、ハングルや漢字などのCJK文字は1字を「2字」分の比重で計算します。したがって、ハングルだけで書く場合の実質的な最大長は140字だという点を忘れないでください。
- 統合ダッシュボード型のビューカウンターを活用: 文字数(含む/除く)とバイト数(UTF-8/EUC-KR)を1つの画面でリアルタイムに同時表示するマルチビューツールをブックマークし、作業ウィンドウの片側に表示しながら書くと生産性が最大化されます。
自分に合った文字数カウント基準を判定するための決定木(Decision Tree)
自分の文章をコピーして貼り付ける前に、どの基準を適用すべきかを3秒で判断できるガイドマップです。
- ターゲットは大企業・民間企業の採用ポータルですか?
- ➔ YES: ポータル自体のカウンターが絶対的な権威です。下書きの段階では文字数(スペース込み)を基準に確認しつつ、95%の比率を狙いましょう。
- ターゲットは公共機関・公務員の採用システム(NCS)ですか?
- ➔ YES: 指示事項に「スペース抜き」があるか確認してください。旧型システムではバイト数の検査も存在するため、文字数(スペース抜き)とEUC-KRのバイト数を同時にモニタリングしましょう。
- ターゲットはSMS送信システムや旧型の掲示板ですか?
- ➔ YES: 断然バイト数(Byte)基準が第一優先です。なるべく絵文字の使用を抑えて、バイト超過による送信失敗や課金オーバーを防ぎましょう。
- ターゲットはグローバルSNS(Twitterなど)ですか?
- ➔ YES: CJK加重が適用された専用の長さアルゴリズムに従います。ハングル基準で140字のリミットと考え、スペースを厳密に管理しましょう。
専門家のようにテキストを扱うための必須用語チートシート
- スペース込み (With Spaces): 文字を構成するアルファベット、ハングル、数字だけでなく、区切り(スペースキー)やタブ(Tab)、時には改行記号まで、すべてをそれぞれ1文字として認めて合計した値です。一般的なウェブポータルのフォームにおけるデフォルトの基準です。
- スペース抜き (Without Spaces): 文章の純粋な意味を担うテキスト文字だけをカウントし、区切りやタブ、改行などを除いた中身だけの文字数です。応募者の実質的な記述分量を確認したいときに求められる、厳しめの基準です。
- バイト (Byte): 文字がコンピュータのメモリや記憶装置に記録されるときに占める、実質的なデータ容量の単位です。文字数とは直結せず、エンコーディング方式によって大きく異なります。
- UTF-8 vs EUC-KR (CP949): 世界標準のエンコーディングであるUTF-8はハングルを重く(3バイト)保存しますが多言語の互換性は完璧で、韓国専用のエンコーディングであるEUC-KRはハングルを軽く(2バイト)保存しますが、他国の言語や絵文字が文字化けする危険性が大きいです。
- サロゲートペア (Surrogate Pair): 最新の絵文字や特殊記号を、16ビット(UTF-16)の空間2つを連結して表現する方式です。旧型のJavaScriptエンジンではこれを2文字として認識してしまうバグ由来の誤差が存在します。
- 改行 (CRLF vs LF): Enterキーを入力したときに保存される見えない記号で、Windowsは2つの記号(CR、LF)を、MacとLinuxは1つの記号(LF)を挿入します。
よくある質問
文字数カウントの微妙な違いに戸惑うユーザーが最もよく尋ねる、核心的な質問への深い回答です。
Q1. Wordで書いたときは980字だったのに、企業の採用ポータルに貼り付けたら1,020字になりました。なぜこのような差が生まれるのですか?
A1. 2つのシステムの「改行(Enter)」の処理方法の違いによるものです。MS Wordは段落を分けるEnterキーを文字数に合算せず、0字として扱います。一方、ほとんどの企業の採用ウェブポータルは、テキスト入力欄(Textarea)の属性上、改行を文字(主にCRLF形式の2文字)として認識し、そのまま文字数に含めます。したがって、段落が多い文章ほど、2つのシステム間の数字の差は雪だるま式に広がっていきます。最終提出時には、必ずそのウェブポータル自体のカウンター基準を優先すべきです。
Q2. 最新の絵文字(😀)や複雑な顔文字を入れると、文字数やバイト数の上限にどのような影響がありますか?
A2. 絵文字は通常のテキストに比べてはるかに多くのデジタル資源を消費するため、制限のあるフォームでは非常に致命的になり得ます。文字数(Length)の観点では、旧型システムやJavaScriptの組み込み関数の基準で、1つの絵文字が2〜4文字分を食いつぶします。バイト(Byte)の観点でも、UTF-8エンコーディング環境では1つの絵文字がなんと4バイトの容量を占めるため、ハングル1文字(3バイト)や英字4文字(4バイト)を諦めなければならないペナルティを負うことになります。バイト制限が厳しいSMSや自己紹介書では、絵文字の使用を控えるのが望ましいです。
Q3. 文字数が制限をちょうど20字超えてしまいました。内容を損なわずに分量を圧縮する最良のコツは何ですか?
A3. 内容の論理を損なわずに20字を削る最適な方法は3つあります。第一に、不必要に細かく分かれた段落をまとめて、改行記号が消費する見えない文字数を節約しましょう。第二に、「〜するような気がします」「〜だと考えられます」のような習慣的で冗長な受動態・推測の語尾を「〜します」「〜です」に大胆に削ってください。第三に、正規表現検索を使って文末や単語の間に過剰に入ったスペースキーの余分な空白を検索してすべて削除すれば、20字は十分に確保できます。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む