
JSON-LD: Was es ist, wo es hingehört, Pflichtfelder
Inhalt
Sie haben schon öfter gehört, Sie sollten auf Ihrem Blog oder Ihren Produktseiten „JSON-LD einbinden“, wissen aber nicht genau, was das ist und wohin es gehört? Dann ist dieser Beitrag für Sie.
Vorab die Kurzfassung: JSON-LD sind Daten, in denen der Inhalt einer Seite separat in einem Format beschrieben wird, das Suchmaschinen lesen können. Sie stehen in einem <script type="application/ld+json">-Tag innerhalb des HTML.
Eines vorweg: Mit Markup allein erscheinen noch keine Rich-Suchergebnisse wie Sternebewertungen oder Bilder. Die Google-Dokumentation sagt das ausdrücklich: Auch bei korrekter Auszeichnung sei nicht garantiert, dass die Darstellung in den Suchergebnissen erfolgt.
Zusammenfassung ① JSON-LD sind JSON-Daten innerhalb von
<script type="application/ld+json">. Laut Google-Dokumentation dürfen sie sowohl im<head>als auch im<body>stehen. ② Für die Berechtigung zu Rich-Ergebnissen gibt es je Typ Pflichtattribute. Für Article gibt es keine Pflichtattribute, für ein lokales Unternehmen sind name und address Pflicht. ③ Auch wenn Sie alle Pflichtattribute ausfüllen, ist die Anzeige nicht garantiert. Manche Funktionen, etwa die FAQ-Rich-Ergebnisse, werden sogar ganz eingestellt.
Strukturierte Daten beeinflussen die Darstellung, nicht das Ranking
Zusätze wie Sternebewertungen, Preise, Bilder oder Websitenamen in den Suchergebnissen nennt man Rich-Ergebnisse (Rich Results). Diese Elemente stammen nicht aus Vermutungen, die aus dem Seitentext abgeleitet wurden, sondern aus Daten, die die Seite selbst meldet.
Diese Meldung sind die strukturierten Daten, und eine der Schreibweisen dafür ist JSON-LD. Das Vokabular stammt von schema.org, das Notationsformat ist JSON-LD 1.1 (W3C-Empfehlung vom Juli 2020).
Hier entsteht häufig ein Missverständnis: Strukturierte Daten beeinflussen das Aussehen der Suchergebnisse, sie sind kein Mittel, um das Ranking zu verbessern. Zur manuellen Maßnahme bei strukturierten Daten schreibt die Google-Dokumentation sinngemäß, dass die Seite lediglich die Berechtigung für Rich-Ergebnisse verliert, ihr Ranking in der Websuche aber unberührt bleibt.
Wie sieht JSON-LD aus?
Ein JSON-LD-Block besteht aus drei Teilen: dem umschließenden Tag, @context, das auf das Vokabular verweist, und @type, das angibt, wovon die Daten handeln.
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Einsteigerleitfaden zu strukturierten Daten",
  "author": { "@type": "Person", "name": "Max Mustermann" },
  "datePublished": "2026-07-20",
  "image": "https://example.com/cover.jpg"
}
</script>
Das Attribut type muss application/ld+json lauten. Schreiben Sie text/javascript, versucht der Browser, das JSON als Code auszuführen, und meldet einen Fehler. Bei application/json wird zwar nichts ausgeführt, aber Suchmaschinen erkennen den Block nicht als strukturierte Daten.
@context ist die Anweisung, die nachfolgenden Namen wie headline oder author als schema.org-Vokabular zu lesen. @type legt fest, ob es sich bei den Daten um einen Artikel, ein Produkt oder ein Geschäft handelt. Fehlt eines von beiden, werden die Daten nicht interpretiert, so sorgfältig der Rest auch ausgefüllt ist.
Ist ein Wert selbst wieder ein Objekt, schreiben Sie ihn als verschachteltes Objekt. So ist es beim author im Beispiel oben. Deshalb steht auch ein einzelner Personenname in der Form { "@type": "Person", "name": "…" }.
Wohin gehört JSON-LD?
Die Google-Dokumentation beschreibt JSON-LD als Notation, die in <script>-Tags innerhalb der Elemente <head> und <body> einer HTML-Seite steht. Sie können es also an beiden Stellen platzieren.
Dasselbe Dokument führt aus, dass auch JSON-LD gelesen werden kann, das erst später per JavaScript oder durch ein Widget eingefügt wurde. Das hilft, wenn Sie das Markup nur schwer direkt ins statische HTML schreiben können.
Auf einer Seite dürfen auch mehrere Blöcke stehen. Zum Beispiel können Sie auf einer Artikelseite je einen Block für Article und für den Navigationspfad (BreadcrumbList) setzen.
JSON-LD ohne Tool selbst erstellen und prüfen
Es sind vier Schritte. Sie lassen sich problemlos von Hand erledigen.
Schritt 1: Typ wählen und Pflichtattribute prüfen
Legen Sie zuerst fest, worum es auf der Seite geht (Artikel, Produkt, Geschäft usw.). Öffnen Sie dann die passende Dokumentation in der Google Search Central und sehen Sie sich die Tabelle der Pflichtattribute an. Die Liste unterscheidet sich je nach Typ, und die Dokumentation wird auch aktualisiert.
Schritt 2: JSON schreiben
Schreiben Sie wie im Beispiel oben zuerst @context und @type, danach die geprüften Attribute. Bei Attributen, deren Wert Sie nicht kennen, lassen Sie sie besser ganz weg, statt sie als leeren String stehen zu lassen. Leere Werte können als fehlerhafte Daten gelesen werden.
Schritt 3: Syntax prüfen
Bei JSON macht schon ein einziges falsches Komma den gesamten Block ungültig. Geben Sie die folgende Zeile in die Konsole der Entwicklertools Ihres Browsers (meist F12) ein, dann sehen Sie sofort, ob alle JSON-LD-Blöcke der Seite korrekt geparst werden.
[...document.querySelectorAll('script[type="application/ld+json"]')]
  .map(s => { try { return JSON.parse(s.textContent); } catch (e) { return "Parsen fehlgeschlagen: " + e.message; } })
Schritt 4: Berechtigung prüfen
Der Google-Test für Rich-Suchergebnisse (search.google.com/test/rich-results) zeigt Ihnen, für welche Rich-Ergebnis-Funktionen von Google die Seite berechtigt ist. Möchten Sie nur die Syntax prüfen, nutzen Sie den Validator für Markup von schema.org (validator.schema.org). Die beiden Werkzeuge prüfen Unterschiedliches.
Schwierig sind vor allem die Schritte 1 und 2. Attributnamen und Verschachtelungen müssen Sie jedes Mal in der Dokumentation nachschlagen und übertragen, und Kommas und geschweifte Klammern setzen Sie von Hand.
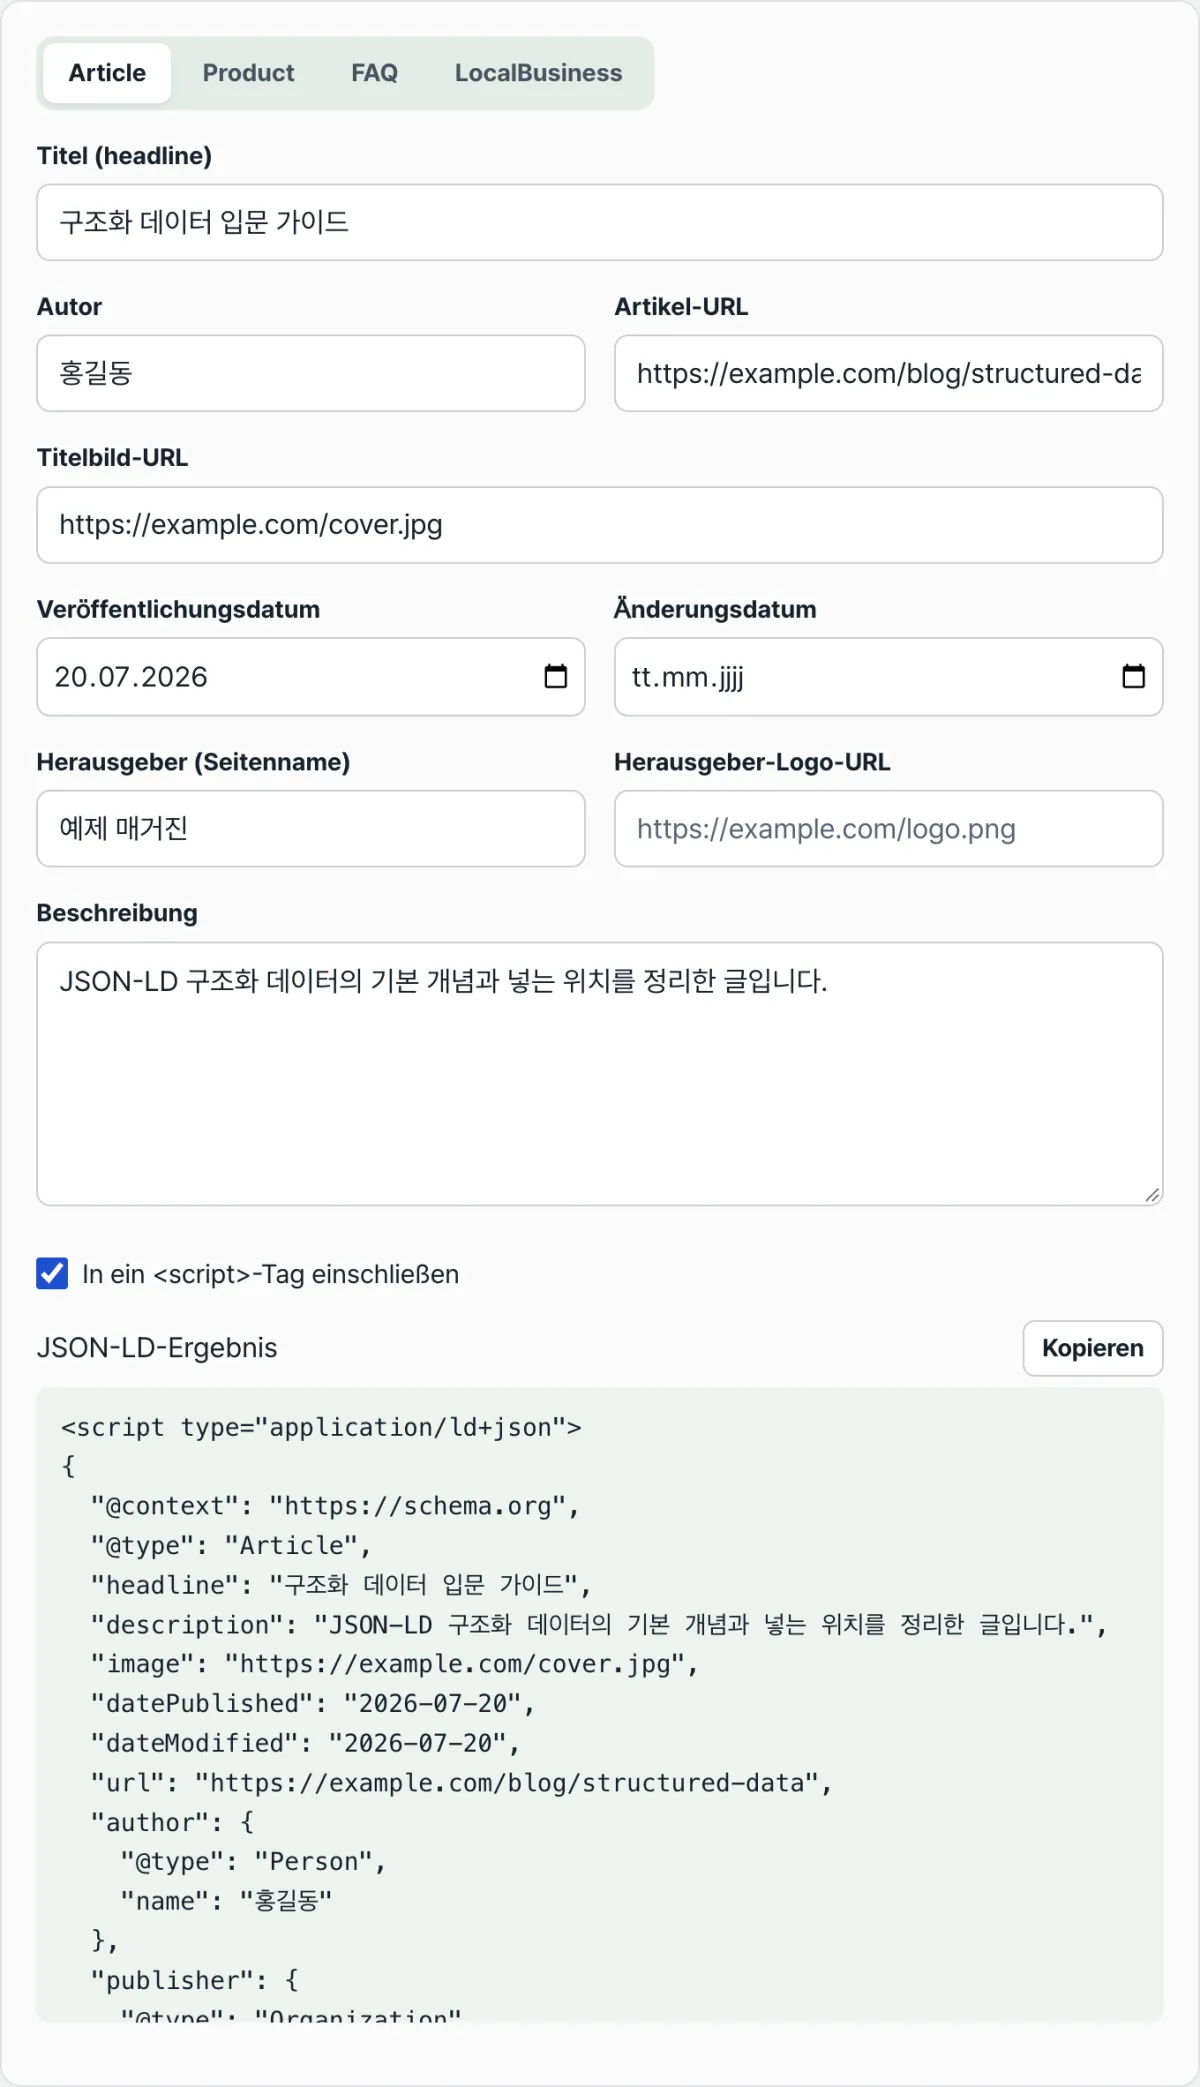
Mit unserem Tool prüfen. Wählen Sie oben im Tab Article, Product, FAQ oder LocalBusiness aus und füllen Sie das Formular aus, dann entsteht das JSON-LD in Echtzeit. Felder, die Sie leer lassen, fehlen automatisch im Ergebnis. Schalten Sie die Option zum Umschließen mit einem <script>-Tag ein, erhalten Sie den Code in einer Form, die Sie direkt einfügen können.
Der Code entsteht direkt im Browser, ganz ohne Installation oder Registrierung. Ihre Eingaben werden nicht an einen Server übertragen.
Pflichtattribute und empfohlene Attribute sind nicht dasselbe
Hier kommt es häufig zu Verwechslungen. Im schema.org-Vokabular selbst gibt es keine Kennzeichnung „Pflicht“. Pflichtattribute sind eine Liste, die Suchmaschinen für bestimmte Rich-Ergebnis-Funktionen gesondert verlangen.
Nach der Google-Dokumentation ergibt sich folgendes Bild.
| Typ | Von Google verlangte Pflichtattribute |
|---|---|
| Article (Artikel) | Keine – es gibt nur empfohlene Attribute |
| Product (Produkt-Snippet) | name sowie eines von review, aggregateRating oder offers |
| LocalBusiness (lokales Unternehmen) | name, address |
Dass Article keine Pflichtattribute hat, mag überraschen. Die Google-Dokumentation schreibt sinngemäß, es gebe keine erforderlichen Attribute, man solle die Attribute angeben, die auf den Inhalt zutreffen. Als empfohlene Attribute nennt sie stattdessen headline, image, datePublished, dateModified und author.
Bei Produkt-Snippets reicht dagegen der Name allein nicht aus. Mindestens eines von Rezension, aggregierter Bewertung oder Verkaufsinformationen muss vorhanden sein, damit die Berechtigung entsteht.
Man könnte meinen, je mehr empfohlene Attribute, desto besser. Die Google-Dokumentation hält jedoch ausdrücklich fest, dass es besser ist, weniger Attribute dafür korrekt anzugeben, als alle empfohlenen Attribute nachlässig auszufüllen.
Warum Rich Results trotz Markup nicht erscheinen
Manchmal sind alle Pflichteigenschaften ausgefüllt, und die Suchergebnisse sehen trotzdem unverändert aus. Meist steckt einer dieser vier Gründe dahinter.
| Situation | Was passiert |
|---|---|
| Die Funktion selbst wurde eingestellt | Das Markup ist zwar gültig, aber es gibt keinen Platz mehr, an dem es angezeigt werden könnte |
| Markup für Inhalte, die auf der Seite nicht sichtbar sind | Das verstößt gegen die Richtlinien und kann die Berechtigung kosten |
| Pflichteigenschaft fehlt | Für die jeweilige Funktion entsteht gar keine Berechtigung |
| Berechtigt, aber nicht angezeigt | Ob und in welcher Form etwas angezeigt wird, entscheidet die Suchmaschine |
Ein Beispiel für die erste Zeile, das tatsächlich eingetreten ist, sind FAQs. FAQ-Rich-Results wurden im August 2023 auf bekannte Websites aus den Bereichen Behörden und Gesundheit eingeschränkt und werden seit dem 7. Mai 2026 in der Google-Suche gar nicht mehr angezeigt.
Das FAQPage-Markup selbst ist weiterhin gültiges schema.org-Markup. Nur erscheint es in der Google-Suche nicht mehr als FAQ-Akkordeon.
Auch die zweite Zeile ist wichtig. Die Google-Richtlinien sind eindeutig: Markieren Sie keine Inhalte aus, die für Besucherinnen und Besucher der Seite nicht sichtbar sind. Ein typischer Verstoß ist es, Bewertungen oder Preise nur im JSON-LD anzugeben, obwohl sie auf der Seite nicht erscheinen.
Die vierte Zeile ist der Ausgangspunkt dieses Beitrags. Die Berechtigung ist eine Frage von bestanden oder nicht bestanden, die Anzeige liegt dagegen im Ermessen der Suchmaschine. Selbst wenn der Test für Rich-Suchergebnisse die Berechtigung bestätigt, kann das Ergebnis in der echten Suche als normaler Text erscheinen.
Zusammenfassung
- JSON-LD sind JSON-Daten innerhalb von
<script type="application/ld+json">.@contextund@typemüssen immer vorhanden sein. - Sie können das Markup im
<head>oder im<body>platzieren, und auf einer Seite sind mehrere Blöcke möglich. - Pflichteigenschaften legt nicht schema.org fest, sondern die Suchmaschine pro Funktion. Für Article gibt es keine Pflichteigenschaften, für ein lokales Unternehmen (LocalBusiness) sind name und address Pflicht.
- Bei empfohlenen Eigenschaften ist es besser, sie korrekt auszufüllen, als möglichst viele anzugeben.
- Auch korrektes Markup garantiert keine Anzeige als Rich Result, und Funktionen können wie bei FAQ ganz wegfallen.
- Strukturierte Daten beeinflussen, wie ein Suchergebnis dargestellt wird. Sie sind kein Mittel, um das Ranking zu verbessern.
Der Code entsteht direkt im Browser, ganz ohne Installation oder Registrierung. Ihre Eingaben werden nicht an einen Server übertragen.
Häufige Fragen
Gehört JSON-LD in den Head oder in den Body?
Die Google-Dokumentation beschreibt JSON-LD als Notation in <script>-Tags innerhalb der Elemente <head> und <body>. Beide Positionen werden ausgelesen. Außerdem steht dort, dass auch JSON-LD gelesen werden kann, das per JavaScript nachträglich in dasselbe Dokument eingefügt wird. So gibt es auch dann einen Weg, wenn Sie das Template nicht direkt bearbeiten können.
Verbessert Markup das Ranking in der Suche?
Strukturierte Daten beeinflussen nicht das Ranking, sondern die Darstellung der Suchergebnisse. Zur manuellen Maßnahme bei strukturierten Daten erklärt die Google-Dokumentation sinngemäß: Die Seite verliere lediglich die Berechtigung für die Anzeige als Rich Result, ihr Ranking in der Websuche sei davon nicht betroffen. Außerdem weist Google ausdrücklich darauf hin, dass auch korrekt ausgezeichnete Seiten nicht zwingend als Rich Result erscheinen.
Lohnt sich FAQ-Markup heute noch?
FAQ-Rich-Results werden in der Google-Suche seit dem 7. Mai 2026 nicht mehr angezeigt. FAQPage ist aber weiterhin ein gültiger schema.org-Typ, und es schadet nicht, das Markup beizubehalten. Wenn Sie es einsetzen wollten, um in der Google-Suche als FAQ-Akkordeon zu erscheinen, hat es derzeit keine Wirkung.
Werden die Eingaben im Formular an einen Server gesendet?
Nein. Der JSON-LD-Schema-Generator erzeugt das Markup vollständig im Browser. Eingegebene Werte wie Titel, Adresse oder Telefonnummer werden weder an einen Server gesendet noch gespeichert. Felder, die Sie leer lassen, werden automatisch aus dem JSON entfernt, sodass im Code nur die ausgefüllten Angaben stehen.
Dieser Artikel basiert auf unserem koreanischen Original. Koreanisches Original lesen