
URL-Kodierung erklärt: Prozentkodierung und kaputte Umlaute
Inhalt
- Die URL-Syntax erlaubt nur bestimmte Zeichen
- Warum koreanische Schrift so lange %XX-Ketten erzeugt
- Warum encodeURI und encodeURIComponent unterschiedliche Ergebnisse liefern
- So zeigt das Tool den Unterschied zwischen encodeURI und encodeURIComponent
- Welche Zeichen ersetzt wurden, sehen Sie auf einen Blick
- Fazit
- Häufig gestellte Fragen
Sie haben es bestimmt schon einmal erlebt: Sie geben in die Suchleiste einen Begriff mit Umlauten oder Sonderzeichen ein, und plötzlich steht in der Adresszeile etwas wie %EC%9D%B4%EB%9F%B0. Umgekehrt kann es passieren, dass ein selbst gebauter Link mit Leerzeichen oder Nicht-ASCII-Zeichen die Seite nicht öffnet oder der Server die Anfrage an der falschen Stelle abschneidet.
Eine URL folgt einer festen Syntax, die genau vorgibt, welche Zeichen erlaubt sind. Zeichen außerhalb dieser Syntax (Leerzeichen, koreanische Schrift, Emojis, manche Sonderzeichen) müssen als Prozentkodierung in der Form %XX geschrieben werden. Nur dann tauschen Browser und Server exakt dieselbe Zeichenfolge aus.
Zusammenfassung ① Die URL-Syntax erlaubt nur bestimmte Zeichen. Alle anderen (Leerzeichen, nicht lateinische Schrift, Sonderzeichen) müssen als Prozentkodierung in der Form %XX geschrieben werden, damit Browser und Server dieselbe Zeichenfolge auslesen. ② encodeURI lässt reservierte Zeichen wie /, ?, :, & und = unverändert, um die Struktur der gesamten URL zu erhalten. encodeURIComponent geht dagegen davon aus, dass nur ein einzelner Wert kodiert wird, und ersetzt diese reservierten Zeichen ebenfalls durch %XX. ③ Enthält ein Wert für den Query-String (etwa ein Suchbegriff) ein & oder =, müssen Sie ihn mit encodeURIComponent statt mit encodeURI kodieren. Sonst wird das Zeichen fälschlich als Trennzeichen zwischen Parametern gelesen.
Die URL-Syntax erlaubt nur bestimmte Zeichen
Die URL-Syntax (genau genommen die URI-Syntax) teilt die verwendbaren Zeichen in zwei Gruppen ein. „Nicht reservierte Zeichen“ bestehen aus Buchstaben, Ziffern und einigen wenigen Symbolen (- _ . ~) und dürfen unverändert verwendet werden. „Reservierte Zeichen“ wie :, /, ?, #, [, ], @, !, $, &, ', (, ), *, +, ,, ;, = dienen als Trennzeichen, die die Struktur der Adresse gliedern (Schema, Host, Pfad, Query, Fragment).
Zeichen außerhalb dieser beiden Gruppen, also Leerzeichen oder Nicht-ASCII-Zeichen wie koreanische Buchstaben, sind in der URL-Syntax gar nicht vorgesehen. Gelangen sie unverändert in die Adresse, haben Browser und Server keinen Anhaltspunkt, wo ein Wert endet und wo die Adresse aufhört. Deshalb werden solche Zeichen zunächst in UTF-8-Bytes umgewandelt, und jedes einzelne Byte wird dann im Format %XX dargestellt.
Warum koreanische Schrift so lange %XX-Ketten erzeugt
Ein koreanisches Schriftzeichen belegt in UTF-8 in der Regel 3 Bytes. Weil die Prozentkodierung byteweise arbeitet, wird ein einzelnes Zeichen zu einer Kette aus drei %XX-Blöcken, etwa %EC%95%88. Bei den zwei Zeichen „안녕“ erscheint %XX entsprechend sechsmal.
Ein Buchstabe des lateinischen Alphabets ist in UTF-8 nur 1 Byte groß und braucht daher höchstens ein %XX oder gar keine Kodierung. Bei koreanischer Schrift wird das Ergebnis dagegen zwangsläufig länger. Das ist kein Fehler eines Tools oder Browsers, sondern liegt an der Funktionsweise der Zeichenkodierung selbst.
Warum encodeURI und encodeURIComponent unterschiedliche Ergebnisse liefern
JavaScript stellt zwei Kodierfunktionen bereit. encodeURI geht davon aus, dass es eine „bereits vollständige URL“ verarbeitet, und lässt Trennzeichen wie :, /, ?, & und = unverändert. Würden auch diese Zeichen kodiert, wäre die Struktur der Adresse zerstört.
encodeURIComponent geht dagegen davon aus, dass es „einen einzelnen Wert“ verarbeitet, der in eine URL eingefügt wird. Auch wenn in diesem Wert zufällig ein & oder = vorkommt, darf es nicht als Trennzeichen missverstanden werden. Deshalb ersetzt diese Funktion alle Zeichen, die als Trennzeichen wirken könnten, durch %XX.
Ein Beispiel: Ein vom Nutzer eingegebener Suchbegriff enthält ein &. Kodieren Sie ihn mit encodeURI, bleibt das & unverändert und lässt sich nicht von einem echten Trennzeichen zwischen Query-Parametern unterscheiden. Kodieren Sie ihn mit encodeURIComponent, wird das & zu %26, und es bleibt erhalten, dass es zum Wert gehört.
Um diesen Unterschied selbst zu prüfen, öffnen Sie die Konsole der Entwicklertools Ihres Browsers und geben dieselbe Zeichenfolge nacheinander in encodeURI und encodeURIComponent ein, um die Ergebnisse zu vergleichen. Jedes Mal die Konsole zu öffnen, die Funktionen neu zu tippen und die Ausgaben mit dem Auge abzugleichen, ist für jeden einzelnen Wert recht mühsam.
URL-Text einfügen und sofort per encodeURI, encodeURIComponent oder RFC 3986 kodieren und dekodieren: das Tool zur URL-Prozentkodierung
So zeigt das Tool den Unterschied zwischen encodeURI und encodeURIComponent
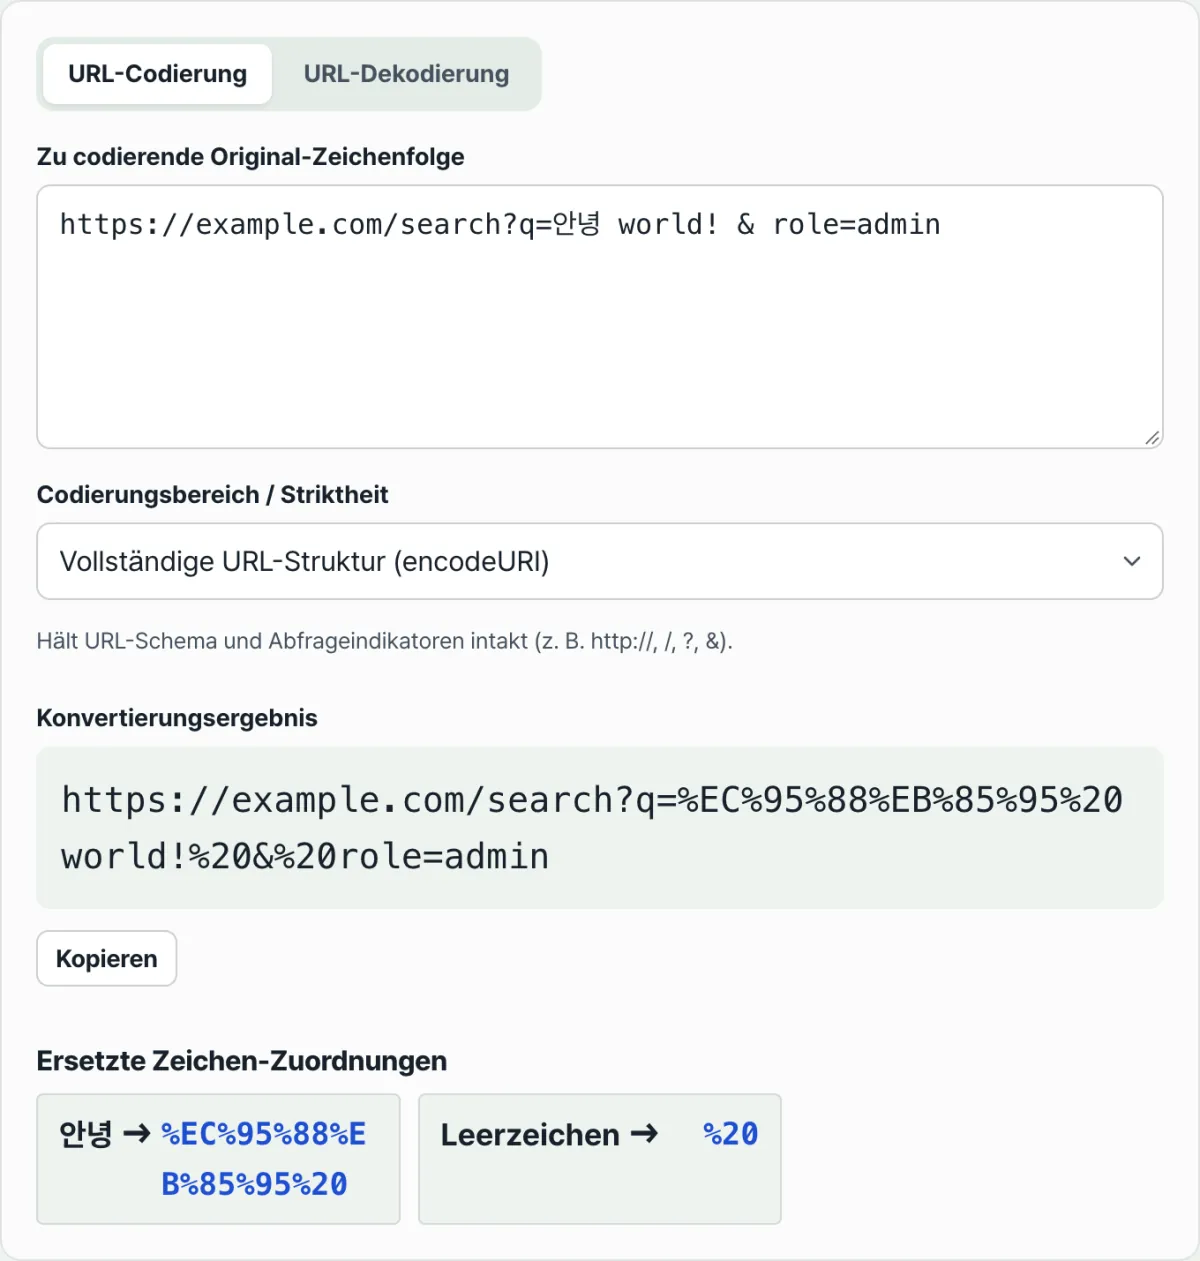
Das Tool zur URL-Prozentkodierung ist in zwei Tabs unterteilt: „URL-Kodierung (Encode)“ und „URL-Dekodierung (Decode)“. Im Tab zur Kodierung gibt es das Auswahlmenü „Kodierungsmodus (Bereich)“. Dort stehen drei Optionen zur Wahl: „Wert eines Query-Parameters (encodeURIComponent)“, „Gesamte URL-Struktur beibehalten (encodeURI)“ und „RFC-3986-Strict-Modus“.
Wenn Sie bei gleicher Eingabe nur dieses Menü umstellen, sehen Sie den zuvor beschriebenen Unterschied sofort im Ergebnis. Bei „Gesamte URL-Struktur beibehalten“ ändern sich nur die koreanischen Zeichen und das Leerzeichen, während &, =, : und / unverändert bleiben. Bei „Wert eines Query-Parameters“ werden auch diese Trennzeichen zu %XX. Beides können Sie auf demselben Bildschirm vergleichen.
Welche Zeichen ersetzt wurden, sehen Sie auf einen Blick
Unter dem Ergebnis erscheint eine eigene Tabelle mit dem Titel „Detaillierte Zuordnung der ersetzten Zeichen“. Sie listet Eintrag für Eintrag auf, welches Zeichen der Originalzeichenfolge durch welchen %XX-Code ersetzt wurde. Sie müssen also nicht allein anhand der Ergebnis-Zeichenfolge rückwärts nachvollziehen, welches Zeichen warum kodiert wurde.
Wollen Sie umgekehrt %XX-Zeichenfolgen aus einem Server-Log oder einer URL wieder in die ursprünglichen Zeichen zurückverwandeln, wechseln Sie einfach in den Tab „URL-Dekodierung“. Ist eine fehlerhafte Prozentkodierung enthalten, versucht das Tool nicht, sie zu erzwingen, sondern meldet einen Fehler. So halten Sie ein beschädigtes Ergebnis nicht versehentlich für den Originaltext.
Fazit
- Die URL-Syntax erlaubt nur bestimmte Zeichen (Buchstaben, Ziffern und einige Symbole). Leerzeichen, nicht lateinische Schrift und Sonderzeichen müssen als Prozentkodierung in der Form %XX geschrieben werden.
- Ein koreanisches Schriftzeichen belegt in UTF-8 3 Bytes pro Zeichen. Die Kodierung wird dadurch länger, nämlich zu drei aufeinanderfolgenden %XX-Blöcken.
- encodeURI lässt reservierte Zeichen wie :, /, ?, & und = unverändert, um die Struktur einer bereits vollständigen URL zu erhalten.
- encodeURIComponent geht davon aus, dass nur ein einzelner Wert verarbeitet wird, und kodiert auch diese reservierten Zeichen. Für Query-Parameter-Werte sollten Sie diese Funktion verwenden, damit ein & oder = im Wert nicht als Trennzeichen missverstanden wird.
- Wenn Sie unsicher sind, welche Variante die richtige ist, vergleichen Sie im Tool am schnellsten die Ergebnisse derselben Eingabe, indem Sie den Kodierungsmodus wechseln.
URL-Text einfügen und sofort per encodeURI, encodeURIComponent oder RFC 3986 kodieren und dekodieren: das Tool zur URL-Prozentkodierung
Häufig gestellte Fragen
Wann verwende ich encodeURI und wann encodeURIComponent?
Arbeiten Sie mit einer vollständigen URL, die Schema, Pfad und Query-Trennzeichen bereits enthält, nutzen Sie encodeURI. Geht es dagegen nur um einen einzelnen Wert (Suchbegriff, Nutzereingabe usw.), der an der Stelle eines Query-Parameters eingefügt wird, verwenden Sie encodeURIComponent. Dann kollidiert ein & oder = im Wert nicht versehentlich mit den Trennzeichen.
Warum sind Leerzeichen in einer URL ein Problem?
Das Leerzeichen ist in der URL-Syntax nicht definiert. Browser und Server können es nicht als Kriterium dafür nutzen, wo ein Wert endet und wo die Adresse aufhört. Deshalb muss ein Leerzeichen immer als Prozentkodierung geschrieben werden, etwa als %20.
Warum wird eine URL mit koreanischer Schrift so lang, etwa %EC%95%88%EB%85%95?
Bei der Kodierung in UTF-8 belegt ein koreanisches Schriftzeichen in der Regel 3 Bytes. Die Prozentkodierung ordnet jedem Byte genau ein %XX zu. Deshalb erscheint ein einzelnes koreanisches Zeichen als Kette aus drei %XX-Blöcken.
Warum tritt beim Dekodieren ein Fehler auf?
Die Dekodierfunktion meldet einen Fehler, wenn die Zeichenfolge nicht dem Format %XX folgt oder wenn die aneinandergereihten %XX-Bytes kein gültiges UTF-8-Zeichen ergeben. Dann ist möglicherweise die ursprüngliche Zeichenfolge bereits beschädigt, oder die Kodierung wurde versehentlich zweimal angewendet.
Dieser Artikel basiert auf unserem koreanischen Original. Koreanisches Original lesen