
URLエンコードとは?パーセントエンコーディングと文字化けの仕組み
目次
検索窓にハングルで検索語を入力したら、アドレスバーが%EC%9D%B4%EB%9F%B0のような文字だらけになった、という経験があるのではないでしょうか。逆に、自分で作ったリンクにハングルや空白をそのままつなげたせいでページが開かなかったり、サーバーがリクエストを妙な位置で切って受け取ったりすることもあります。
URLはそもそも、使える文字が決まっている文法です。その文法の外にある文字(空白、ハングル、絵文字、一部の特殊記号)は%XX形式のパーセントエンコードに変換しなければ、ブラウザとサーバーが同じ文字列として正確にやり取りできません。
まとめ ① URLの文法で使える文字は決まっていて、それ以外の文字(空白・ハングル・特殊文字)は%XX形式のパーセントエンコードに変えないと、ブラウザとサーバーが同じ文字列として解釈できません。 ② encodeURIはURL全体の構造を守るために /、?、:、&、= などの予約文字をそのまま残しますが、encodeURIComponentは値ひとつだけを扱うと想定して、そうした予約文字まで全部%XXに変えます。 ③ クエリ文字列に入れる値(検索語など)に&や=が混ざっているなら、encodeURIではなくencodeURIComponentでエンコードしないと、その文字がパラメータの区切り文字と誤認されます。
URLの文法で使える文字は決まっている
URL(正確にはURI)の文法は、使える文字を2つのグループに分けています。アルファベット・数字・一部の記号(- _ . ~)からなる「非予約文字」はそのまま書いてよく、:、/、?、#、[、]、@、!、$、&、'、(、)、*、+、,、;、= といった「予約文字」はアドレスの構造(スキーム、ホスト、パス、クエリ、フラグメント)を区切る区切り文字として使われます。
この2つのグループの外にある文字、つまり空白やハングルのような非ASCII文字は、そもそもURLの文法に定義されていません。ブラウザやサーバーの立場からすると、こうした文字がそのまま入ってくると、どこまでが値でどこでアドレスが終わるのかを判断する根拠がありません。そこでこうした文字はUTF-8のバイト列に変換したうえで、1バイトずつ%XX形式に置き換えて表現します。
ハングルだけがやたら長く%XXに伸びる理由
ハングル1文字は、UTF-8でエンコードすると通常3バイトを占めます。パーセントエンコードはバイト単位で行われるため、ハングル1文字は%EC%95%88のように%XXが3つ続く形に変わります。「안녕」の2文字なら、%XXが6回繰り返されるわけです。
英語のアルファベットはUTF-8で1バイトなので、%XXが1回で済むか、そもそもエンコードが不要です。一方、ハングルは構造上、エンコード結果が長くならざるを得ません。これはツールやブラウザの不具合ではなく、文字エンコーディング方式そのものの性質です。
encodeURIとencodeURIComponentで結果が変わる理由
JavaScriptはエンコード関数を2種類に分けて提供しています。encodeURIは「すでに完成したURL全体」を対象にすると想定し、:、/、?、&、= などの区切り文字をそのまま残します。これらの文字までエンコードしてしまうと、アドレスの構造そのものが壊れるからです。
一方、encodeURIComponentは「URLの中に差し込む値ひとつ」を対象にすると想定します。その値の中に&や=がたまたま入っていても区切り文字と誤解されてはいけないので、この関数は区切り文字になりうる文字まで全部%XXに変えます。
ユーザーが入力した検索語に&が含まれている場合を例にすると、encodeURIでエンコードするとその&はそのまま残り、実際のクエリパラメータの区切り文字と区別がつきません。一方、encodeURIComponentでエンコードすればその&は%26に変わり、値の一部であることがそのまま保たれます。
この違いを自分で確かめるには、ブラウザの開発者ツールのコンソールを開き、encodeURIとencodeURIComponentに同じ文字列をそれぞれ渡して結果を見比べる必要があります。毎回コンソールを開いて関数を打ち直し、結果を目で照合するのは、値をひとつ確認するたびに繰り返すには面倒です。
URL文字列を貼り付けるだけで、encodeURI・encodeURIComponent・RFC 3986の方式で即座にエンコード・デコードできる「URLパーセントエンコード解析(RFC 3986厳格モード)」
ツールがencodeURI・encodeURIComponentの違いを画面で示す仕組み
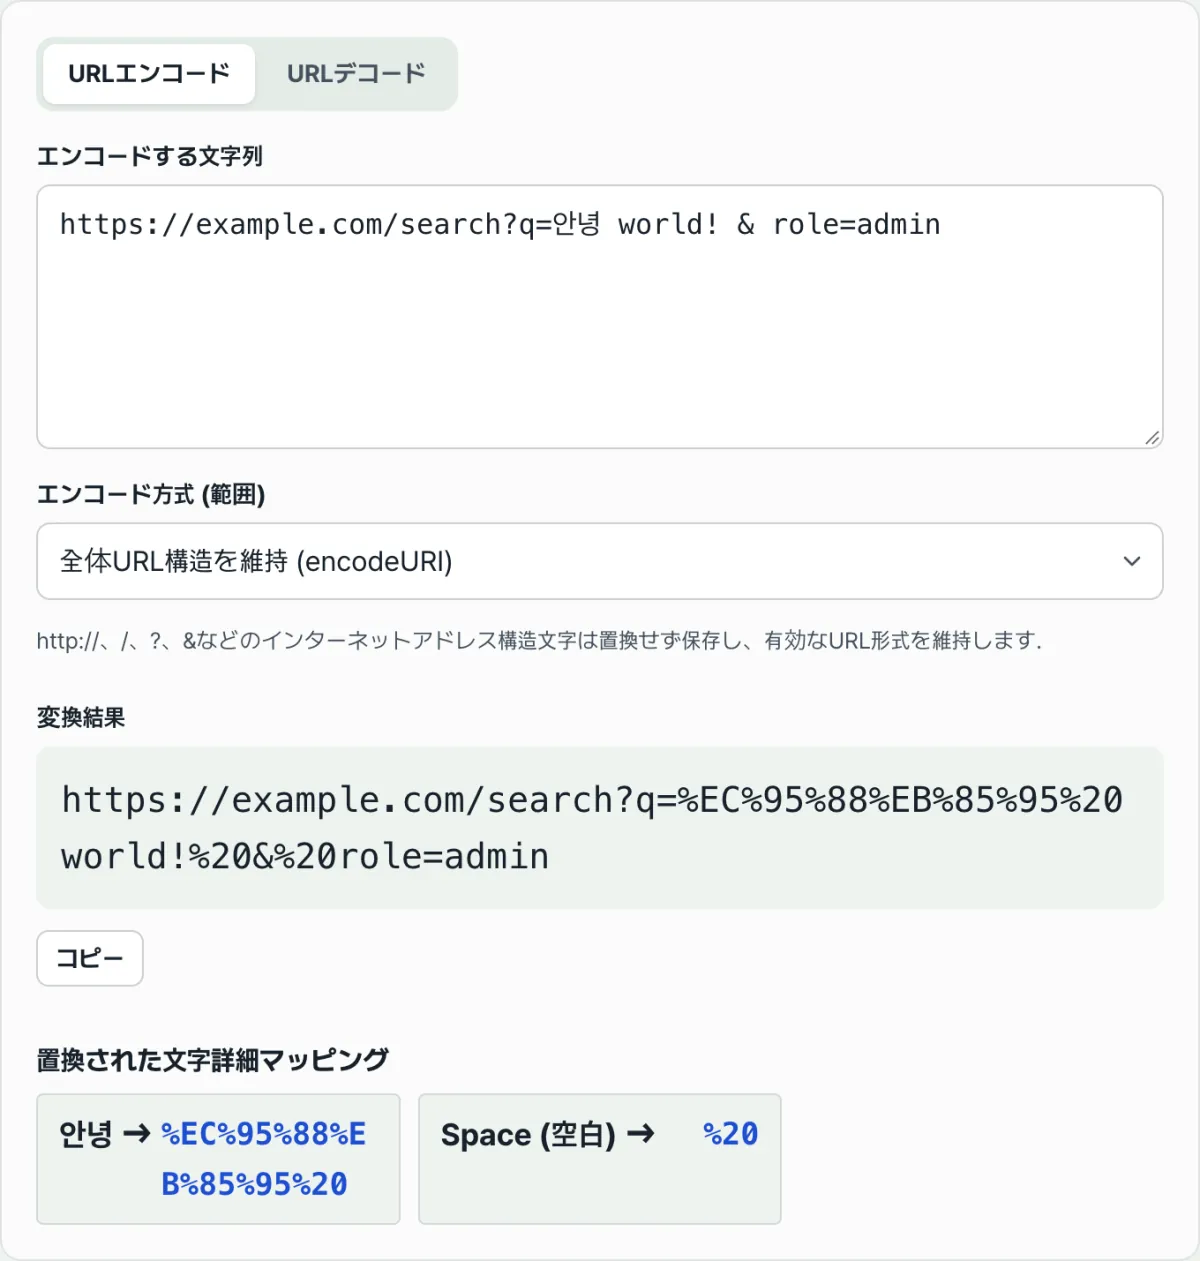
URLパーセントエンコード解析(RFC 3986厳格モード)は「URLエンコード(Encode)」と「URLデコード(Decode)」の2つのタブに分かれていて、エンコードタブには「エンコード方式(範囲)」の選択メニューがあります。このメニューから「クエリパラメータ値(encodeURIComponent)」「URL全体の構造を維持(encodeURI)」「RFC 3986 厳格モード」の3つを選べます。
同じ入力値のままこのメニューだけを切り替えてみると、先ほど説明した違いがそのまま目の前の結果として現れます。「URL全体の構造を維持」を選べばハングルと空白だけが変わり、&、=、:、/ はそのまま残り、「クエリパラメータ値」を選べばそれらの区切り文字まで全部%XXに変わるのを、同じ画面で比較できます。
どの文字が変わったかもひと目で確認できる
結果の下には「置換された文字の詳細マッピング」という表が別に表示され、元の文字列のどの文字がどの%XXコードに変わったのかを項目ごとに並べてくれます。ある文字がなぜエンコードされたのかを、結果の文字列だけから逆算する必要はありません。
逆に、サーバーログやURLに残った%XX文字列を元の文字に戻したいときは「URLデコード」タブに切り替えます。不正な形式のパーセントエンコードが混じっているときは無理に解釈せずエラーとして知らせてくれるので、壊れた値を元の文字と勘違いする事故を防げます。
まとめ
- URLの文法で使える文字(アルファベット・数字・一部の記号)は決まっていて、それ以外の空白・ハングル・特殊文字は%XX形式のパーセントエンコードに変える必要があります。
- ハングルはUTF-8で1文字あたり3バイトを占めるため、エンコードすると%XXが3つ続く形で長くなります。
- encodeURIは、すでに完成したURLの構造を守るために :、/、?、&、= などの予約文字をそのまま残します。
- encodeURIComponentは値ひとつだけを扱うと想定して予約文字まで全部エンコードするので、クエリパラメータの値にはこの関数を使い、値の中の&や=が区切り文字と誤認されないようにします。
- どの方式を選べばいいか迷ったときは、ツールでエンコード方式を切り替えながら、同じ入力値の結果をその場で比べてみるのが早道です。
URL文字列を貼り付けるだけで、encodeURI・encodeURIComponent・RFC 3986の方式で即座にエンコード・デコードできる「URLパーセントエンコード解析(RFC 3986厳格モード)」
よくある質問
encodeURIとencodeURIComponentはどちらを使えばいいですか?
スキームやパス、クエリの区切り文字までそろった完成済みのURL全体を扱うならencodeURIです。逆に、そのURLのクエリパラメータの位置に差し込む値ひとつ(検索語、ユーザー入力など)だけを扱うならencodeURIComponentを使い、値の中の&や=がうっかり区切り文字と重ならないようにします。
URLに空白をそのまま書くと、なぜ問題になるのですか?
空白はURLの文法に定義されていない文字です。ブラウザやサーバーは、どこまでがひとつの値でどこでアドレスが終わるかを、空白を基準に判断できません。そのため空白は必ず%20のようなパーセントエンコードに変える必要があります。
ハングルのURLが%EC%95%88%EB%85%95のように長くなるのはなぜですか?
ハングルはUTF-8でエンコードすると、1文字が通常3バイトを占めます。パーセントエンコードは1バイトごとに%XXを1つ対応させるので、ハングル1文字をエンコードすると%XXが3つ続く形で表れます。
デコード時にエラーが出るのはなぜですか?
%XX形式に従っていない文字列だったり、%XXのバイトをつなげても有効なUTF-8文字として完成しなかったりする場合、デコード関数はエラーを出します。そんなときは、元の文字列がすでに壊れている、あるいはエンコードが二重に適用された、といった可能性を疑ってみてください。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む