
Codificación URL: qué es el percent encoding y sus reglas
Contenido
- La gramática de las URL tiene un conjunto cerrado de caracteres permitidos
- Por qué el hangul se alarga tanto en forma de %XX
- Por qué encodeURI y encodeURIComponent dan resultados distintos
- Cómo muestra en pantalla la herramienta la diferencia entre encodeURI y encodeURIComponent
- También puedes ver de un vistazo qué caracteres cambiaron
- Para cerrar
- Preguntas frecuentes
Seguro que te ha pasado: escribes una búsqueda en coreano y ves que la barra de direcciones se llena de caracteres del tipo %EC%9D%B4. Y al revés: pegas un texto en coreano o un espacio dentro de un enlace que has construido a mano y la página no abre, o el servidor corta la petición donde no debe.
Una URL es, antes que nada, una gramática con un conjunto cerrado de caracteres permitidos. Cualquier carácter fuera de esa gramática (espacios, hangul, emojis, ciertos símbolos especiales) tiene que convertirse a la forma %XX de la codificación por porcentaje para que el navegador y el servidor intercambien exactamente la misma cadena.
Resumen ① Los caracteres que permite la gramática de las URL están definidos, y los que quedan fuera (espacios, hangul, caracteres especiales) deben convertirse a la forma %XX de la codificación por porcentaje para que el navegador y el servidor los interpreten como la misma cadena. ② encodeURI deja intactos los caracteres reservados como /, ?, :, & o = para no romper la estructura completa de la URL, mientras que encodeURIComponent asume que trabaja con un único valor y convierte también esos reservados a %XX. ③ Si el valor que va en la cadena de consulta (una búsqueda, por ejemplo) contiene & o =, hay que codificarlo con encodeURIComponent y no con encodeURI, para que ese carácter no se confunda con un separador de parámetros.
La gramática de las URL tiene un conjunto cerrado de caracteres permitidos
La gramática de las URL (en realidad, de las URI) divide los caracteres utilizables en dos grupos. Los «no reservados», formados por letras, dígitos y algunos símbolos (- _ . ~), se pueden escribir tal cual; los «reservados», como :, /, ?, #, [, ], @, !, $, &, ', (, ), *, +, ,, ;, =, funcionan como separadores que dividen la estructura de la dirección (esquema, host, ruta, consulta, fragmento).
Los caracteres que quedan fuera de esos dos grupos, es decir, los que no son ASCII como el espacio o el hangul, no están definidos en la gramática de las URL. Para un navegador o un servidor, si un carácter así aparece tal cual, no hay forma de saber dónde termina el valor y dónde acaba la dirección. Por eso estos caracteres se convierten primero a bytes UTF-8 y después cada byte se representa en formato %XX.
Por qué el hangul se alarga tanto en forma de %XX
Un carácter coreano en hangul ocupa normalmente 3 bytes cuando se codifica en UTF-8. La codificación por porcentaje trabaja byte a byte, así que un solo carácter se convierte en algo como %EC%95%88: tres %XX seguidos. Con dos caracteres como «안녕», el %XX se repite seis veces.
Las letras latinas ocupan 1 byte en UTF-8, así que bastan un %XX o directamente ninguna codificación; el hangul, en cambio, estructuralmente no puede evitar que el resultado sea más largo. No es un defecto de la herramienta ni del navegador, sino una característica del propio sistema de codificación de caracteres.
Por qué encodeURI y encodeURIComponent dan resultados distintos
JavaScript ofrece dos funciones de codificación con propósitos diferentes. encodeURI asume que trabaja con «una URL completa ya construida» y deja intactos separadores como :, /, ?, & o =. Codificarlos también rompería la estructura misma de la dirección.
encodeURIComponent, en cambio, asume que trabaja con «un único valor que se va a insertar dentro de una URL». Aunque ese valor contenga por casualidad un & o un =, no puede confundirse con un separador, así que la función convierte a %XX todos los caracteres que podrían actuar como separadores.
Pongamos el caso de una búsqueda escrita por el usuario que incluye un &: si la codificas con encodeURI, ese & se queda tal cual y resulta indistinguible del separador real entre parámetros de consulta. Si la codificas con encodeURIComponent, el & se convierte en %26 y queda registrado como parte del valor.
Para comprobar esta diferencia por tu cuenta tienes que abrir la consola de las herramientas de desarrollo del navegador y pasar la misma cadena a encodeURI y a encodeURIComponent para comparar los resultados. Abrir la consola, volver a escribir las funciones y contrastar los resultados a ojo cada vez que quieres verificar un valor es un engorro.
Una herramienta de codificación porcentual de URL: pega una cadena y codifícala o decodifícala al instante con encodeURI, encodeURIComponent y RFC 3986
Cómo muestra en pantalla la herramienta la diferencia entre encodeURI y encodeURIComponent
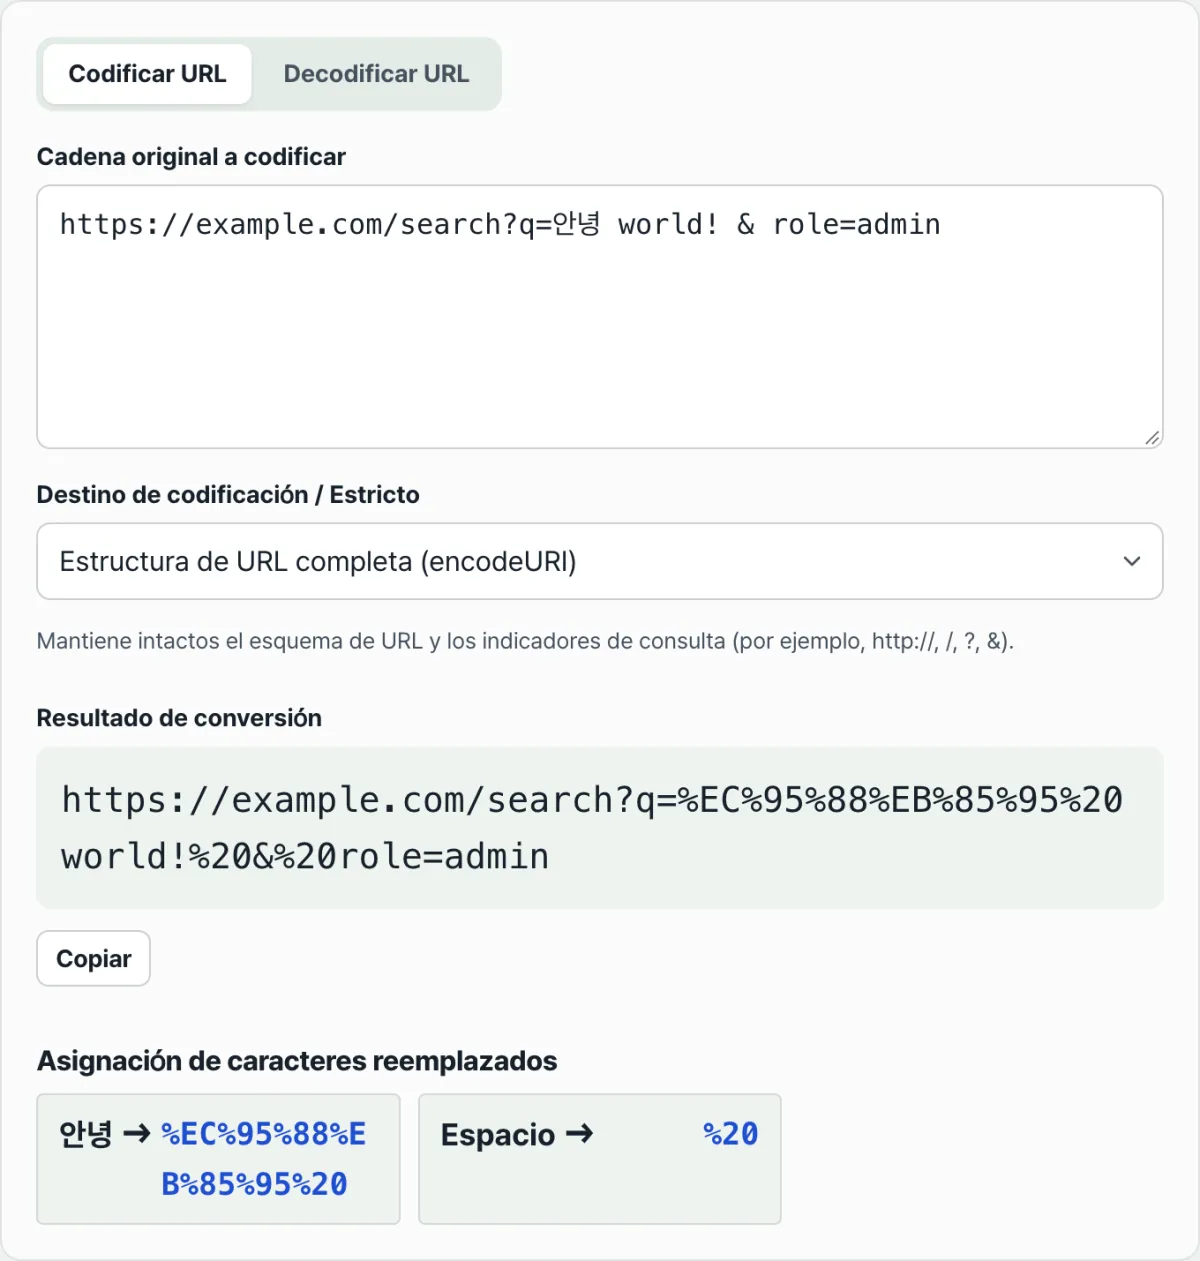
La herramienta encodeURI vs encodeURIComponent vs RFC 3986: qué cambia cada uno tiene dos pestañas, «Codificar URL» y «Decodificar URL», y en la de codificación hay un menú de selección llamado «Modo de codificación (alcance)». En ese menú puedes elegir entre tres opciones: «Valor de parámetro de consulta (encodeURIComponent)», «Mantener la estructura completa de la URL (encodeURI)» y «Modo estricto RFC 3986».
Si dejas la misma entrada y solo cambias ese menú, la diferencia que acabamos de explicar aparece delante de tus ojos. Con «Mantener la estructura completa de la URL» solo cambian el hangul y los espacios, y &, =, : y / se quedan igual; con «Valor de parámetro de consulta» esos separadores también se convierten a %XX, y puedes comparar ambas cosas en la misma pantalla.
También puedes ver de un vistazo qué caracteres cambiaron
Debajo del resultado aparece una tabla aparte llamada «Mapeo detallado de caracteres sustituidos», que enumera entrada por entrada qué carácter de la cadena original se convirtió en qué código %XX. Así no tienes que reconstruir a partir del resultado por qué se codificó cada carácter.
Al contrario, si quieres recuperar los caracteres originales de una cadena %XX que has visto en un log del servidor o en una URL, basta con cambiar a la pestaña «Decodificar URL». Si hay codificaciones por porcentaje con formato incorrecto, la herramienta no fuerza la interpretación y te avisa con un error, lo que evita que tomes un valor corrupto por el carácter original.
Para cerrar
- Los caracteres que permite la gramática de las URL (letras, dígitos y algunos símbolos) están definidos, y el resto —espacios, hangul, caracteres especiales— hay que convertirlo a la forma %XX de la codificación por porcentaje.
- El hangul ocupa 3 bytes por carácter en UTF-8, así que al codificarlo se alarga en forma de tres %XX seguidos.
- encodeURI deja intactos los caracteres reservados como :, /, ?, & o = para respetar la estructura de una URL ya completa.
- encodeURIComponent asume que trabaja con un único valor y codifica también esos reservados, así que para los valores de parámetros de consulta debes usar esta función y no otra: así un & o un = dentro del valor no se confunde con un separador.
- Cuando dudes sobre qué enfoque elegir, lo más rápido es cambiar el modo de codificación en la herramienta y comparar directamente el resultado para la misma entrada.
Una herramienta de codificación porcentual de URL: pega una cadena y codifícala o decodifícala al instante con encodeURI, encodeURIComponent y RFC 3986
Preguntas frecuentes
¿Cuál debo usar, encodeURI o encodeURIComponent?
Si trabajas con una URL completa que ya tiene esquema, ruta y separadores de consulta, usa encodeURI. Si, en cambio, trabajas solo con un valor que vas a insertar en un parámetro de consulta de esa URL (una búsqueda, lo que escribe el usuario, etc.), usa encodeURIComponent para que un & o un = dentro del valor no choque por error con un separador.
¿Por qué es un problema escribir un espacio tal cual en una URL?
El espacio es un carácter que no está definido en la gramática de las URL. Ni el navegador ni el servidor pueden usarlo como referencia para decidir dónde acaba un valor y dónde termina la dirección, así que hay que convertirlo obligatoriamente a una codificación por porcentaje como %20.
¿Por qué una URL en coreano sale tan larga, como %EC%95%88%EB%85%95?
Al codificar hangul en UTF-8, un carácter ocupa normalmente 3 bytes. La codificación por porcentaje asigna un %XX a cada byte, así que al codificar un solo carácter coreano aparece en forma de tres %XX seguidos.
¿Por qué da error al decodificar?
La función de decodificación devuelve un error cuando la cadena no sigue el formato %XX o cuando los bytes %XX concatenados no llegan a formar un carácter UTF-8 válido. En ese caso conviene sospechar que la cadena original ya estaba dañada o que la codificación se aplicó dos veces.
Este artículo está adaptado de nuestro original en coreano. Leer el original en coreano