
Diferencia entre 401 y 403: cómo distinguirlos de un vistazo
Contenido
Cuando llamas a una API o entras en un sitio web, muchas veces ves un código de error como 401 o 403 y no resulta fácil saber exactamente qué ha fallado. Los dos códigos llegan al mismo resultado —"acceso denegado"—, pero la causa que define el estándar HTTP es distinta en cada caso.
Este artículo explica cómo distinguir el carácter de un código por su primera cifra y en qué situaciones se produce cada una de las parejas de códigos que más se confunden en el trabajo diario: 401 y 403, 400 y 404, 502, 503 y 504.
Resumen ① El carácter de un código de estado HTTP se decide por su primera cifra: 1xx información, 2xx éxito, 3xx redirección, 4xx error del cliente, 5xx error del servidor ② El 401 es un fallo de autenticación (verificar la identidad); el 403 se da cuando la identidad está confirmada pero no hay permisos, así que las condiciones en que aparecen son distintas desde el principio ③ La forma más fiable de conocer el significado exacto no es adivinarlo, sino buscar el número, el título y la descripción y comprobarlo directamente
Por qué se confunden: situaciones habituales en la pestaña Red de las herramientas de desarrollo
Cuando integras una API de backend, es habitual ver un 401 o un 403 en la pestaña Red de las herramientas de desarrollo del navegador. En pantalla ambos aparecen de forma parecida como "petición fallida", pero si tratas como una misma causa dos códigos con definiciones distintas, acabarás sospechando de la parte equivocada cuando revises los registros.
Por ejemplo, si un usuario con la sesión caducada llama a la API, el servidor devuelve un 401; si un usuario que ha iniciado sesión pero no tiene permisos de administrador llama a una API exclusiva para administradores, devuelve un 403. No cambia solo el número del código: las condiciones en que se producen son diferentes desde el origen.
Del mismo modo, cuando entras en una página que no existe en un sitio web y cuando la petición en sí está mal formada, la respuesta se divide entre 404 y 400, y cuando el servidor no puede responder también se muestra un código distinto, 502, 503 o 504, según la causa.
Como hay cerca de 20 códigos y las categorías de la primera cifra se mezclan con los números concretos, es frecuente tener que consultar cada vez qué código corresponde a qué situación.
Cómo comprobarlo directamente en los documentos estándar
Los códigos de estado HTTP no son una lista arbitraria: los define el documento RFC que publica la IETF y la IANA los gestiona como registro oficial (HTTP Status Code Registry). Si quieres verificarlo por tu cuenta sin herramientas, estas dos fuentes son el método más exacto.
Paso 1: distinguir primero la categoría por la primera cifra
Un código de estado tiene tres cifras y la primera indica el carácter de la respuesta.
- 1xx (Informational): respuesta informativa que indica que la petición se ha recibido y se sigue procesando
- 2xx (Success): la petición se ha procesado correctamente
- 3xx (Redirection): para completar la petición hace falta una acción adicional (por ejemplo, ir a otra dirección)
- 4xx (Client Error): la petición tiene un problema y el servidor no puede procesarla
- 5xx (Server Error): la petición era correcta, pero ha fallado el procesamiento en el lado del servidor
Paso 2: buscar el número en el registro de la IANA
Con solo esta primera cifra ya puedes distinguir si el problema está del lado del cliente (4xx) o del servidor (5xx). El registro de códigos de estado HTTP que gestiona iana.org reúne todos los códigos registrados y las referencias al documento RFC que define cada uno.
La definición básica actual de los códigos de estado HTTP está recogida en el documento RFC 9110 (HTTP Semantics).
Paso 3: leer la frase de definición en el documento RFC
Si abres el documento RFC enlazado desde el registro, encontrarás la definición oficial de cada código. Por ejemplo, el 401 se define como que la petición necesita credenciales de autenticación del usuario, y el 403 como que el servidor ha entendido la petición pero se niega a autorizarla.
Esa diferencia en la redacción es el criterio que separa el 401 del 403. El método es exacto, pero requiere tiempo porque hay que buscar y leer el texto original en inglés del RFC para cada código.
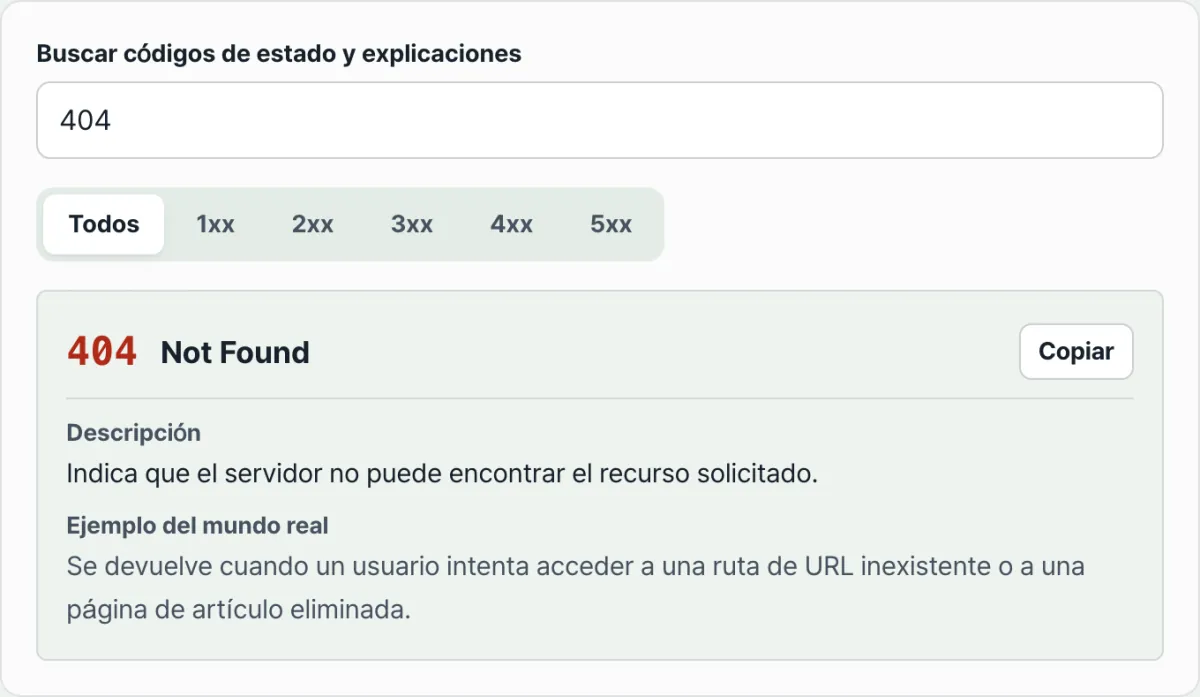
También puedes comprobar lo mismo buscando directamente por el número del código o por palabras clave en español. Pruébalo con nuestra herramienta gratuita, el Buscador de códigos de estado HTTP.
Si buscas un número o un nombre, verás al instante la descripción y ejemplos reales de los códigos de estado, del 100 al 500
Comparación de las parejas de códigos que más se confunden
401 y 403, 400 y 404: distinguir dentro de los 4xx
Por el nombre, 401 (Unauthorized) suena a "sin permisos" y se confunde fácilmente con el 403. Sin embargo, por definición el 401 es una respuesta sobre la autenticación (el procedimiento por el que el solicitante demuestra quién es) y el 403 es una respuesta sobre la autorización (si con esa identidad se puede acceder a este recurso).
El 401 se produce cuando no hay credenciales o son incorrectas; el 403, cuando las credenciales son correctas pero no se tienen permisos.
El 400 y el 404 también son 4xx, pero el momento en que surge el error es distinto. El 400 se devuelve cuando el servidor no entiende el formato de la petición en sí; el 404, cuando el formato de la petición es correcto pero no existe ningún recurso en esa dirección.
502, 503 y 504: distinguir dentro de los 5xx
El 502, el 503 y el 504 son todos errores 5xx del servidor, pero la causa varía. El 502 y el 504 comparten que se producen cuando la pasarela o el proxy se comunica con el servidor upstream (backend) que tiene detrás.
El 502 se produce cuando el upstream responde, pero esa respuesta en sí es incorrecta; el 504, cuando el upstream no responde en absoluto dentro del tiempo establecido.
El 503 se produce, al margen de la comunicación con el upstream, cuando el propio servidor está temporalmente sobrecargado o en mantenimiento y no puede procesar la petición.
| Código | Nombre | Diferencia clave | Ejemplo de aparición |
|---|---|---|---|
| 401 | Unauthorized | No hay credenciales de autenticación o no son válidas | Falta la cabecera Authorization, token caducado |
| 403 | Forbidden | La identidad está confirmada, pero no hay permisos de acceso | Un usuario normal intenta entrar en una página solo para administradores |
| 400 | Bad Request | Error de sintaxis o de formato en la propia petición | Falta un parámetro obligatorio, JSON mal formado |
| 404 | Not Found | El formato de la petición es correcto, pero el recurso no existe | Acceder a una URL que no existe |
| 502 | Bad Gateway | La respuesta del upstream es incorrecta en sí misma | Respuesta errónea porque el proceso de backend está caído |
| 503 | Service Unavailable | El propio servidor no puede procesar temporalmente | Aviso de mantenimiento, sobrecarga por un pico de tráfico |
| 504 | Gateway Timeout | La respuesta del upstream no llega a tiempo | La conexión se cierra por una consulta lenta en el backend |
En resumen
- Primero distingue el carácter por la primera cifra del código (1 a 5): información / éxito / redirección / error del cliente / error del servidor
- El 401 es un fallo de autenticación y el 403, falta de permisos una vez confirmada la identidad. A diferencia de lo que sugiere el nombre, el 401 es el código relacionado con la "autenticación"
- El 400 es un error de formato en la petición y el 404, ausencia del recurso. El momento en que surge el error es distinto
- El 502, el 503 y el 504 son todos 5xx, pero se distinguen así: el 502 es un error en la propia respuesta del upstream, el 503 es la incapacidad temporal del propio servidor para procesar y el 504 es el agotamiento del tiempo de respuesta del upstream
- La forma más fiable de conocer el significado exacto es buscar por número, título y descripción en lugar de adivinarlo
Si buscas un número o un nombre, verás al instante la descripción y ejemplos reales de los códigos de estado, del 100 al 500
Preguntas frecuentes
¿Cuál de los dos es un error más grave, el 401 o el 403?
El estándar HTTP no establece niveles de gravedad por código. Los dos se clasifican simplemente como errores 4xx del cliente y lo único que cambia es si la causa es un problema de autenticación o de permisos.
¿Cuál es exactamente la diferencia entre el 404 y el 400?
El 400 se devuelve cuando el servidor no entiende la sintaxis o el formato de la petición en sí. El 404 se devuelve cuando el formato de la petición se ha procesado correctamente, pero no se encuentra ningún recurso en la dirección solicitada. Es decir, la diferencia está en si el problema es la propia petición o si la petición es correcta pero el destino no existe.
Si el 502, el 503 y el 504 son todos problemas del servidor, ¿en qué se diferencian?
Los tres se clasifican como 5xx, pero la causa es distinta. El 502 se produce cuando la respuesta que la pasarela o el proxy recibe del servidor upstream es incorrecta en sí misma; el 504, cuando el servidor upstream no responde a tiempo.
El 503 se produce, al margen del upstream, cuando el propio servidor está sobrecargado o en mantenimiento y no puede procesar la petición.
¿Quién define los códigos de estado HTTP?
Los define el documento RFC que publica la IETF y la IANA los gestiona en una lista oficial llamada HTTP Status Code Registry. Cuando se añade un código nuevo o se actualiza una definición, queda reflejado en este registro.
Este artículo está adaptado de nuestro original en coreano. Leer el original en coreano