
Unicode-Escape umwandeln: \uXXXX, U+ und HTML-Entitäten
Inhalt
Hangul oder Emojis in Codes wie \uXXXX umzuwandeln und solche Codes wieder in das ursprüngliche Zeichen zurückzuverwandeln, beruht auf demselben Prinzip. Ein Zeichen wird als ganze Zahl gelesen, den sogenannten Codepoint. Unterschiedlich ist nur die Schreibweise, in der diese Zahl notiert wird.
Dieser Beitrag erklärt, was \uXXXX, \u{...}, U+Codepoint, dezimale und hexadezimale HTML-Entitäten sowie benannte Entitäten jeweils bedeuten und wie sie sich unterscheiden. Am Beispiel von Hangul, ©, ★ und 👍 zeigt er, wie ein einzelnes Zeichen in jedem Format aussieht.
Kurzfassung ① Alle sechs Formate schreiben nur den Codepoint (eine ganze Zahl) des Zeichens unterschiedlich auf. Das gemeinte Zeichen ist dasselbe, nur die Notation unterscheidet sich. ② Emojis oberhalb von U+FFFF werden nur im
\u-Format in zwei Teile eines Surrogatpaars (\ud83d\udc4d) zerlegt. Die übrigen Formate schreiben den Codepoint unverändert. ③ Benannte Entitäten (z. B.©) sind nur etwa 30 eingebaut. Zeichen ohne Namen werden stattdessen als numerische Entität (★) ausgegeben.
Wenn aus Hangul im Code \uc548\ub155 wird
In JSON-Dateien, Logs oder JavaScript-Quelltexten sind Ihnen bestimmt schon Hangul-Zeichen als fremd wirkende Codes wie \uc548\ub155 begegnet. Umgekehrt kommt es vor, dass man ein Copyright-Zeichen in HTML einfügen möchte, © aber nicht direkt verwenden will, und deshalb nach Schreibweisen wie © oder © sucht.
Das Zeichen ist dabei nicht kaputt. Es ist nur in einer Form notiert, die sich für Maschinen besser lesen lässt als für Menschen. Das Hangul-Zeichen „안“ sieht auf dem Bildschirm aus wie „안“, im Computer ist es aber das Zeichen mit der Nummer U+C548, und \uc548 ist genau diese Nummer in JavaScript-Syntax.
Das Problem ist, dass es nicht nur eine Schreibweise gibt. \uXXXX, \u{...}, U+, &#Zahl;, &#xZahl; und &name; bezeichnen alle dasselbe Zeichen und sehen nur verschieden aus. Daran scheitert man dann bei der Frage: „Was bedeutet das, und wie wandle ich es zurück?“
So wandeln Sie ohne Tool von Hand um
Am Anfang jeder Umwandlung steht der Codepoint des Zeichens. Wenn Sie in der Entwicklerkonsole des Browsers "©".codePointAt(0) ausführen, erhalten Sie 169. Um diese Dezimalzahl hexadezimal darzustellen, führen Sie (169).toString(16) aus und erhalten "a9".
Mit diesen beiden Zahlen (dezimal 169, hexadezimal a9) können Sie alle sechs Formate von Hand schreiben:
\uXXXX(JS): Die Hexzahl auf vier Stellen auffüllen und hinter\usetzen →\u00a9\u{...}(ES6): Die Hexzahl unverändert in geschweifte Klammern setzen →\u{a9}U+Codepoint: Die Hexzahl in Großbuchstaben mit vier Stellen schreiben →U+00A9&#DDD;(HTML dezimal): Die Dezimalzahl unverändert einsetzen →©&#xHH;(HTML hexadezimal): Die Hexzahl einsetzen →©&name;(benannte Entität): Falls es einen festgelegten Namen gibt, dieser Name →©
Wendet man dasselbe Vorgehen auf ©, ★ und 👍 an, ergibt sich die folgende Tabelle. Wenn Sie den Codepoint kennen, ist der Rest nur noch mechanisches Anwenden der Schreibregeln.
| Format | © (U+00A9) | ★ (U+2605) | 👍 (U+1F44D) |
|---|---|---|---|
\uXXXX (JS) | \u00a9 | \u2605 | \ud83d\udc4d |
\u{...} (ES6) | \u{a9} | \u{2605} | \u{1f44d} |
U+Codepoint | U+00A9 | U+2605 | U+1F44D |
&#DDD; (dezimal) | © | ★ | 👍 |
&#xHH; (hexadezimal) | © | ★ | 👍 |
&name; (Name) | © | ★ | 👍 |
Auch die Rückumwandlung von Code in ein Zeichen braucht nur dieselbe Zahl. Entnehmen Sie a9 aus \u00a9 und lesen es hexadezimal, erhalten Sie 169. Mit String.fromCodePoint(169) bekommen Sie wieder ©. © ist letztlich ebenfalls die Dezimalzahl 169, das Ergebnis ist also dasselbe.
Das ist der gesamte Ablauf ohne Tool. Bei mehreren Zeichen oder gemischten Formaten ist es allerdings mühsam, jedes Zeichen einzeln in die Konsole zu geben und das Ergebnis wieder zusammenzusetzen. Genau diese Wiederholungsarbeit nimmt Ihnen der Konverter ab.
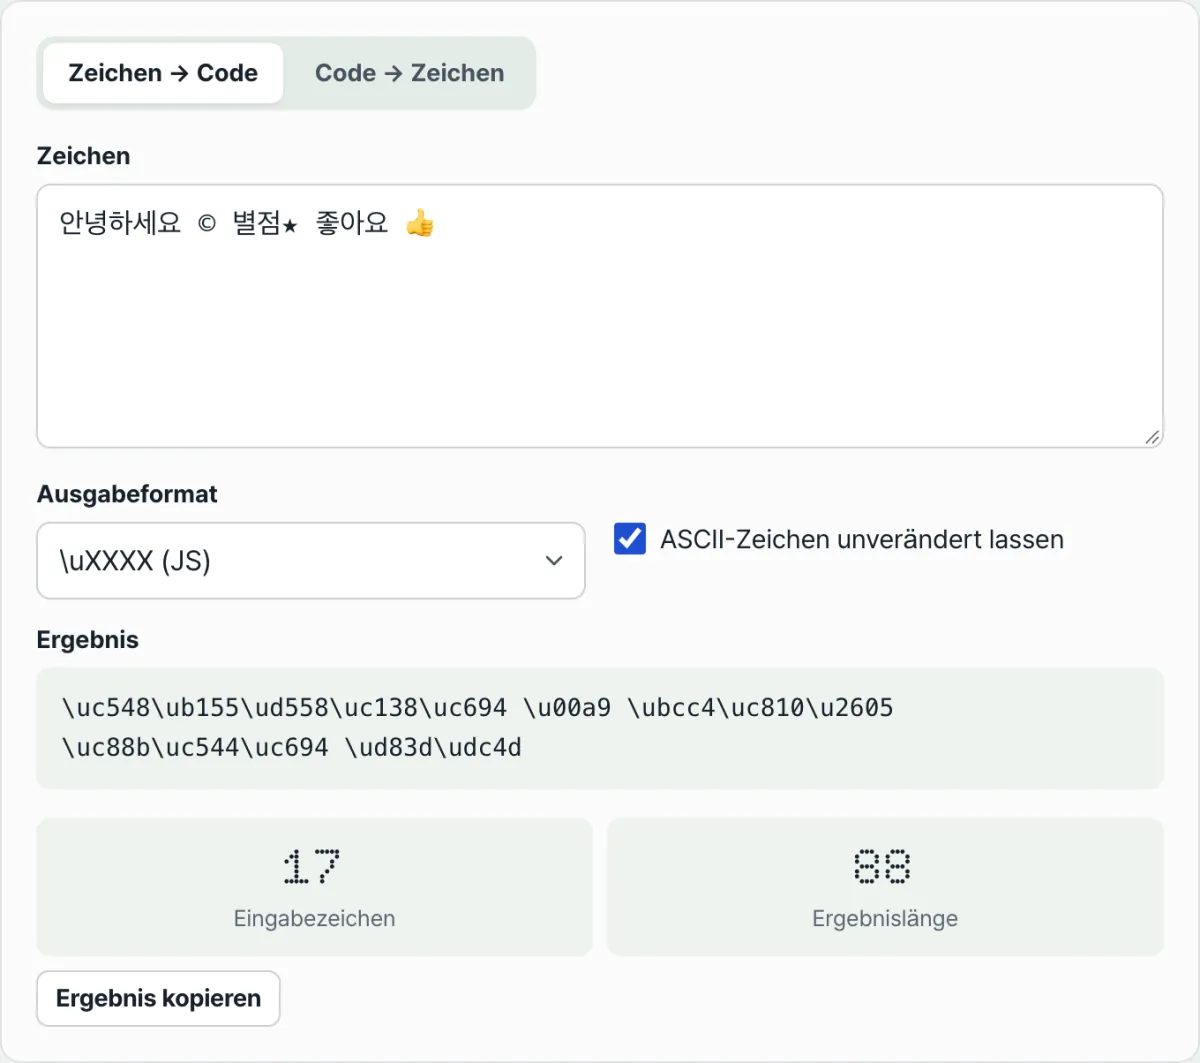
Mit unserem Unicode-Escape-Konverter prüfen.
Kostenloser Konverter, der direkt im Browser läuft – ohne Installation und Anmeldung. Unterstützt beide Richtungen: Zeichen → Code und Code → Zeichen.
Häufige Stolpersteine
Wenn ein Emoji in zwei Teile zerfällt
Wandeln Sie 👍 in \uXXXX um, erhalten Sie zwei Teile: \ud83d\udc4d. Das ist kein Fehler. \uXXXX kann nur vierstellige Hexzahlen (bis U+FFFF) aufnehmen, daher werden größere Zeichen als Paar aus zwei Werten dargestellt. Dieses Paar heißt Surrogatpaar.
Deshalb erscheint dasselbe Emoji in den Formaten \u{1f44d}, U+1F44D und 👍 als ein einziger Block. Diese Formate schreiben den Codepoint unverändert. Geben Sie den Code in den Reiter zur Wiederherstellung ein, erhalten Sie aus jedem dieser Formate wieder ein einzelnes 👍.
Unveränderte Zeichen und fehlende benannte Entitäten
Dass lateinische Buchstaben, Ziffern und einfache Sonderzeichen unverändert bleiben, ist ebenfalls normal. Die Option „ASCII-Zeichen unverändert lassen“ ist standardmäßig aktiviert. Zeichen mit den Codepoints 0x20 bis 0x7E (vom Leerzeichen bis zur Tilde) bleiben dann unangetastet, und nur Sonderzeichen werden umgewandelt. Schalten Sie diese Option aus, wird alles escaped, auch A wird dann zu \u0041.
Gut zu wissen ist auch, dass die Groß- und Kleinschreibung der Hexzahlen je nach Format variiert. Nur das Format U+ verwendet Großbuchstaben (U+00A9), \u, \u{...} und &#x geben Kleinbuchstaben aus (\u00a9, ©). Der gemeinte Wert ist derselbe, ein Unterschied in der Schreibweise bedeutet also nicht, dass es sich um ein anderes Zeichen handelt.
Nicht für jedes Sonderzeichen gibt es eine Entität der Form &name;. Eingebaut sind nur etwa 30 häufig genutzte. © wird zu ©, aber Zeichen ohne Namen wie ★ werden automatisch durch eine numerische Entität wie ★ ersetzt. Aus demselben Grund unterscheiden sich auch die Zahlen bei „Eingabezeichen“ und „Ergebnislänge“: 👍 ist als Eingabe ein Zeichen, im \uXXXX-Ergebnis aber zwölf Zeichen lang.
Zusammenfassung
Das Wichtigste in Kürze:
- Alle sechs Formate schreiben denselben Codepoint unterschiedlich auf. Die Bedeutung ist gleich, nur die äußere Form unterscheidet sich.
- Ausgangspunkt jeder Umwandlung ist der Codepoint. Mit
"Zeichen".codePointAt(0)erhalten Sie die ganze Zahl und schreiben sie dann nach den Regeln des jeweiligen Formats. \ufasst nur vier Stellen (bis U+FFFF). Größere Emojis werden deshalb in zwei Teile eines Surrogatpaars zerlegt. Die anderen Formate schreiben den Codepoint unverändert.- Da „ASCII-Zeichen unverändert lassen“ standardmäßig aktiv ist, bleiben lateinische Buchstaben, Ziffern und einfache Sonderzeichen erhalten, und nur Sonderzeichen werden umgewandelt.
- Benannte Entitäten gibt es nur etwa 30. Fehlt ein Name, gibt der Konverter automatisch eine numerische Entität aus.
Kostenloser Konverter, der direkt im Browser läuft – ohne Installation und Anmeldung. Unterstützt beide Richtungen: Zeichen → Code und Code → Zeichen.
Häufig gestellte Fragen
Mein Emoji wird im \u-Format in zwei Teile zerlegt. Ist das ein Fehler?
Nein. \uXXXX kann nur vierstellige Hexzahlen (bis U+FFFF) darstellen, größere Zeichen werden deshalb als Surrogatpaar aus zwei \u-Werten geschrieben (\ud83d\udc4d). Die Formate \u{1f44d}, U+1F44D und 👍 erscheinen als ein Block. Geben Sie den Code in den Reiter zur Wiederherstellung ein, erhalten Sie aus jedem Format wieder ein einzelnes 👍.
Warum werden lateinische Buchstaben und Ziffern nicht umgewandelt?
Weil die Option „ASCII-Zeichen unverändert lassen“ standardmäßig aktiviert ist. Zeichen mit den Codepoints 0x20 bis 0x7E (Leerzeichen, Buchstaben, Ziffern und einfache Sonderzeichen) bleiben unverändert, nur Sonderzeichen werden umgewandelt. Schalten Sie die Option aus, wird alles escaped, auch A wird dann zu \u0041.
Kann ich auch Code mit gemischten Formaten auf einmal zurückwandeln?
Ja. Der Reiter zur Wiederherstellung erkennt \u{...}, \uXXXX, \xXX, U+XXXX, &#xHH;, &#DDD; und benannte Entitäten jeweils einzeln. Geben Sie zum Beispiel 안녕 © U+1F44D ein, wird daraus in einem Schritt 안녕 © 👍.
Gibt es für jedes Sonderzeichen eine Entität der Form &name;?
Nein. Eingebaut sind nur etwa 30 häufig genutzte Namen. © wird zu © und € zu €, aber Zeichen ohne festgelegten Namen wie ★ werden durch eine numerische Entität wie ★ ersetzt. Für Zeichen ohne Namen gibt der Konverter also automatisch eine numerische Entität aus.
Dieser Artikel basiert auf unserem koreanischen Original. Koreanisches Original lesen