
Unicodeエスケープ変換と復元、6つの形式の違いを整理
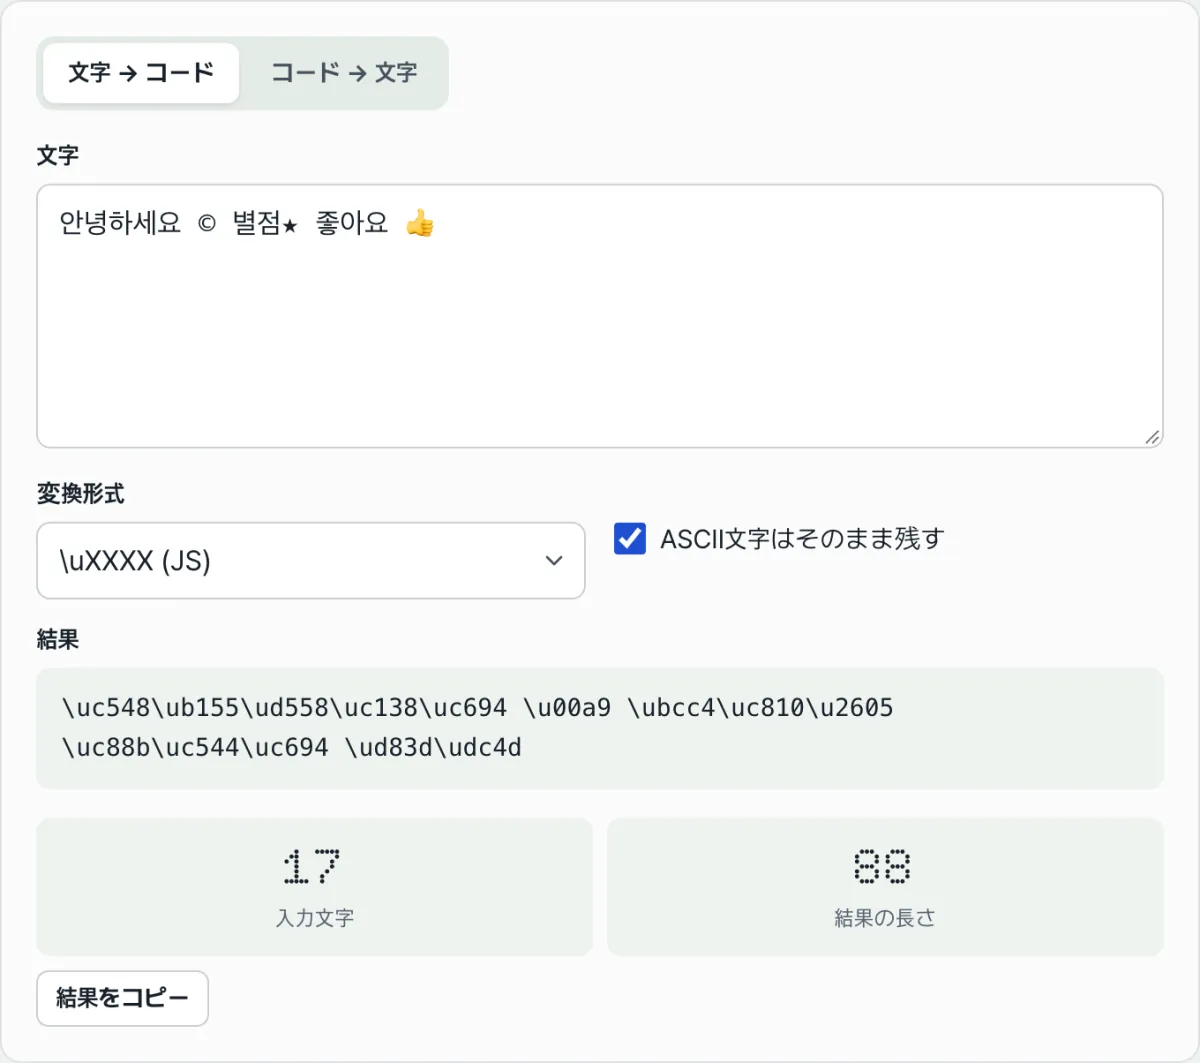
ハングルや絵文字を \uXXXX のようなコードに変換するのも、逆にそのコードを元の文字へ戻すのも、原理は1つです。文字を「コードポイント」という1つの整数として読み取り、その整数をどの表記法で書くかという違いにすぎません。
この記事では、\uXXXX・\u{...}・U+コードポイント・HTMLの10進エンティティと16進エンティティ・名前エンティティがそれぞれ何を意味し、どう違うのか、1つの文字が各形式でどんな姿になるのかを、ハングル・©・★・👍 の例で整理します。
要点 ① 6つの形式はどれも、文字の「コードポイント」(1つの整数)を書き分けただけなので、指し示す文字は同じで表記だけが異なります。 ② U+FFFFを超える絵文字は
\u形式でのみサロゲートペア2つ分(👍)に分割され、ほかの形式はコードポイントをそのまま書きます。 ③ 名前エンティティ(©など)は約30個しか組み込まれていないため、名前のない文字は数値エンティティ(★)で代用表示されます。
コードの中でハングルが 안녕 に見えるとき
JSONファイルやログ、JavaScriptのソースで、ハングルが 안녕 のような見慣れないコードで出力されているのを見たことがあるでしょう。逆に、HTMLに著作権記号を入れたいけれど © をそのまま書くのは避けたいので、© や © のような表記を探すこともあると思います。
これは文字が壊れているのではなく、同じ文字を人間ではなく機械が読みやすい形で書き留めただけです。ハングルの「안」は画面では「안」ですが、コンピューターの中では U+C548 という番号を持つ文字であり、안 はその番号をJavaScriptの文法で書いたものにすぎません。
問題は、この表記法が1つではないことです。\uXXXX、\u{...}、U+、&#数値;、&#x数値;、&名前; はどれも同じ文字を指しながら、見た目だけが異なります。そのため「これはどういう意味で、どう戻せばいいのか」というところで手が止まります。
ツールを使わずに自分で変換する方法
すべての変換の出発点は、文字のコードポイントを求めることです。ブラウザの開発者コンソールで "©".codePointAt(0) を実行すると 169 が返ります。この10進数を16進数で見るには (169).toString(16) を実行すると "a9" が返ります。
あとはこの2つの数値(10進の169、16進のa9)さえあれば、6つの形式を手で書けます。
\uXXXX(JS): 16進数を4桁に埋めて\uの後ろに付けます →©\u{...}(ES6): 16進数をそのまま中かっこに入れます →\u{a9}U+コードポイント: 16進数を大文字4桁で書きます →U+00A9&#DDD;(HTML 10進): 10進数をそのまま入れます →©&#xHH;(HTML 16進): 16進数を入れます →©&name;(名前エンティティ): 決まった名前があればその名前 →©
同じ方法を ©・★・👍 に当てはめると、次の表になります。コードポイントさえ分かれば、あとは表記のルールに従って書くだけの機械的な作業です。
| 形式 | © (U+00A9) | ★ (U+2605) | 👍 (U+1F44D) |
|---|---|---|---|
\uXXXX (JS) | © | ★ | 👍 |
\u{...} (ES6) | \u{a9} | \u{2605} | \u{1f44d} |
U+コードポイント | U+00A9 | U+2605 | U+1F44D |
&#DDD; (10進) | © | ★ | 👍 |
&#xHH; (16進) | © | ★ | 👍 |
&名前; (名前) | © | ★ | 👍 |
逆にコードを文字に戻すのも、同じ数値さえあれば大丈夫です。© から a9 を取り出して16進数として読めば169で、String.fromCodePoint(169) を実行すれば再び © が得られます。© も結局は10進数の169なので、結果は同じです。
ここまでが、ツールを使わずに行う全工程です。ただし、文字が複数あったり形式が混在していたりすると、1文字ずつコンソールに入れて組み立て直すのは面倒です。その繰り返し作業だけを代わりにやってくれるのが、この変換ツールです。
無料ツールで確認する。
インストールも登録も不要で、ブラウザ上ですぐに動く無料の変換ツールです。文字 → コード、コード → 文字の双方向に対応しています。
よく混乱しやすいポイント
絵文字が2つに分割されるとき
👍 を \uXXXX に変えると、👍 のように2つに分かれます。エラーではありません。\uXXXX は16進数4桁(U+FFFF)までしか収められないため、それより大きい文字は2つを組み合わせて表現するように決められています。この組み合わせをサロゲートペアと呼びます。
そのため、同じ絵文字でも \u{1f44d}、U+1F44D、👍 の形式では1つのかたまりで出力されます。これらの形式はコードポイントをそのまま書くからです。「復元」タブに入れれば、どの形式でも再び1つの 👍 に戻ります。
変換されない文字と、存在しない名前エンティティ
英字・数字・基本記号がそのまま残るのも正常です。「ASCII文字はそのまま残す」オプションが初期状態でオンになっているため、コードポイント 0x20~0x7E(空白からチルダまで)に当たる文字は変換せず、特殊文字だけを変換します。このチェックを外すと、A も A のようにすべてエスケープされます。
16進表記の大文字・小文字が形式ごとに違う点も覚えておくと混乱が減ります。U+ 形式だけが大文字(U+00A9)で、\u・\u{...}・&#x は小文字(©、©)で出力されます。指している値は同じなので、大文字・小文字の違いで別の文字だと誤解する必要はありません。
すべての特殊文字に &名前; があるわけでもありません。よく使う約30個だけが組み込まれていて、© は © と出力されますが、★ のように名前のない文字は自動的に ★ のような数値エンティティで置き換えられます。画面の「入力文字」と「結果の長さ」の数字が違うのも同じ理由で、👍 は入力としては1文字ですが、\uXXXX の結果としては12文字になります。
まとめ
要点だけを抜き出すと、次のとおりです。
- 6つの形式はどれも、同じコードポイントを書き分けたものです。意味は同じで、外側の表記だけが違います。
- 変換の出発点はコードポイントです。
"文字".codePointAt(0)で整数を求め、あとは形式ごとのルールどおりに書けば済みます。 \uは4桁(U+FFFF)までしか収められないので、それより大きい絵文字はサロゲートペア2つに分かれます。ほかの形式はコードポイントをそのまま使います。- 「ASCII文字はそのまま残す」が初期設定なので、英字・数字・基本記号はそのまま残し、特殊文字だけを変換します。
- 名前エンティティは約30個しかないため、名前がない場合は変換ツールが自動的に数値エンティティで表示します。
インストールも登録も不要で、ブラウザ上ですぐに動く無料の変換ツールです。文字 → コード、コード → 文字の双方向に対応しています。
よくある質問
絵文字を \u 形式に変換したら2つに分かれました。エラーですか?
いいえ。\uXXXX は16進数4桁(U+FFFF)までしか表現できないため、それより大きい文字は2つの \u を組み合わせたサロゲートペア(👍)で表します。\u{1f44d}、U+1F44D、👍 の形式なら1つのかたまりで出力され、「復元」タブに入れればどの形式でも再び1つの 👍 に戻ります。
英字と数字はなぜ変換されないのですか?
「ASCII文字はそのまま残す」オプションが初期状態でオンになっているためです。コードポイント 0x20~0x7E に当たる文字(空白・英字・数字・基本記号)はそのまま残し、特殊文字だけを変換します。このオプションをオフにすると、A も A のようにすべてエスケープされます。
複数の形式が混ざったコードも一度に元に戻せますか?
できます。「復元」タブは \u{...}、\uXXXX、\xXX、U+XXXX、&#xHH;、&#DDD;、名前エンティティをそれぞれ認識します。たとえば 안녕 © U+1F44D を入れると、안녕 © 👍 に一度で復元されます。
すべての特殊文字に &名前; エンティティはありますか?
いいえ。よく使う約30個の名前だけが組み込まれています。© は ©、€ は € のように出力されますが、★ のように指定された名前がない文字は ★ のような数値エンティティで置き換えられます。そのため、名前のない文字は変換ツールが自動的に数値エンティティで表示します。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む