
URLエンコードで空白が%20になる理由と仕組み
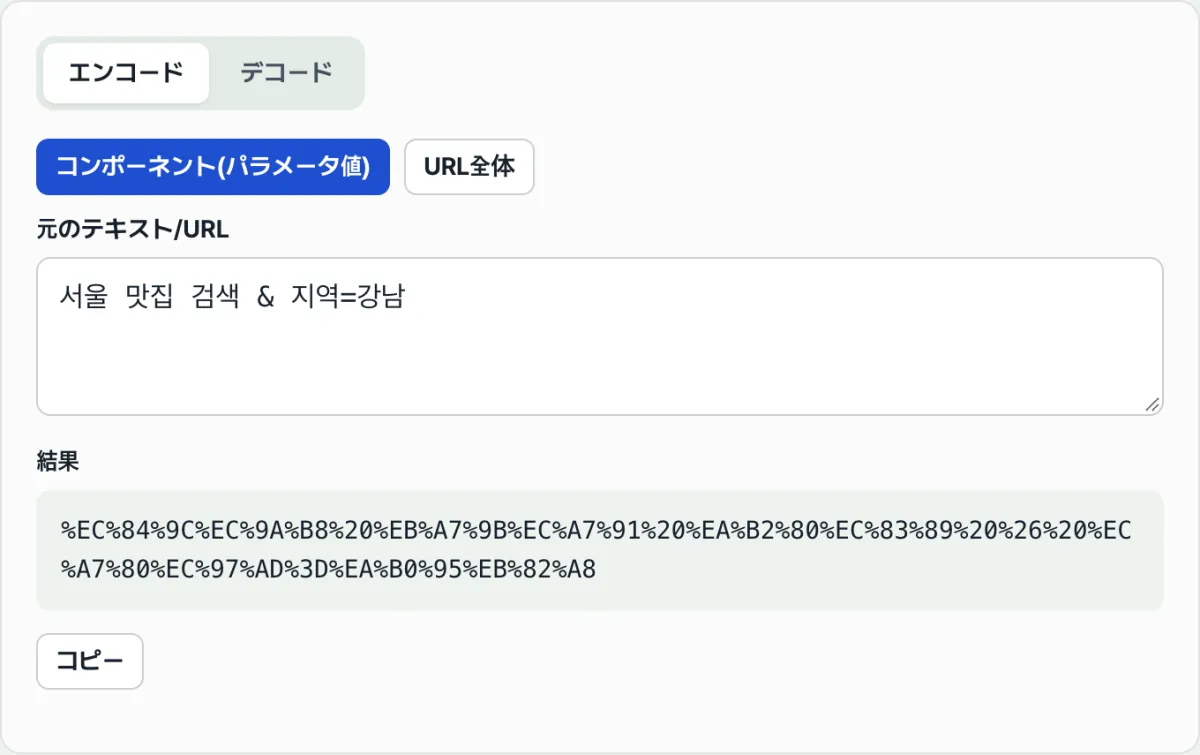
検索語にハングルや空白を入れたら、アドレスが %ED%95%9C%EA%B8%80%20 のような意味不明な記号だらけになってしまった——そんな経験がある人に向けた記事です。結論から言うと、URLにはハングル・空白・一部の特殊文字をそのまま入れることができないため、ブラウザが決められた規則で置き換えているのです。
規則は2つだけです。ひとつは文字をUTF-8のバイト列に分解し、各バイトを %XX と書くこと、もうひとつはどこまで変換するか(URL全体か、パラメータの値か)を決めるモードです。この2つさえ押さえれば、%20 がなぜ空白なのか、%EA%B0%80 がなぜ「가」なのか、すべて読み解けます。
要点 ① 空白は
%20、ハングルの「가」は%EA%B0%80— 文字をUTF-8バイトに変換し、バイトごとに%と16進数2桁を付けます。 ② 構成要素モード(encodeURIComponent)は/ ? & =のような構造文字まで変換し、URL全体モード(encodeURI)はその構造文字を温存します。 ③ よくある失敗は、完成したアドレス全体を構成要素モードでエンコードして構造を壊してしまうこと、すでにエンコード済みの文字列をもう一度エンコードしてしまうこと(二重エンコード)です。
なぜこんな記号に変わってしまうのか
検索結果や地図のリンクをコピーしてメッセンジャーに貼ったら、アドレスが .../search?q=%ED%95%9C%EA%B8%80%20%EA%B0%92 のようになっていて、何を検索したのか目で読めない、というのが典型的な例です。
逆方向のケースもあります。クエリパラメータにハングルをそのまま入れてリンクを作ったら、ある場所では問題なく開き、別の場所ではリンクが途中で切れて開いてしまう場合です。URLの標準は使える文字を制限しているため、ハングルや空白はパーセントエンコーディングを経ないと安全に伝わりません。
つまり問題は「文字が壊れた」ことではなく、「規則どおりに変換された状態を人間が読めない」ことです。規則さえ分かれば、すぐに元に戻して読めます。
ツールなしで自分で確かめる方法
パーセントエンコーディングは2段階の規則です。ツールがなくても、手作業で、あるいはブラウザにすでに入っている機能で確認できます。
1段階 — どの文字を変換するか。 英字・数字と - _ . ~ のような一部の記号はURLにそのまま使えるので変換されません。それ以外の空白・ハングル・?・& などは変換が必要です(パーセントエンコーディングの規則を定めたRFC 3986に基づく)。
2段階 — どう変換するか。 変換が必要な文字をUTF-8バイトにしてから、バイト1つずつを % +16進数2桁で書きます。
- 空白はASCIIコードが16進数で
20なので、そのまま%20になります。 - ハングルの「가」はUTF-8で
EA B0 80の3バイトなので、3つの塊がつながって%EA%B0%80になります。ハングル1文字がふつう%XX3つに分かれて出てくるのはこのためです。
ブラウザにはこの機能がすでに入っています。開発者ツール(多くはF12)のコンソールで以下をそのまま入力すると、同じ結果が得られます。
encodeURIComponent("한글 값")   // → "%ED%95%9C%EA%B8%80%20%EA%B0%92"
decodeURIComponent("%EA%B0%80") // → "가"
ここでモードが分かれます。パラメータの値ひとつだけを変換するときは encodeURIComponent(構成要素)、アドレス全体をまとめて変換するときは encodeURI(URL全体)を使います。両者の違いは次の表で扱います。
問題は、コンソールを開いて関数名を正確に打たなければならず、エンコード/デコードと2つのモードを行き来するたびに入力し直さなければならないことです。
Dynamic Labsの無料ツールで確認する。
インストールも会員登録も不要で、ブラウザ上ですぐにエンコード・デコードできます。入力した値はサーバーに送信されません。
間違えやすい3つのポイント
最も食い違いやすいのはモードの選択です。同じ文字列でも、どのモードを使うかで / ? & = のような構造文字の結果が変わります。
アドレス https://site.com/search?q=한글 값&p=2 を2つのモードで変換すると、次のようになります。
| 文字 | URL全体(encodeURI) | 構成要素(encodeURIComponent) |
|---|---|---|
/ ? & = | そのまま保持 | %2F %3F %26 %3D にエンコード |
| 空白 | %20 | %20 |
| ハングル | UTF-8バイトでエンコード | UTF-8バイトでエンコード |
- URL全体モード:
https://site.com/search?q=%ED%95%9C%EA%B8%80%20%EA%B0%92&p=2— 構造は生きており、ハングルと空白だけが変わります。 - 構成要素モード:
https%3A%2F%2Fsite.com...%3Fq%3D...%26p%3D2—:/?=&まで全部変わり、アドレスとして使うと構造が壊れます。
そのため、完成したアドレス全体を構成要素モードでエンコードしてしまうのが1つ目のよくある失敗です。パラメータの「値ひとつ」だけを入れる場所には構成要素モードが合っていますが、完成したアドレス全体にはURL全体モードが合っています。
2つ目は二重エンコードです。すでにエンコードされた %EA%B0%80 をもう一度エンコードすると、% そのものが %25 に変わって %25EA%25B0%2580 になります。1回デコードしても元の文字ではなく %EA%B0%80 という文字列がそのまま出てくるなら、二重エンコードを疑ってください。
3つ目はデコードの失敗です。% の後には16進数2桁が来る必要がありますが、%EA%B0%8 のように桁が足りない、あるいは %GG のように16進数でない場合はデコードできません。そのときツールは赤い警告(「デコードできない文字列です」)を表示し、結果を空欄にします。
まとめ
- URLに入れられない空白・ハングルは、UTF-8バイトごとに
%+16進数2桁に変わります。空白は%20、「가」は%EA%B0%80です。 - 構成要素モード(encodeURIComponent)は
/ ? & =まで変換し、URL全体モード(encodeURI)はこの構造文字を温存します。 - 完成したアドレス全体を構成要素モードで変換すると構造が壊れます。値ひとつ=構成要素、アドレス全体=URL全体と使い分ければ大丈夫です。
- すでにエンコード済みの文字列をもう一度エンコードすると、
%が%25になります(二重エンコード)。 - デコードは
%+16進数2桁が正しく揃っている必要があり、ずれているとツールは警告とともに結果を空欄にします。
インストールも会員登録も不要で、ブラウザ上ですぐにエンコード・デコードできます。入力した値はサーバーに送信されません。
よくある質問
空白はなぜ%20になるのですか?「+」で出てくることもありますが。
空白のASCIIコードは16進数で 20 なので、パーセントエンコーディングでは %20 になります。+ に見えるのは、HTMLフォームの送信で使われる application/x-www-form-urlencoded 方式が空白を + と書くためです。このツールが使う encodeURIComponent/encodeURI は、空白を常に %20 に変換します。
ハングルが%EA%B0%80のように3つに分かれるのはなぜですか?
ハングルはUTF-8でエンコードすると、ふつう3バイトを占めるためです。「가」は EA B0 80 の3バイトで、それぞれを %EA %B0 %80 と書いて %EA%B0%80 になります。文字が壊れたのではなく、バイト単位で正確に表現された状態であり、デコードモードに貼り付ければ「가」に戻ります。
encodeURIとencodeURIComponentは何が違うのですか?
変換する範囲が違います。URL全体モード(encodeURI)は / ? & = : のようなアドレス構造の文字はそのままにし、ハングルと空白だけを変換します。構成要素モード(encodeURIComponent)はその構造文字まで全部変換します。そのため、完成したアドレス全体にはURL全体モードを、パラメータの値ひとつには構成要素モードを使います。
デコードしたときに赤い警告が出るのはなぜですか?
% の後に来る2桁が正しい16進数でないときです。%EA%B0%8 のように1桁足りない、あるいは %GG のように16進数でない文字が来ると、ブラウザのデコード関数が処理できず、ツールは警告を表示して結果を空欄にします。エンコード済みの文字列の一部だけをコピーしていないか確認してみてください。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む