
Conversión de escape Unicode: \uXXXX, U+ y entidades HTML
Contenido
Convertir texto coreano o emojis en códigos como \uXXXX, y hacer lo contrario —devolver esos códigos a los caracteres originales—, parte siempre del mismo principio: se lee el carácter como un único número entero llamado «punto de código» y lo único que cambia es la notación con la que se escribe ese número.
Este artículo explica qué significa cada formato —\uXXXX, \u{...}, U+punto de código, las entidades HTML decimales y hexadecimales y las entidades con nombre—, en qué se diferencian entre sí y qué aspecto toma un mismo carácter en cada uno, con ejemplos de texto coreano, ©, ★ y 👍.
Resumen ① Los seis formatos no son más que formas distintas de escribir el «punto de código» de un carácter (un único entero): apuntan al mismo carácter y solo cambia la notación. ② Los emojis por encima de U+FFFF solo se parten en las dos mitades de un par sustituto (
👍) en el formato\u; el resto de formatos escribe el punto de código tal cual. ③ Solo hay unos 30 nombres de entidad integrados (©, etc.), así que los caracteres sin nombre se muestran con una entidad numérica (★).
Cuando el coreano aparece como 안녕 en el código
Seguro que has visto texto coreano impreso como códigos extraños del estilo 안녕 en un archivo JSON, en un log o en el código fuente de JavaScript. Y también puede pasar lo contrario: necesitas poner el símbolo de copyright en HTML, no te apetece escribir © tal cual y acabas buscando notaciones como © o ©.
No es que el carácter esté roto: es que se ha escrito en una forma que las máquinas leen bien, no las personas. La letra coreana «안» en pantalla es «안», pero dentro del ordenador es un carácter con el número U+C548, y 안 no es más que ese número escrito con la sintaxis de JavaScript.
El problema es que esa notación no es una sola. \uXXXX, \u{...}, U+, &#número;, &#xnúmero; y &nombre; apuntan todos al mismo carácter y solo se ven distintos. Por eso uno se queda atascado en el «¿qué significa esto y cómo lo revierto?».
Cómo convertir a mano, sin herramientas
Todo empieza por obtener el punto de código del carácter. Si ejecutas "©".codePointAt(0) en la consola de desarrollador del navegador, obtienes 169. Para ver ese decimal en hexadecimal, ejecuta (169).toString(16) y obtendrás "a9".
Con esos dos números (169 en decimal, a9 en hexadecimal) ya puedes escribir las seis notaciones a mano.
\uXXXX(JS): completa el hexadecimal hasta cuatro dígitos y colócalo detrás de\u→©\u{...}(ES6): pon el hexadecimal tal cual entre llaves →\u{a9}U+punto de código: escribe el hexadecimal en cuatro dígitos y en mayúsculas →U+00A9&#DDD;(HTML decimal): pon el número decimal tal cual →©&#xHH;(HTML hexadecimal): pon el número hexadecimal →©&name;(entidad con nombre): si el carácter tiene un nombre definido, ese nombre →©
Si aplicas el mismo método a ©, ★ y 👍, obtienes la tabla de abajo. Conociendo el punto de código, lo demás es puro trabajo mecánico de seguir las reglas de cada notación.
| Formato | © (U+00A9) | ★ (U+2605) | 👍 (U+1F44D) |
|---|---|---|---|
\uXXXX (JS) | © | ★ | 👍 |
\u{...} (ES6) | \u{a9} | \u{2605} | \u{1f44d} |
U+punto de código | U+00A9 | U+2605 | U+1F44D |
&#DDD; (decimal) | © | ★ | 👍 |
&#xHH; (hexadecimal) | © | ★ | 👍 |
&nombre; (nombre) | © | ★ | 👍 |
El camino inverso, de código a carácter, también funciona solo con esos números. De © sacas a9, lo lees como hexadecimal y da 169; si ejecutas String.fromCodePoint(169), vuelve a salir ©. © también es el decimal 169, así que el resultado es el mismo.
Ese es todo el proceso sin herramientas. El inconveniente es que, cuando hay varios caracteres o se mezclan formatos, meterlos uno por uno en la consola y volver a montarlos se hace pesado. Este conversor se encarga justo de esa tarea repetitiva.
Compruébalo con nuestro Conversor de escape Unicode.
Es un conversor gratuito que funciona directamente en el navegador, sin instalación ni registro. Admite las dos direcciones: de texto a código y de código a texto.
Los puntos que más confunden
Cuando un emoji se parte en dos
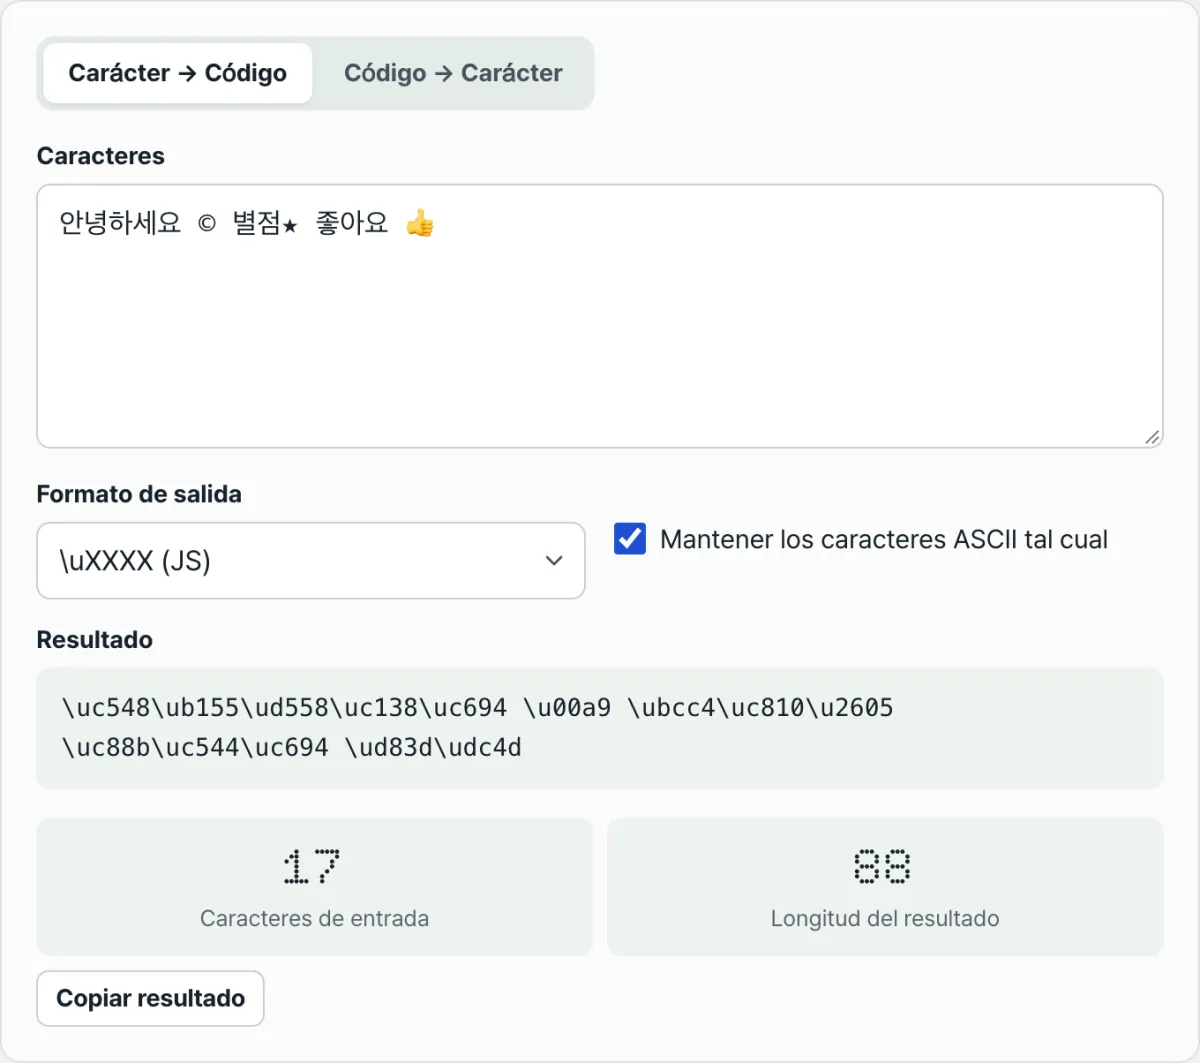
Si pasas 👍 a \uXXXX, aparece dividido en dos trozos, como 👍. No es un error: \uXXXX solo admite cuatro dígitos hexadecimales (U+FFFF), así que para los caracteres mayores se estableció que se representen emparejando dos unidades. Ese par se llama par sustituto.
Por eso el mismo emoji sale en un solo bloque en los formatos \u{1f44d}, U+1F44D y 👍: esos formatos escriben el punto de código tal cual. Si lo pegas en la pestaña «Restaurar», vuelve a ser un único 👍 sin importar el formato.
Caracteres que no cambian y entidades con nombre que no existen
Que las letras, los números y los signos básicos se queden igual también es normal. La opción «Dejar los caracteres ASCII tal cual» viene activada por defecto, así que los caracteres cuyo punto de código está entre 0x20 y 0x7E (del espacio a la tilde) no se tocan y solo se convierten los caracteres especiales. Si desmarcas esa casilla, también A se escapa como A.
También ayuda saber que las mayúsculas y minúsculas del hexadecimal cambian según el formato. Solo el formato U+ usa mayúsculas (U+00A9); \u, \u{...} y &#x salen en minúsculas (©, ©). El valor al que apuntan es el mismo, así que no hay que liarse pensando que por la diferencia de mayúsculas son caracteres distintos.
Tampoco todos los caracteres especiales tienen un &nombre;. Solo hay unos 30 nombres integrados, así que © sale como ©, pero un carácter sin nombre como ★ se sustituye automáticamente por una entidad numérica como ★. Por esa misma razón no coinciden los números de «Caracteres de entrada» y «Longitud del resultado» en pantalla: 👍 es un solo carácter en la entrada, pero en el resultado \uXXXX ocupa doce.
En resumen
Lo esencial es esto:
- Los seis formatos escriben el mismo punto de código de distinta manera. Significan lo mismo y solo cambia la envoltura.
- Todo parte del punto de código. Obtén el entero con
"carácter".codePointAt(0)y luego escríbelo según las reglas de cada formato. \usolo admite cuatro dígitos (U+FFFF), así que los emojis mayores se dividen en las dos mitades de un par sustituto. Los demás formatos escriben el punto de código tal cual.- «Dejar los caracteres ASCII tal cual» viene activado por defecto, así que las letras, los números y los signos básicos se quedan como están y solo se convierten los caracteres especiales.
- Solo hay unas 30 entidades con nombre: si un carácter no tiene nombre, el conversor lo muestra automáticamente como entidad numérica.
Es un conversor gratuito que funciona directamente en el navegador, sin instalación ni registro. Admite las dos direcciones: de texto a código y de código a texto.
Preguntas frecuentes
Convertí un emoji al formato \u y salió partido en dos. ¿Es un error?
No. \uXXXX solo puede representar cuatro dígitos hexadecimales (U+FFFF), así que los caracteres mayores se escriben como un par sustituto, es decir, dos \u emparejados (👍). Los formatos \u{1f44d}, U+1F44D y 👍 salen en un solo bloque, y si los pegas en la pestaña «Restaurar» vuelven a ser un único 👍 sea cual sea el formato.
¿Por qué no cambian las letras ni los números?
Porque la opción «Dejar los caracteres ASCII tal cual» viene activada por defecto. Los caracteres con punto de código entre 0x20 y 0x7E (espacio, letras, números y signos básicos) se dejan intactos y solo se convierten los especiales. Si desactivas la opción, también A se escapa como A.
¿Se puede restaurar de una vez un código que mezcla varios formatos?
Sí. La pestaña «Restaurar» reconoce por separado \u{...}, \uXXXX, \xXX, U+XXXX, &#xHH;, &#DDD; y las entidades con nombre. Por ejemplo, si pegas 안녕 © U+1F44D, se restaura de una vez como 안녕 © 👍.
¿Todos los caracteres especiales tienen una entidad &nombre;?
No. Solo hay unos 30 nombres integrados. © sale como © y € como €, pero un carácter sin nombre asignado, como ★, se sustituye por una entidad numérica como ★. Por eso, cuando un carácter no tiene nombre, el conversor lo muestra automáticamente como entidad numérica.
Este artículo está adaptado de nuestro original en coreano. Leer el original en coreano