
Excel CSV con caracteres corruptos: por qué pasa y cómo abrirlo
Contenido
Este artículo es para quienes abrieron un archivo CSV en Excel y se encontraron con que todo el coreano se había convertido en caracteres latinos extraños como 수출. Para ir directo al grano: el archivo no está dañado; Excel simplemente no lo leyó como UTF-8.
Un CSV no tiene dónde escribir «soy UTF-8». Por eso se pone al principio del archivo una señal de 3 bytes de BOM, y Excel lo lee como UTF-8 cuando esos 3 bytes están ahí.
Resumen ① Los caracteres corruptos son el resultado de leer bytes UTF-8 con otra tabla de caracteres. Los bytes siguen intactos, así que se puede revertir. ② El BOM de UTF-8 son los tres bytes
EF BB BFal inicio del archivo, y los programas que lo leen correctamente no lo muestran en pantalla. ③ Sin modificar el archivo, puedes abrirlo en Excel indicando tú mismo la codificación desde Obtener datos → Desde texto/CSV en la pestaña Datos, en lugar de hacer doble clic.
Por qué aparecen justamente caracteres como 수출
Si guardas en UTF-8 la palabra coreana que significa «exportación», obtienes seis bytes: EC 88 98 EC B6 9C. Es porque cada carácter hangul suele ocupar 3 bytes.
Cuando Excel no reconoce ese archivo como UTF-8, toma esos seis bytes y los lee un byte por carácter en una tabla de caracteres antigua que funciona así. En la tabla de Europa occidental (Windows-1252), EC es ì, 88 es ˆ y 98 es ˜.
Por eso los seis bytes se muestran como seis caracteres: 수출. Las letras no han desaparecido; solo se leyeron los mismos bytes con otra tabla, así que si abres el mismo archivo en un editor que lo lea como UTF-8 verás el coreano intacto.
El aspecto de la corrupción depende de con qué tabla se haya leído. Si se lee con la página de código coreana (CP949), los bytes se agrupan de dos en dos, y el nombre de la columna «número de pedido» puede aparecer como 二쇰Ц踰덊샇, una mezcla de hanja y hangul sin ningún sentido.
Un CSV no tiene dónde indicar su codificación
El RFC 4180, que describe el formato CSV, no definió ninguna forma de indicar el conjunto de caracteres dentro del archivo. Solo dice que «normalmente se usa US-ASCII, pero se pueden usar otros conjuntos de caracteres junto con el parámetro charset».
Ese charset es un valor de las cabeceras de transferencia que se añaden cuando el archivo va de un sitio a otro. Es decir, la información de codificación está fuera del archivo.
En el momento en que descargas y guardas el archivo, esa cabecera desaparece. Solo queda un montón de bytes, así que el programa que lo abre no tiene más remedio que adivinar.
Qué hacen los 3 bytes de BOM
BOM son las siglas de Byte Order Mark, y es el carácter Unicode U+FEFF colocado al principio del archivo. Al codificar ese carácter en UTF-8 se obtienen los tres bytes EF BB BF.
Originalmente servía para indicar, en codificaciones con dos órdenes de bytes posibles como UTF-16, cuál de los dos se está usando. UTF-8 solo tiene un orden de bytes, así que no hay nada que aclarar: aquí cumple únicamente la función de firma que dice «este archivo es UTF-8».
Estos 3 bytes no forman parte del contenido. El procedimiento de decodificación UTF-8 del estándar web (WHATWG Encoding Standard) establece que, si los tres primeros bytes son EF BB BF, se descartan y el resto se procesa como contenido.
La documentación de soporte de Excel de Microsoft dice lo mismo. Un archivo CSV codificado en UTF-8 se abre con normalidad si se guardó con BOM, y si no es así, recomienda usar la opción de importar de la pestaña Datos.
Cómo arreglarlo sin herramientas
Hay tres opciones. Elige según puedas o no tocar el archivo.
1. Importar desde Excel en lugar de hacer doble clic
Es el método que no toca el archivo en absoluto. En la pestaña Datos de Excel, elige Obtener datos → Desde archivo → Desde texto/CSV y selecciona el archivo.
Se abre una ventana de vista previa y, arriba del todo, hay una lista llamada Origen del archivo. Si eliges 65001: Unicode (UTF-8), el coreano de la vista previa se corrige al instante.
La desventaja es que, si hay varios destinatarios, cada uno tiene que repetir el proceso.
2. Volver a guardar con BOM desde el Bloc de notas
Abre el archivo con el Bloc de notas de Windows, ve a Archivo → Guardar como y, en la parte inferior de la ventana, encontrarás la lista Codificación. Elige UTF-8 con BOM.
Esta es justamente la razón de que en la lista aparezcan UTF-8 y UTF-8 con BOM por separado. Hoy en día el valor predeterminado del Bloc de notas es el que no lleva BOM, así que si guardas tal cual, el problema sigue igual.
3. Elegir el formato desde el momento de exportar en Excel
A la inversa, cuando pases a CSV una tabla creada en Excel, elige el tipo de archivo CSV UTF-8 (delimitado por comas) en Guardar como. Ese formato guarda con BOM.
El problema es cuando ya tienes varios archivos descargados. El Bloc de notas se vuelve lento con archivos grandes, la importación hay que repetirla cada vez que abres uno y la elección de formato no se aplica a archivos ya creados.
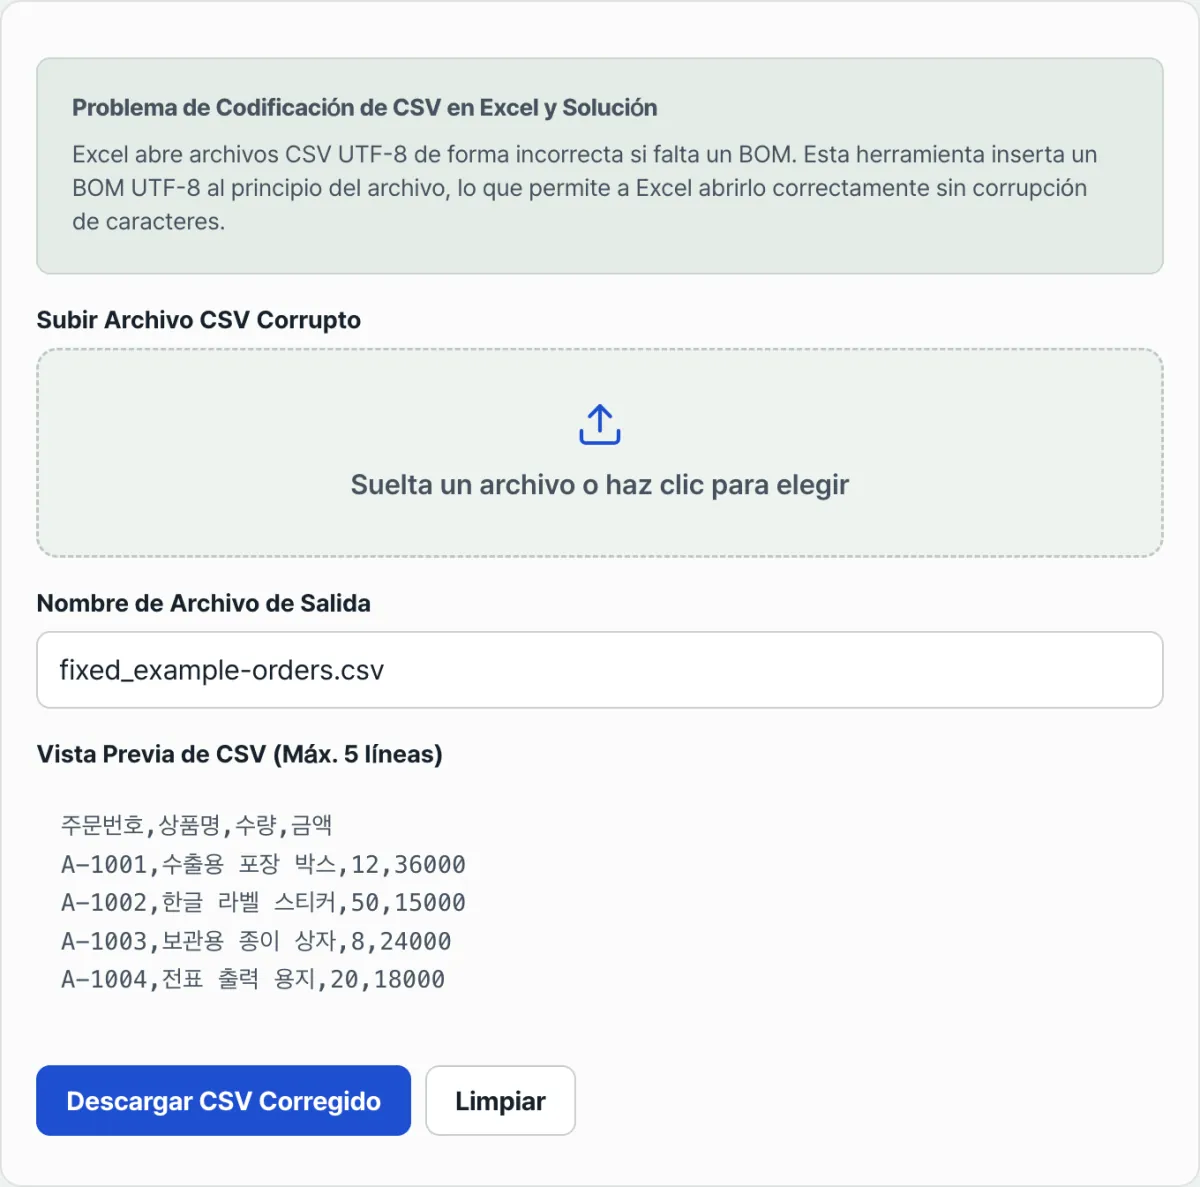
Compruébalo con nuestra herramienta. Cuando subes el archivo, primero te muestra una vista previa de las 5 primeras líneas para que veas si el coreano se lee bien, y con un solo botón descargas un nuevo CSV con el BOM añadido al principio.
Sin instalación ni registro: añade el BOM en el navegador y descarga el archivo; los archivos que subes no se envían a ningún servidor.
Dónde suele atascarse la gente
Si después de añadir el BOM el archivo sigue viéndose mal, lo más probable es que no fuera UTF-8 desde el principio. El BOM es solo una marca que avisa de que es UTF-8; no convierte otra codificación en UTF-8.
Por eso la herramienta muestra primero la vista previa de las 5 primeras líneas. Esa vista previa se genera leyendo el archivo como UTF-8, así que sirve de criterio.
| Lo que ves en la vista previa | Qué significa |
|---|---|
| El coreano se ve normal | El archivo es UTF-8. Basta con añadir el BOM para abrirlo en Excel |
Un rombo con un signo de interrogación como � | El archivo no es UTF-8 (por ejemplo, CP949). No lo descargues |
| Coreano mezclado con hanja y símbolos | Es el mismo caso. Hay que volver a exportar el original en UTF-8 |
Si la vista previa se ve mal y aun así descargas el archivo, los caracteres que no se pudieron leer quedan fijados como caracteres de reemplazo y ya no hay forma de recuperar los originales. En ese caso, la única solución es que quien creó el archivo lo vuelva a exportar en UTF-8.
También existen efectos secundarios del BOM. Es el caso en que, al leer el CSV desde un programa, el nombre de la primera columna aparece como \ufeffnúmero de pedido: eso significa que quien lo lee no ha eliminado el BOM.
En resumen
- Los caracteres corruptos son el resultado de leer bytes UTF-8 con una tabla de caracteres antigua de un byte por carácter. Es lo que pasa cuando
EC 88 98 EC B6 9C, los bytes de la palabra coreana «exportación», se ven como수출. - Un CSV no indica su codificación dentro del archivo. El RFC 4180 trata
charsetsolo como información de la fase de transferencia. - El BOM de UTF-8 son los tres bytes
EF BB BFal principio del archivo, el valor que resulta de codificar el carácter Unicode U+FEFF. - Si no quieres tocar el archivo, en Excel ve a la pestaña Datos → Desde texto/CSV → y especifica
65001: Unicode (UTF-8)en Origen del archivo. - Si prefieres corregir el archivo, guarda con
UTF-8 con BOMen el Bloc de notas, usa el formatoCSV UTF-8 (delimitado por comas)de Excel o recurre a nuestra herramienta gratuita, Reparador de Caracteres CSV para Excel. - Si añadir el BOM no soluciona nada, es que el original no era UTF-8. Compruébalo antes en la vista previa.
Sin instalación ni registro: añade el BOM en el navegador y descarga el archivo; los archivos que subes no se envían a ningún servidor.
Preguntas frecuentes
¿El BOM cambia el contenido del archivo?
Los caracteres del cuerpo quedan igual y solo se añaden tres bytes, EF BB BF, al principio. El tamaño del archivo aumenta en 3 bytes.
Los programas que siguen el estándar leen esos tres bytes y los descartan, y después procesan el resto como cuerpo, así que lo que ves en pantalla no cambia. Si vuelves a subir un archivo que ya tiene BOM, no se añade dos veces: el procedimiento de decodificación UTF-8 que usa el navegador al leer el archivo retira primero esos tres bytes iniciales.
En el Bloc de notas se ve bien, pero en Excel se corrompe. ¿Por qué?
Porque los dos programas deciden la codificación de forma distinta. El Bloc de notas intenta UTF-8 primero, mientras que Excel no considera UTF-8 al abrir un CSV directamente si no hay BOM. Es el mismo archivo, pero el resultado es diferente no por el archivo, sino por el criterio de quien lo lee.
Le puse el BOM y sigue corrompiéndose.
Eso pasa cuando el original no está en UTF-8. El BOM solo es una marca que dice "este archivo es UTF-8"; no convierte los bytes de otra codificación. Si los caracteres ya se ven corruptos en la vista previa de 5 líneas de la herramienta, estás ante ese caso, así que tienes que volver a exportar el archivo en UTF-8 desde el sistema que lo generó.
¿El archivo CSV que subo se envía a un servidor?
No. La lectura del archivo, la vista previa y la creación del nuevo archivo con BOM se procesan por completo dentro del navegador, y el archivo no se sube a ningún servidor. Un CSV con el historial de pedidos interno o la lista de clientes de tu empresa tampoco sale al exterior.
Este artículo está adaptado de nuestro original en coreano. Leer el original en coreano