
Por qué no puedes copiar el texto de una foto y cómo comprobarlo
Contenido
Por más que arrastres el ratón para copiar el texto de una foto o una captura de pantalla, no se selecciona nada. La razón es que un archivo de imagen no es más que un conjunto de píxeles (valores de color) y no contiene datos de texto. El OCR (reconocimiento óptico de caracteres) es la tecnología que analiza la forma de esos píxeles y los convierte de nuevo en caracteres reales, y su resultado varía mucho según la calidad de la foto.
Resumen ① Las fotos y las capturas de pantalla guardan píxeles, no letras, así que no se pueden seleccionar arrastrando. ② El OCR compara la forma de cada carácter con patrones de letras ya aprendidos y estima cuál es el más parecido. ③ La tasa de acierto depende mucho de la nitidez, el contraste, la inclinación y de si la letra es impresa o no; con la letra manuscrita la precisión baja de forma evidente.
Por qué no se puede seleccionar el texto de una foto
Una foto de la pizarra de una reunión, la imagen escaneada de un documento en papel y una captura de pantalla de una conversación de mensajería (KakaoTalk, WhatsApp o similar) tienen la misma estructura. Dentro del archivo solo hay valores de color para cada coordenada horizontal y vertical; no existe la información de «qué letra hay en tal sitio».
Para el navegador, una etiqueta <img> es una única imagen completa. Si se trata de un archivo de texto, el navegador reconoce cada carácter y pinta en azul la zona que arrastras; en una imagen, en cambio, no hay ningún «carácter» que pintar desde el principio.
Así puedes comprobarlo: empezando por el método más fiable
El método más fiable es mirar la foto y escribir el texto a mano. Es lo más exacto, pero transcribir una sola página lleva varios minutos y, cuando el volumen crece, aparecen erratas con facilidad.
El OCR es la tecnología que automatiza ese proceso. Divide la imagen en fragmentos muy pequeños, compara la forma del trazo de cada fragmento con patrones de caracteres aprendidos de antemano y estima cuál es el más parecido.
Como su propio nombre indica, no «conoce» la respuesta correcta: elige de forma probabilística el carácter más cercano. Por eso, cuando las condiciones son malas, también puede leer una letra por otra.
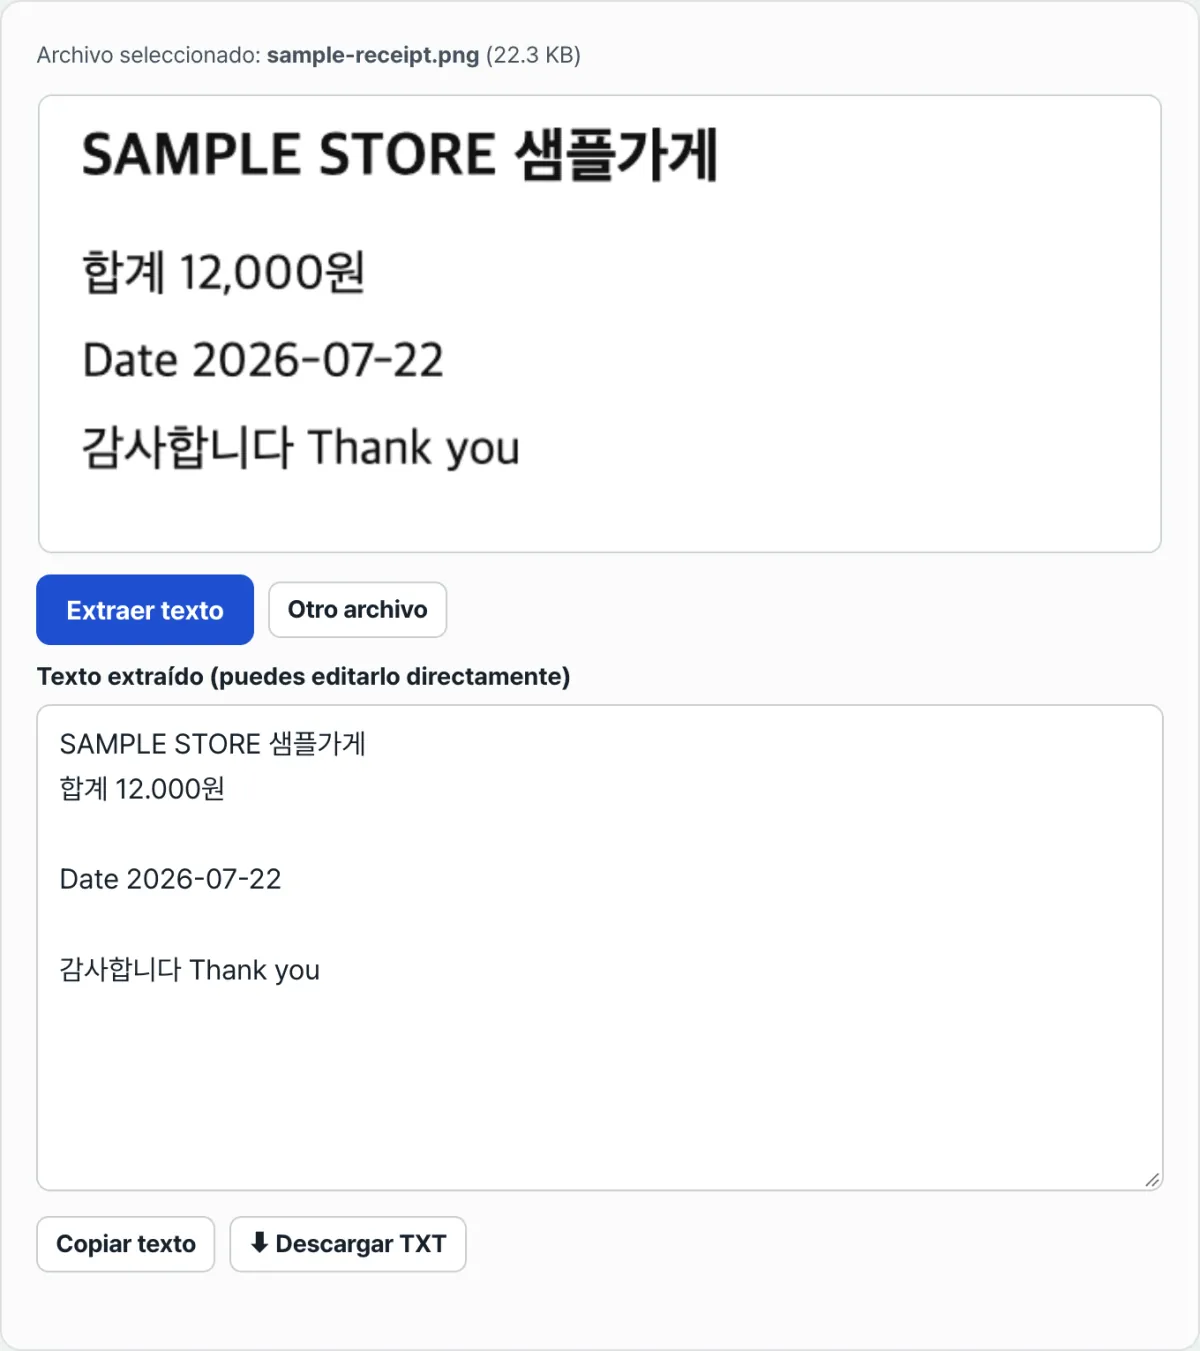
Compruébalo con nuestra herramienta. En lugar de transcribir frase por frase, puedes cargar la foto y nuestra herramienta gratuita Extraer texto de imágenes (OCR) reconoce al momento los caracteres en coreano e inglés directamente en el navegador y los convierte en texto editable. La imagen no se envía a ningún servidor: se procesa solo dentro de tu navegador.
Gratis · sin registro · las imágenes no se envían al servidor
Los 4 factores que marcan la tasa de acierto
A diferencia de una persona, el OCR no entiende el contexto: solo ve la forma de los píxeles. Por eso, incluso con la misma herramienta, el resultado cambia mucho según el estado de la foto.
| Factor | Condiciones favorables para el reconocimiento | Condiciones desfavorables para el reconocimiento |
|---|---|---|
| Resolución | El trazo de las letras se ve nítido y bien definido | Baja resolución o movimiento que emborrona el trazo |
| Contraste | Contraste marcado, como letras negras sobre fondo blanco | Contraste débil por fondos con motivos o colores claros |
| Inclinación | Las líneas de texto están horizontales respecto a la pantalla | La foto se toma en ángulo y aparece distorsión por perspectiva |
| Forma de la letra | Letra impresa (una tipografía fija) | Letra manuscrita, caligráfica o tipografías decorativas |
La letra impresa siempre presenta la misma forma para el mismo carácter, así que encaja bien con los patrones aprendidos. La letra manuscrita, en cambio, varía de una persona a otra en grosor del trazo, inclinación y forma de unir las letras, por lo que la precisión del emparejamiento de patrones baja mucho.
En resumen
Que el texto de una foto no se pueda seleccionar no es un fallo de la herramienta, sino consecuencia de cómo está hecho un archivo de imagen. Si necesitas la frase exacta, lo más seguro es escribirla a mano, pero cuando hay mucho volumen resulta más rápido sacar un borrador con OCR y revisarlo después. Para mejorar la tasa de acierto, lo más importante es usar fotos de texto impreso, nítidas, con buen contraste y tomadas en horizontal.
Gratis · sin registro · las imágenes no se envían al servidor
Preguntas frecuentes
¿También se reconocen las notas escritas a mano?
El sistema está optimizado para la letra impresa, así que es con ella con la que funciona mejor. En la letra manuscrita la forma del trazo cambia de una persona a otra y la precisión puede bajar mucho, de modo que, si la nota es corta, quizá te resulte más rápido copiarla tú.
¿Cómo tengo que hacer la foto para que la tasa de acierto sea mayor?
Enfoca bien para que no salga movida y evita que los reflejos o las sombras tapen las letras. Si fotografías el documento de frente y en horizontal, reduciendo la inclinación, la tasa de acierto sube de forma notable.
¿Se envía la imagen a un servidor?
No. El reconocimiento del texto se hace solo dentro del navegador (en tu propio dispositivo) y la imagen no se envía al exterior. Eso sí, la primera vez que lo ejecutas tiene que descargar los datos de idioma para el reconocimiento del coreano y el inglés, así que puede tardar algo más.
¿Se reconocen las fotos con coreano e inglés mezclados?
Sí. Está configurado para reconocer coreano e inglés a la vez, así que no hace falta hacer fotos separadas aunque los dos idiomas aparezcan en el mismo documento.
Este artículo está adaptado de nuestro original en coreano. Leer el original en coreano