
CSV重複削除の基準 行全体と特定の列で結果は変わる
目次
顧客名簿が入ったCSVファイルから重複行を削除するとき、多くの人が見落としがちな問いが1つあります。それは「何が同じなら重複とみなすか」です。氏名・メールアドレス・都市がすべて同じ場合だけを重複とみなすのか、メールアドレスだけが同じでも重複とみなすのかによって、削除される行数はまったく変わります。
この基準を決めないまま「重複削除」を実行すると、2つの事故につながることがあります。別人のデータが1行にまとめられて削除されたり、逆に同じ人のデータが二重に残ったまま先へ進んでしまったりします。
要点 ① 行全体が完全に同じ場合だけを重複とみなすのか、特定の列(メールアドレスなど)1つだけが同じでも重複とみなすのかは別の基準であり、結果の行数が変わります。 ② 基準を行全体に絞ると、誤字や大文字・小文字の違いによって、同じ人のデータが重複として処理されずにそのまま残ることがあります。 ③ 基準を特定の列1つに広げると、その列の値を偶然共有している別人のデータが1行にまとめられて削除されることがあります。
「重複」という言葉が隠しているもの
「重複行を削除してください」という言葉は簡単に見えますが、実際には「何が同じなら同じデータとみなすのか」という判断をすでに前提としています。この判断基準が違えば、同じファイルでもまったく異なる結果になります。
| 名前 | メールアドレス | 都市 |
|---|---|---|
| ホン・ギルドン | hong@example.com | ソウル |
| ホン・ギルドン | HONG@example.com | ソウル |
この2行は、人の目には明らかに同じ人の情報です。しかし文字列をそのまま比較すると、大文字のHONGと小文字のhongは別の文字列なので、「行全体が完全に同じ場合だけ重複」という基準では、この2行は別のデータと判定されます。
基準が狭すぎると: 本当の重複を見逃す
行全体を基準にすれば最も厳密に除外できそうに思えますが、実際には正反対の問題が起きます。1つの列でも値が違えば重複として認識されないため、同じ人の情報でも1文字でも違えばそのまま残ってしまいます。
1つのセルに余分な空白が入っている、都市名を「ソウル」と「ソウル特別市」のように書き分けている、メールアドレスの大文字・小文字が混在している、といったケースがすべてこれに当たります。こうしたわずかな違いは、人が数千行を目で追うだけでは、なかなか見つけられません。
基準が広すぎると: 別人を削除してしまう
| 名前 | メールアドレス | 都市 |
|---|---|---|
| キム・ミンス | family@example.com | ソウル |
| キム・ミンジ | family@example.com | 大田 |
今度は逆の状況です。この2行は名前も都市も異なる、明らかに別人の情報です。ところが、家族が1つのメールアドレスを共用している場合のように、メールアドレスの列だけを見るとまったく同じ値です。
この状態で「メールアドレスの列だけが同じなら重複」という基準を適用すると、どちらか一方のデータが、もう一方の重複と誤認されて削除されます。基準を狭く取る場合より広く取る場合のほうが、こうした事故は静かに起こります。画面では単に行が1つ減るだけで、何が消えたかは表示されないからです。
ツールを使わずにまず確認する方法:並べ替え + COUNTIF
Excelやスプレッドシートで手作業で確認するには、まず基準にする列(例:メールアドレス)で並べ替えます。同じ値がすぐ上下に並ぶほうが、目で比較しやすくなるからです。
並べ替えた後は、COUNTIFなどの関数でその列の値が何回現れるかを数え、2回以上出てきた値だけを絞り込むことで候補を狭められます。ただし、この作業は基準列を変えるたびに(例:メールアドレス基準から行全体基準へ)並べ替えと数式を最初から作り直す必要があり、行が数千を超えると数式が重くなってシートの動作が遅くなり始めます。
一度基準を決めれば終わりという作業ではなく、結果を見ながら基準を変えて再確認することが多いという点で、この作業は特に手間がかかります。
CSVを貼り付けるかファイルをアップロードすると、行全体または特定の列を基準に選んで、重複行をすぐに整理できます。
2つの基準をどちらも選べるようになっている理由
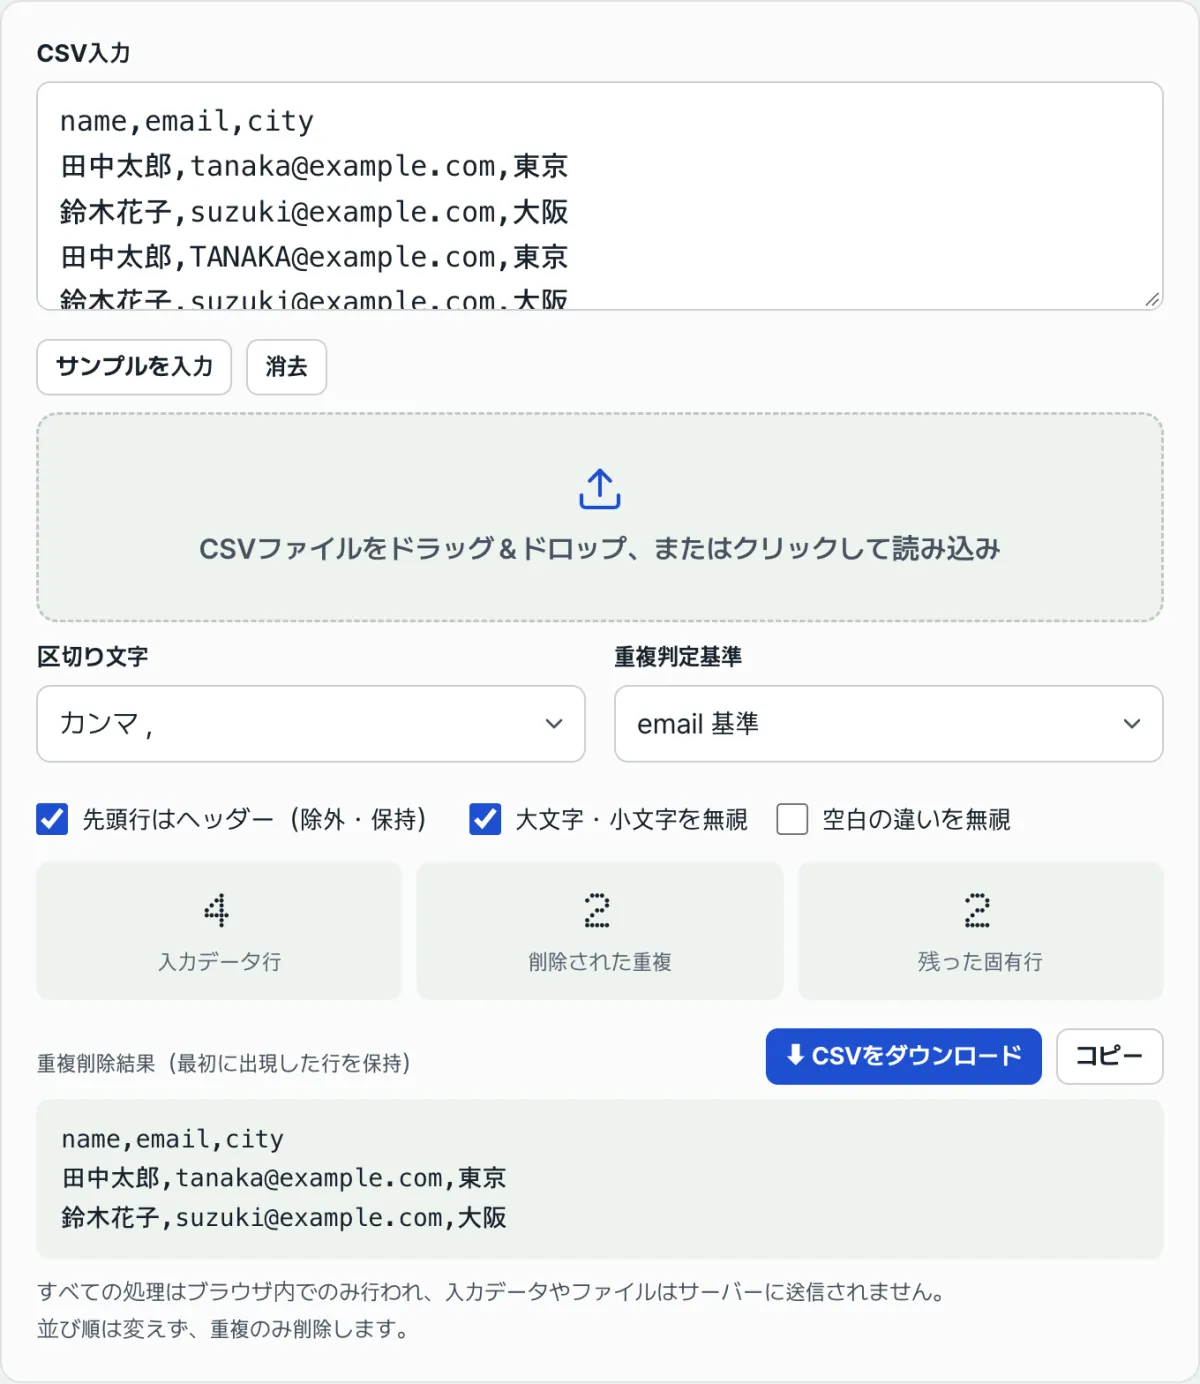
CSVの重複行を削除ツールは、重複判定の基準を「行全体」と「特定の列」から自分で選べるように作られています。どの基準にするかを自動で決めることはせず、データを貼り付けると、先頭行(ヘッダー)にある列名をそのまま選べる一覧として表示します。
基準を「行全体(すべての列が同じ)」にすると、先ほどの最初の例のように、大文字・小文字の違いがある行を見落とすことがあります。その場合は「大文字・小文字を無視」と「空白の違いを無視」のオプションを別々にオンにできるので、行全体を基準にしつつ、細かな表記の違いは同じ値として扱うよう調整できます。逆に、メールアドレスのように特定の列1つだけを基準にしたい場合は、ドロップダウンからその列を選べます。ただし、2つ目の例のように、その列の値を複数の人が共有する可能性があるなら、絞り込んだ基準がかえって事故につながることもある点は考慮してください。
基準やオプションを変えるたびに、入力データの行数・削除された重複・残ったユニーク行の数がすぐに再計算されます。そのため、実際にファイルをダウンロードする前に、どの基準を選ぶと何行削除されるかを目で見て比較できます。
最初に登場した行が残る点も確認してください
どの基準を選んでも、このツールは同じ値を持つ行のうち、ファイル内で最初に登場した行を残し、その後に出てくる行を重複として削除します。並び順自体は変更しないため、元のファイルで後から追加された情報が最新値だった場合は、その行が削除されないよう、あらかじめ順序を整えておくのが安全です。
整理された結果はCSVファイルとしてダウンロードするか、そのままコピーできます。また、カンマ以外にタブ・セミコロン・パイプで区切られたファイルも、区切り文字を変えるだけで同じように処理できます。
まとめ
- 行全体が完全に同じ場合だけを重複とみなすのか、特定の列1つだけが同じでも重複とみなすのかは別の基準であり、結果が変わります。
- 基準を行全体に絞ると、大文字・小文字や空白の違いがある本当の重複を見逃すことがあります。
- 基準を特定の列1つに広げると、その値を偶然共有している別人のデータが削除されることがあります。
- 並べ替えとCOUNTIFで手作業でも確認できますが、基準を変えて再比較するたびに最初から作り直す必要があります。
- 基準(行全体/特定の列)と、大文字・小文字・空白を無視するかどうかを自分で選べば、何行削除されるかを実行前に比較できます。
CSVを貼り付けるかファイルをアップロードすると、行全体または特定の列を基準に選んで、重複行をすぐに整理できます。
よくある質問
特定の列だけを基準にしてもいいですか?
可能です。ただし、その列の値を別の人が共有している可能性がないか、先に考える必要があります。家族が1つのメールアドレスを共用していたり、同じ部署の代表連絡先を複数の人が登録していたりして、値が重複しうる列を単独の基準にすると、実際には別の人のデータが重複として削除されることがあります。
大文字・小文字や空白の違いが原因で重複が検出されないときはどうすればいいですか?
基準列または行全体を比較するとき、文字列をそのまま比較すると「Hong」と「hong」、あるいは前後に空白がある値とない値は別の値として扱われます。こうした違いも同じ値としてまとめたい場合は、「大文字・小文字を無視」と「空白の違いを無視」のオプションを両方オンにして再確認してください。
名前とメールアドレスの2列が両方同じときだけ重複とみなしたいのですが、できますか?
このツールは、行全体を基準にする方法と、特定の列1つを基準にする方法の2通りに対応しています。2~3列だけを選んで組み合わせる基準には現在対応していないため、どうしてもそのような組み合わせが必要な場合は、元のデータで名前とメールアドレスの2列の値をあらかじめ1つの列にまとめておく、という方法で回避する必要があります。
重複を削除すると、どの行が残り、どの行が削除されますか?
同じ値を持つ行のうち、ファイル内で先に登場した行が残り、その後に出てくる行が重複として削除されます。並び順自体は変更されないため、最新の情報が後ろの行にある場合は、削除される側が最新データである可能性があります。その点を考慮して、事前に順序を整えておくのがおすすめです。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む