
HTMLをJS文字列へ変換するエスケープの仕組みと確認点
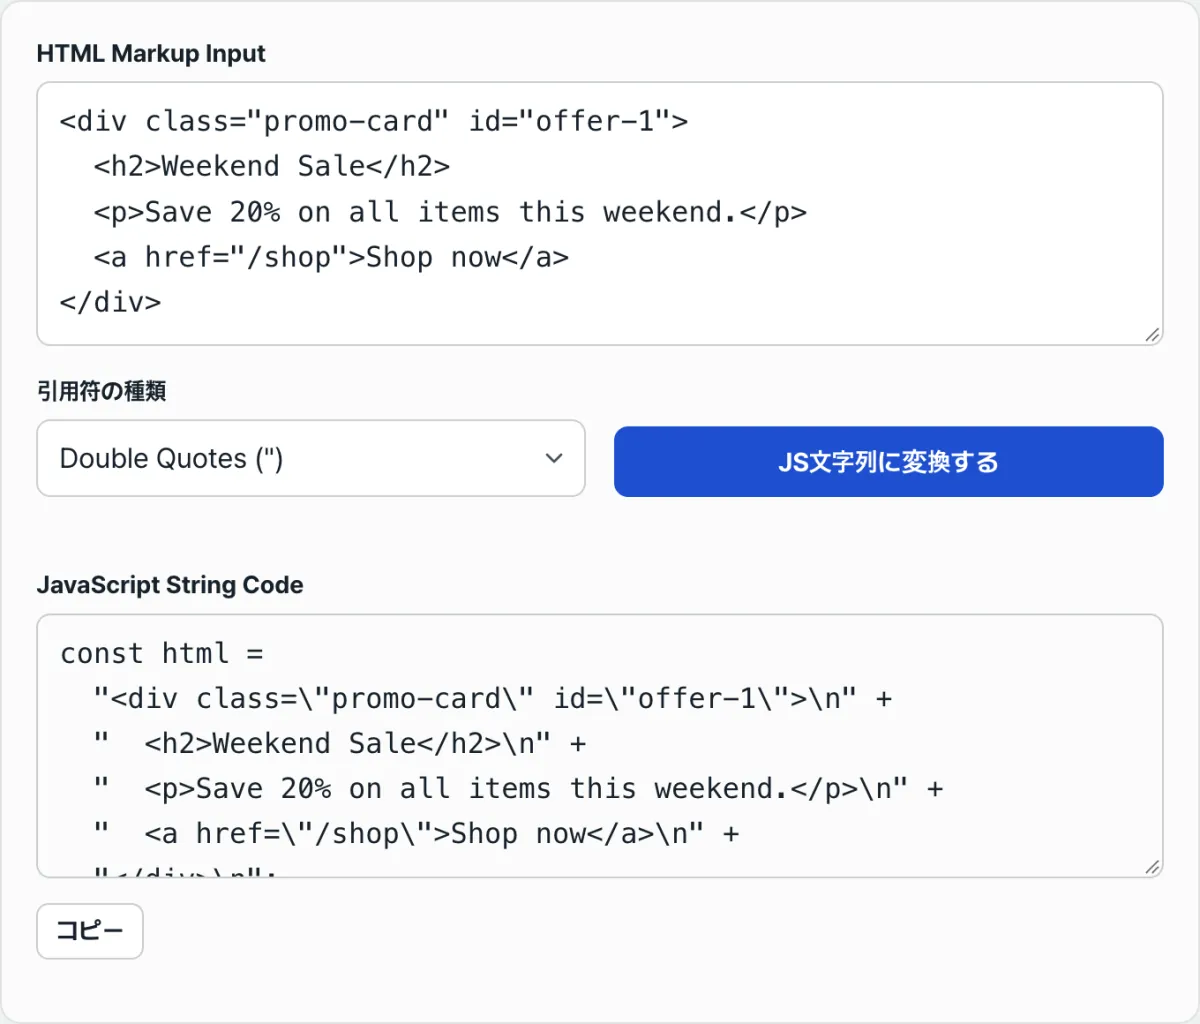
HTMLのコードブロックをJavaScriptの文字列変数に移すときは、改行を実際の改行ではなくデータとして残し、文字列を囲む記号と衝突する引用符だけを正確にエスケープすれば、構文エラーなく貼り付けられます。この処理を手作業で行うと、1行、引用符1つを見落としただけで、実行した時点で初めてエラーが表面化します。この記事では、ダブルクォート・シングルクォートモードとバッククォート(テンプレートリテラル)モードがそれぞれなぜ異なる動作をするのか、そして変換結果をコードに貼る前に何を確認すべきかを扱います。
まとめ ① ダブルクォート・シングルクォートモードは、行ごとに文字列を区切り、"\n" と + で再びつなぎ直します。通常の文字列はソースコードの中に実際の改行を含められないためです。 ② バッククォートモードは、改行をそのまま残し、バッククォート(`)と ${ だけをエスケープします。テンプレートリテラルはもともと複数行をそのまま含められる構文だからです。 ③ 変換後に構文エラーが出る場合、ほとんどは囲む記号を手作業で入れ替えてしまったか、複数行の結果の一部だけをコピーして最終行のセミコロンが抜けているかのどちらかです。
なぜこの問題が実際に起きるのか
静的ページに貼るウィジェットスクリプト、メール送信コード、ブラウザ拡張機能のコンテンツスクリプトなど、HTMLマークアップの塊をJavaScriptの文字列変数1つに丸ごと入れる必要がある場面はよくあります。デザイナーやコーダーが作ったHTMLの断片を、開発者がコードファイルの中にそのまま移し替える状況です。
このときHTMLをそのままコピーして引用符の間に入れると、タグの属性にある class="box" のような引用符が文字列を囲む引用符と衝突し、その箇所で文字列が切れてしまいます。さらにHTMLは通常複数行にわたりますが、JavaScriptの通常の文字列はソースコードの中に実際の改行が入ることを許していません。
そのため改行と引用符をそれぞれ規則に沿って処理する必要があり、その規則は文字列をどの種類の引用符で囲むかによって変わります。
ツールを使わずに自分で変換する方法
原理がわかれば手作業でもできます。まず文字列を何で囲むかを決めます。
ダブルクォート・シングルクォートモードで処理する
ダブルクォート(")またはシングルクォート(')を選んだ場合は、次の順序で処理します。
- HTMLを改行の位置ごとに区切り、複数行に分けます。
- 各行の中で、元のHTMLにバックスラッシュ(\)があれば、まず \ にエスケープします。
- その行の中で、囲む記号と同じ文字(ダブルクォートを選んだなら "、シングルクォートを選んだなら ')が出てくるたびに、その前に \ を付けます。
- 行の末尾に改行を意味する "\n" を付け、全体を引用符で囲みます。
- 最終行でなければ後ろに連結演算子 + を付けて次の行の文字列とつながるようにし、最終行にだけは + の代わりに文を終えるセミコロン ; を付けます。
こうして行を分割し、+ で再びつなぐ理由は単純です。"..." や '...' で囲んだ通常の文字列は、ソースコードの途中に実際の改行文字があると、その位置で終わっていない文字列として扱われ、エラーになります。
そこで実際の改行は文字として表現した "\n" で代用し、ソースコード上の改行は複数の文字列を + 演算子でつなぐ形で再現します。
バッククォートモードで処理する
バッククォート(`)を選んだ場合は異なります。行を分割する必要はなく、HTML全体をバッククォート2つの間にそのまま入れます。ES6で導入されたテンプレートリテラルは、そもそもソースコード内の実際の改行をそのまま含められるように作られた構文だからです。
この場合にエスケープする対象は2つだけです。元のHTMLにバッククォート()の文字があれば \ に置き換え、変数を埋め込む式の記号である ${ があれば ${ に置き換えます。
${ をそのままにすると、JavaScriptがその後ろをコードとして解釈しようとし、意図しない動作やエラーにつながります。一方、通常の引用符("、')はバッククォートモードでは特に意味を持たないただの文字なので、エスケープする必要はありません。
行数の多いHTMLをこの規則どおりに手作業で処理していると、1行でもバックスラッシュや引用符を落としやすくなります。規則自体は以上のとおりなので、減らすべきは繰り返し作業だけです。当サイトの無料ツール「HTML JS文字列変換器」で確認する。
ダブルクォート・シングルクォート・バッククォートの3つのモードで、HTMLをJS文字列の宣言文に変換します。インストールや登録は不要です。
よく混同されるポイントとミス
| モード | 改行の処理 | エスケープ対象 |
|---|---|---|
| ダブルクォート " | 行ごとに区切り、"\n" + で連結 | ダブルクォート(")、バックスラッシュ(\) |
| シングルクォート ' | 行ごとに区切り、"\n" + で連結 | シングルクォート(')、バックスラッシュ(\) |
| バッククォート ` | そのまま維持(行を分割しない) | バッククォート(`)、${ |
最もよくあるミスは、変換結果を受け取ったあとに囲む記号だけを手作業で変えてしまうことです。たとえばバッククォートモードで変換した結果に対して、あとからバッククォートだけをダブルクォートに手で入れ替えると問題が起きます。
バッククォートモードはそもそも " や ' をエスケープしていないため、HTMLの属性にあった引用符がそのまま残り、文字列を途中で切ってしまいます。ダブルクォートの結果が必要なら、ツールでダブルクォートモードを選び直して変換する必要があります。
2つ目のミスは、入力を修正したあとに変換ボタンを押し直さないことです。このツールは入力欄の内容が変わっても自動で再計算せず、「JS文字列に変換」ボタンを押したときだけ結果が更新されます。HTMLを直したあとに古い結果をそのままコピーすると、コードと実際の画面が食い違います。
3つ目は、複数行に分かれた結果の一部だけをコピーすることです。ダブルクォート・シングルクォートモードの結果はほとんどの行が + で終わり、セミコロンで終わるのは最終行だけです。結果の末尾を落としてコピーすると + で終わったまま後ろがない未完成の文になり、逆に結果の後ろに別のコードをそのままつなげると、すでにセミコロンで終わった文の後ろに無関係なトークンが付いてエラーになります。
まとめ
- 通常の文字列("、')はソースコードの中に実際の改行を含められないため、ダブルクォート・シングルクォートモードは行単位で分割し、"\n" + でつなぎます。
- バッククォートのテンプレートリテラルは複数行をそのまま含められる構文なので、行を分割する必要はなく、バッククォートと ${ だけをエスケープします。
- バッククォートモードは通常の引用符をエスケープしないので、変換後に囲む記号だけを手作業で変えてはいけません。
- 結果を貼る前には、最終行がセミコロンで終わっているか、その前の行がすべて + でつながっているかを確認する必要があります。
- 入力を修正した場合は、変換ボタンを押し直さないと最新の結果は得られません。
ダブルクォート・シングルクォート・バッククォートの3つのモードで、HTMLをJS文字列の宣言文に変換します。インストールや登録は不要です。
よくある質問
なぜバッククォートモードでは引用符をエスケープしないのですか?
バッククォート文字列の中では " と ' が区切り記号ではなく、ただの文字だからです。JavaScriptが文字列の終わりと認識する記号は、その文字列を始めたのと同じバッククォートだけなので、エスケープが必要なのはバッククォート自体と式の埋め込み記号である ${ だけです。
変換結果を貼ったのに構文エラーになります。なぜですか?
ほとんどは次の2つのどちらかです。HTMLを修正したあとに変換ボタンを押し直さず古い結果をコピーした、あるいは複数行に分かれた結果の一部だけをコピーして最終行のセミコロンが抜けた、もしくは後ろに別のコードが誤ってつながったというケースです。結果欄の全体を最初から最後までコピーし直して確認するのが一番早い方法です。
元のHTMLにバックスラッシュがあるとどうなりますか?
ダブルクォート・シングルクォートモードでは、各行のバックスラッシュもエスケープ対象なので \ と2つ並べて表記されます。パスや正規表現のパターンのようにバックスラッシュを含むテキストを扱うときは、結果でバックスラッシュが1つではなく2つになるのが正常だという点を覚えておくとよいでしょう。
バッククォートモードで変換した結果を、あとからダブルクォートの文字列に変えてもよいですか?
おすすめしません。バッククォートモードは " と ' をエスケープしないため、囲む記号だけを手作業で変えると、HTMLの属性にある引用符がそのまま残って文字列を早い段階で終わらせてしまいます。ダブルクォートの結果が必要なら、ツールでダブルクォートモードを選び直して変換するのが安全です。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む