
英語の大文字・小文字変換 4つのケース規則と使い方
英語のプレゼンテーションのスライドタイトルを書いたり、JavaScript・Pythonの変数名をコーディングしたりするとき、すでに書いてある文や単語の大文字・小文字の表記を、別のルールに変えたい場面はよくあります。
まとめ ① Sentence Caseは、句読点(. ! ?)の直後に来る文字だけを大文字にし、それ以外は小文字に正規化します。 ② Title Caseは、冠詞・前置詞などの短い単語を例外として、各単語の最初の文字を大文字にします。 ③ snake_case・kebab-caseは、camelCaseの大文字の境界を基準に単語を分割し、
_や-で再びつなぎます。
表記法ごとのルール
英語テキストの表記スタイルは、使われる場所によって次のように分かれます。
- Sentence Case(文の最初の文字だけ大文字): 文の最初の文字だけを大文字にし、残りの文字はすべて小文字に正規化します。
- 例: "hello, world! this is regex." → "Hello, world! This is regex."
- Title Case(単語ごとの頭文字を大文字): 各単語の最初の文字を大文字にしますが、冠詞・前置詞・接続詞のような短い単語は、読みやすさのために小文字のまま残すルールを適用することもあります。
- 例: "the lord of the rings" → "The Lord of the Rings"
- Snake Case(アンダースコア
_で結合): データベースのカラム名や変数名としてよく使われ、すべての文字を小文字にして、単語の境界をアンダースコア(_)でつなぎます。- 例: "camelCaseConverter" → "camel_case_converter"
- Kebab Case(ハイフン
-で結合): WebページのURLスラッグやCSSのクラス名に広く使われ、単語の間をハイフン(-)でつなぎます。- 例: "KebabCaseStyle" → "kebab-case-style"
Sentence Caseの正規表現の仕組み
複数の文が混ざった文章で各文の開始位置を見つけ、最初の文字だけを大文字に変える正規表現の置換は、次のように動作します。
- 文末記号の検出: ピリオド(
.)、疑問符(?)、感嘆符(!)の後に空白が来る位置を文の境界とみなします。 - 最初の文字を大文字にする置換:
正規表現function toSentenceCase(text, forceLowerOthers = true) { const workingText = forceLowerOthers ? text.toLowerCase() : text; return workingText.replace(/(^\s*|[.!?]\s+)([A-Za-z가-힣])/g, (match, separator, letter) => { return separator + letter.toUpperCase(); }); }/(^\s*|[.!?]\s+)([A-Za-z가-힣])/gは、文字列の先頭(^)または句読点と空白([.!?]\s+)の直後に来る文字を探し、その文字だけを大文字に変えます。残りの文字を強制的に小文字にするかどうかは、オプションでオン・オフできます。
この正規表現をテキストエディタやコンソールにそのまま移して実行することもできますが、オプションを変えながら複数の文を見比べるには毎回コードを書き換える必要があり、手間がかかります。
無料ツールで確認する。 「文章のケース整形(Sentence case・Title Case)」にテキストを貼り付け、Sentence Case・Title Case・snake_case・kebab-caseの中から1つを選ぶと、すぐに結果が表示されます。
大文字・小文字の表記を整えたい英文を入力欄に貼り付け、Sentence Caseやプログラミング用の変数名フォーマットに1秒で一括変換してみてください。
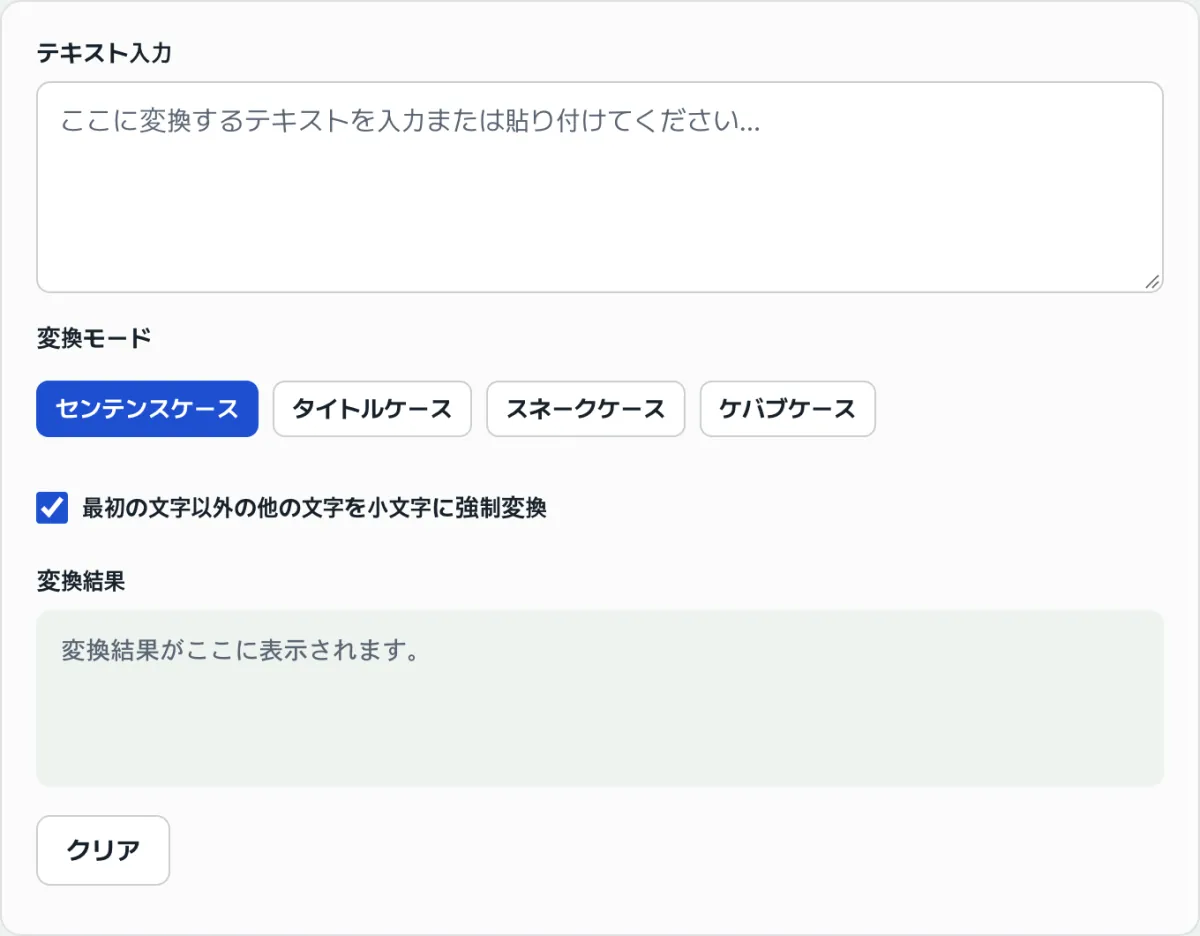
ツールの画面は、テキスト入力欄、4つの変換モードボタン(Sentence Case・Title Case・snake_case・kebab-case)、モードごとのオプションチェックボックス、結果欄の1つで構成されています。モードを切り替えると、同じ入力内容がその場で再計算され、結果はコピーボタンですぐに取得できます。
よくつまずくポイント
| 状況 | 結果 |
|---|---|
| ハングルと英語が混ざった文 | Sentence Caseは句読点の後の文字を大文字にするロジックなので、大文字・小文字の区別がないハングルはそのまま残り、英語の部分だけが変わります |
| camelCaseをsnake_case・kebab-caseに変えるとき | 小文字・数字の後に来る大文字を境界として単語を分割し、小文字にまとめます(例: "camelCaseConverter" → "camel_case_converter") |
| Title Caseですべての単語を大文字にしたいとき | 「すべての単語の頭文字を大文字にする」オプションをオンにすると、冠詞・前置詞の例外なしにすべて大文字になります |
まとめ
- Sentence Caseは句読点の後の最初の文字だけを大文字にするルールで、残りの文字を小文字に正規化するかどうかはオプションです。
- Title Caseは単語ごとの最初の文字を大文字にしますが、冠詞・前置詞のような短い単語を例外にするかどうかを選べます。
- snake_case・kebab-caseは、camelCaseの大文字の境界で単語を分割し、つなぐ記号だけを変えて結合します。
- ルールを自分でコードに置き換えて複数のテキストを比較する代わりに、変換ツールに貼り付けてモードを切り替えるだけで確認できます。
大文字・小文字の表記を整えたい英文を入力欄に貼り付け、Sentence Caseやプログラミング用の変数名フォーマットに1秒で一括変換してみてください。
よくある質問
snake_caseとkebab-caseで結果が違うのはなぜですか?
単語を分割する基準(大文字の境界、空白、特殊文字)は同じで、単語をつなぐ記号だけが異なります。snake_caseはアンダースコア(_)、kebab-caseはハイフン(-)でつなぎます。
ハングルの文もSentence Caseに変換できますか?
句読点の後の文字を大文字にするロジック自体はハングルにも適用されますが、ハングルには大文字・小文字の区別がないため、実質的な変化はありません。英語が混ざった文では、英語の部分にだけ効果があります。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む