
タイポグリセミアとは 文字を混ぜても読める理由と仕組み
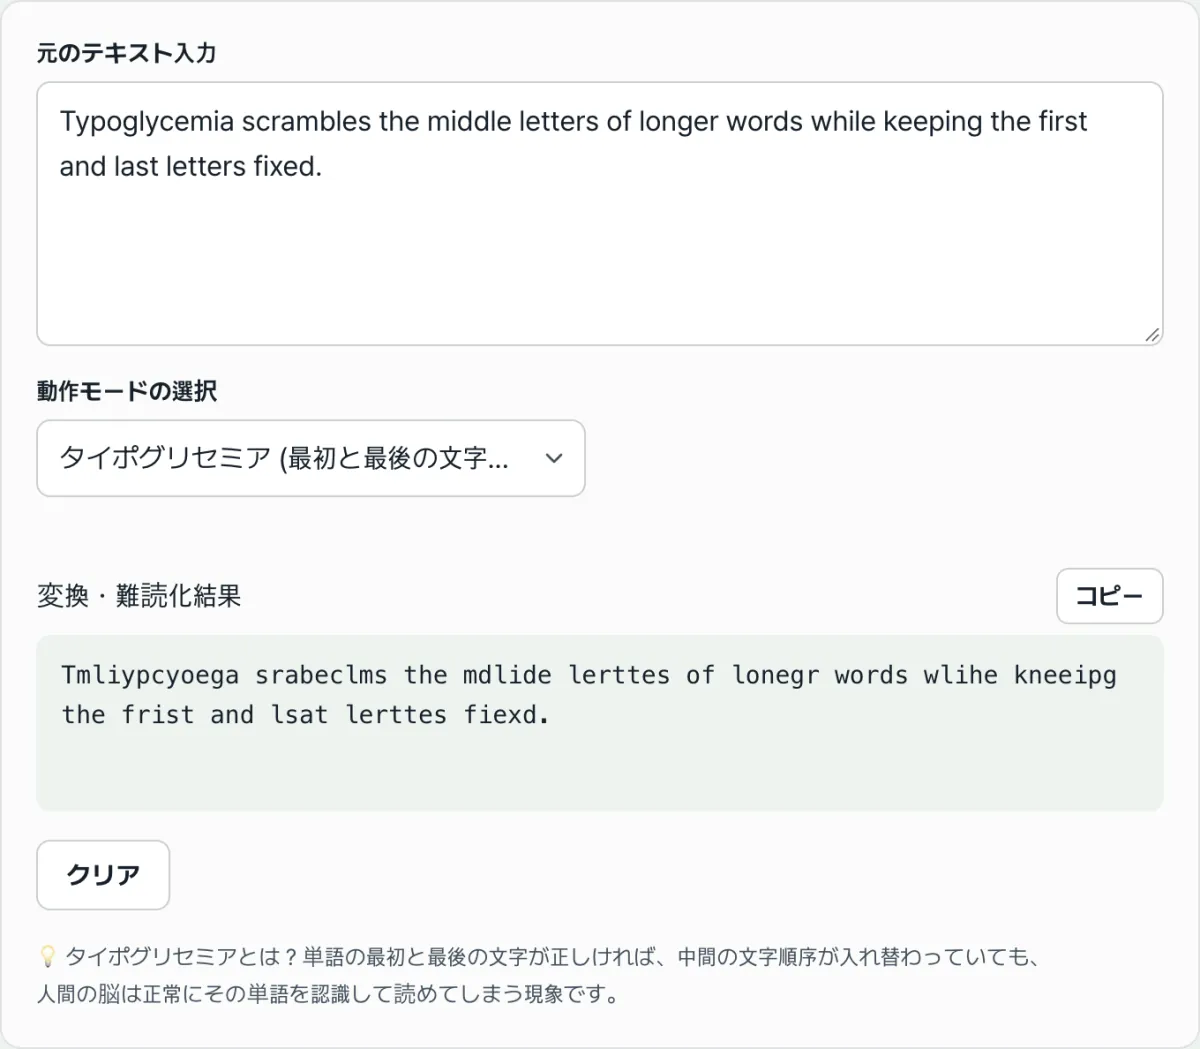
単語の中間の文字をどれだけ混ぜても、人はそのまま読めてしまう現象を「タイポグリセミア(Typoglycemia)」と呼びます。この記事は、その現象とは何なのか知りたい方、そして自分の文章を実際に混ぜてみたい方に向けたものです。
先に結論を言うと、このツールがやっているのは「暗号化」ではなく、決められたルールに沿った文字の置き換えです。4つのモードがそれぞれ何をどう変えるのかは、すべて目で確認できます。
まとめ ① タイポグリセミアモードは、単語の最初と最後の文字を固定し、中間の文字だけをランダムに入れ替えます(3文字以下の単語はそのまま、英語・ハングルともに処理)。 ② シーザー/ROT13モードは、アルファベットをスライダーの値(1〜25、既定値13)だけ後ろにずらして置き換え、数字・空白・記号には触れません。 ③ 上下反転と数学記号のモードは暗号化ではなく、形の似たUnicode文字に置き換える処理なので、環境によっては崩れて見えることがあります。
文字が混ざっているのになぜ読めるのか、まずはそこから
SNSを眺めていると、段落の文字がでたらめなのに、まったく引っかからずに読めてしまう画像に出会うことがあります。「これが読めたら天才」という文言が添えられていることもあります。
気になって自分で作ってみようとすると、2つの壁にぶつかります。1つ目は、単語ごとに手作業で文字を並べ替えるのが思った以上に面倒なこと。2つ目は、この変形が「本物の暗号」なのか、見た目を変えただけなのかが分からなくなることです。
とくに、フォーラムのネタバレ隠しに使われるROT13や、文字が四角(□)に化けて見えるUnicodeの変形に出会うと、誤解はさらに大きくなります。このツールが正確に何を変えているのかが分かれば、その混乱は整理できます。
ツールを使わずに自分で文字を混ぜる方法
4つの変形はどれも、原理さえ分かれば手作業でも再現できます。
- タイポグリセミア(中間の文字を混ぜる)。 単語を1つ選び、最初の文字と最後の文字はそのままにして、真ん中の文字だけ順番を入れ替えて書けばいいのです。3文字以下の単語(the、and、木など)は替える中間がないので、そのままにします。たとえば "letter" なら l と r を固定し、中間の e・t・t・e を並べ替えて "ltteer" のような形で書きます。
- シーザー/ROT13(アルファベットをずらす)。 AからZまでの26文字を並べ、それぞれの文字を決めた数だけ後ろにずらして置き換えます。Zを超えたらAに戻ります。ずらす値が13なら、それがROT13です。13は26の半分なので、AはN、BはOになり、もう一度ずらすと元に戻ります。だから同じ操作が隠すことと解くことを兼ねます。
- 上下反転・数学記号。 この2つは文字ごとに対応表が必要です。「a」は「ɐ」、「b」は「q」のような反転した形のUnicodeに変え、順番を逆にする仕組みなので、手作業でやるには対応表をいちいち探すことになり、事実上現実的ではありません。
問題は、文章が少し長くなるだけで、この作業が急に面倒になることです。ツールなら入力した瞬間にルールどおり変換し、テキストを編集するたびにランダムなシャッフルをやり直してくれます。
当ツールで確認してみましょう。
4つのモードでテキストをすぐに変換できます。処理はすべてブラウザ内で行われ、サーバーには送信されません。
よくある誤解と、結果の読み方
もっとも多い誤解は、この変形を「セキュリティのための暗号」と見なすことです。シーザー暗号はずらす値が1〜25しかないので、25通りをすべて試せば解けますし、ROT13はそもそも同じ操作で元に戻るため、秘密を守る目的のものではありません。ネタバレを軽く隠す用途です。
上下反転と数学記号も暗号化ではありません。形の似たUnicode文字に変えた置き換えにすぎないので、ルールさえ分かれば読み戻せますし、数学記号はUnicode正規化で元の文字を復元できます。
| モード | 変える対象 | 元に戻す方法 | セキュリティ暗号か |
|---|---|---|---|
| タイポグリセミア | 単語の中間の文字の順序 | 元の順序が捨てられるため自動復元は不可 | いいえ(可読性の実験) |
| シーザー/ROT13 | アルファベットをN文字ずらす | 逆方向(26−N)にずらすと復元 | いいえ(場合の数は25通り) |
| 上下反転 | 順序の反転+類似Unicode | ルールが分かれば読み戻せる | いいえ(形の置き換え) |
| 数学記号 | 類似Unicodeに置き換え | Unicode正規化(NFKC)で復元 | いいえ(形の置き換え) |
2つ目に多い誤解は、結果が四角(□)や疑問符に見えるときに「文字が壊れた」と考えることです。上下反転・数学記号はあまり使われないUnicode文字を使うので、貼り付けるアプリやフォントにその文字の形(グリフ)がないと、代替の記号で表示されます。テキスト自体が損傷したのではなく、表示する側のフォントの問題であり、Unicode対応の広いアプリに入れれば正常に表示されます。
3つ目は、タイポグリセミアの結果が元の単語とまったく同じになる場合があることです。ツールはシャッフル結果が元と同じならもう一度混ぜますが、4文字の単語のように中間の文字が2つしかないと、混ぜ直しても同じ並びになることがあるためです。ハングルは字母ではなく音節ブロック単位で混ぜられる、という点も知っておくと結果が理解しやすくなります。
まとめ
ポイントは5つに絞れます。
- タイポグリセミアモードは最初と最後の文字を固定し、中間だけをランダムに入れ替えます。3文字以下はそのままにし、英語とハングルの両方を扱います。
- シーザー/ROT13モードはスライダーの値(1〜25、既定値13)だけアルファベットをずらして置き換え、数字・空白・記号はそのままにします。
- 上下反転・数学記号モードは暗号ではなく、似た見た目のUnicodeに変える置き換えです。
- 崩れて見える結果はテキストの損傷ではなく、フォントにそのグリフがないために起こる表示の問題です。
- 4つのモードはいずれも暗号化ではないので、秘密を守るためではなく、遊び・実験・軽い隠し用途として理解してください。
4つのモードでテキストをすぐに変換できます。処理はすべてブラウザ内で行われ、サーバーには送信されません。
よくある質問
タイポグリセミアは実際に読める現象なのですか?
最初と最後の文字さえ正しい位置にあれば、中間が混ざっていても文章をそれほど苦労せず読めてしまう、という読みの現象として知られています。ただし絶対的な法則ではなく、単語の長さや慣れ親しみ、中間の文字がどう並んだかによって読める度合いは変わります。このツールで自分の文章を実際に混ぜてみれば、どこまで読めるのかを目で確かめられます。
ROT13は暗号化ですか? なぜ同じ操作で元に戻るのですか?
ROT13は、各アルファベットを13文字分後ろにずらすシーザー暗号の一種です。13を2回足すと26になり、アルファベットを一周して元の位置に戻るため、同じ操作をもう一度適用すると元の文字に戻ります。シーザー暗号は場合の数が25通りしかなく、1つずつ試せば解けるので、セキュリティではなく、ネタバレを軽く隠す習慣として使われています。
結果が四角(□)や疑問符になって崩れて見えます。
上下反転と数学記号のモードは、あまり使われないUnicode文字を使います。貼り付けるアプリやフォントにその文字のグリフがないと、四角や疑問符のような代替記号で表示されます。テキストが壊れたのではなく、表示する側のフォントの問題なので、Unicode対応が広めのエディタやアプリに入れれば正常に表示されます。
ハングルも混ざりますか?
タイポグリセミアモードはハングルも処理しますが、字母(ㅎ・ㅏ など)ではなく音節ブロック単位で混ぜます。たとえば「타이포글리세미아」は、最初の音節「타」と最後の音節「아」を残し、中間の音節だけ順番が入れ替わります。シーザー・上下反転・数学記号のモードはラテンアルファベットだけを変形するので、ハングルはそのまま素通りします。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む