
TOML JSON 変換の文法対応を実例で確認
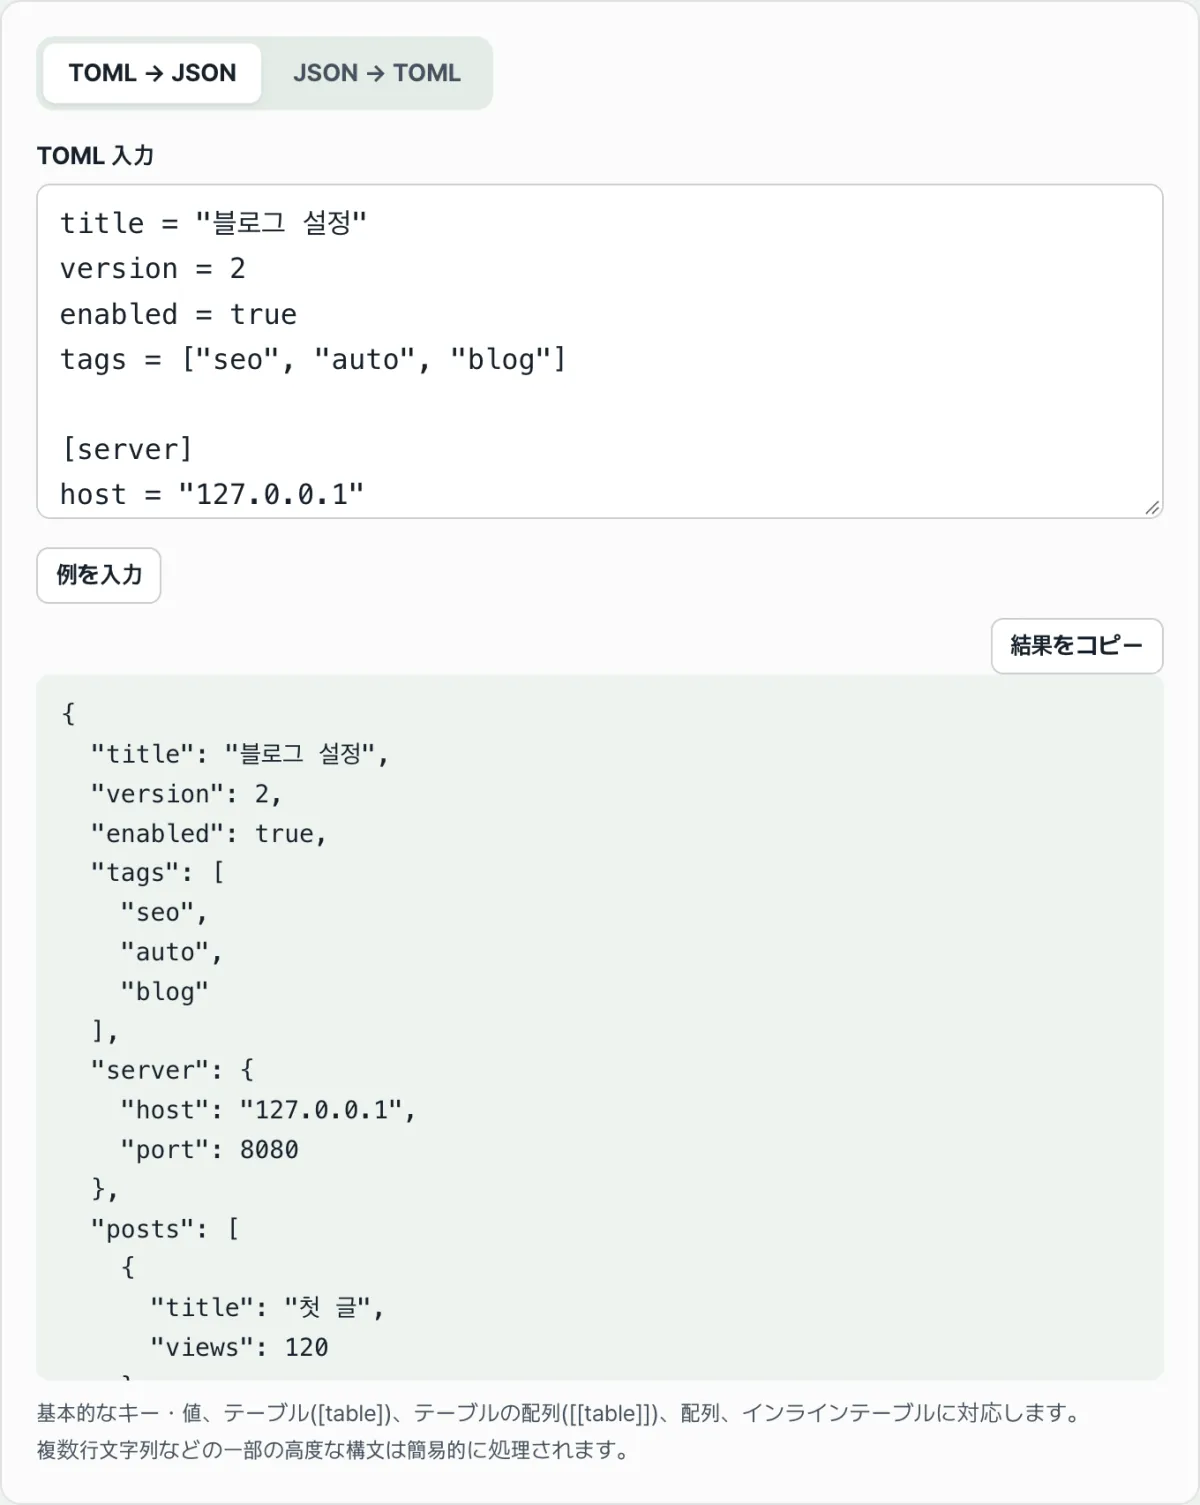
TOMLをJSONに変換するときに迷うのは、計算が難しいからではなく、どの文法がどんな形になるのかという対応表が頭の中にないからです。結論から言うと、対応はシンプルです。[table]はネストしたオブジェクト、[[table]]はオブジェクトの配列、ドット(.)でつないだキーとインラインテーブル{ }はすべてオブジェクトになります。
この記事では、設定ファイルをTOMLとJSONの間で移し替える方に向けて、各文法要素が実際にどんな結果になるのかを入出力で確認していきます。
まとめ ①
[table]はネストしたオブジェクト、[[table]]はオブジェクトの配列、ドット(.)キーとインラインテーブル{ }はすべてオブジェクトに変わります。 ② 逆にJSON → TOMLでは最上位が必ずオブジェクトである必要があり、値がnullのキーはTOMLにnullが存在しないため丸ごと消えます。 ③ 日付のように見える値は文字列として残り、1_000_000のようなアンダースコア付きの数値はアンダースコアを外した1000000になります。
設定はTOMLなのに、ツールはJSONしか受け付けないとき
TOMLは設定ファイルの形式として広く使われています。RustのCargo.toml、Pythonのpyproject.toml、各種静的サイトジェネレーターのconfig.tomlが代表例です。
問題は、その設定をJSONしか受け付けない別のツールやスクリプトに渡したいときに起こります。たとえばpyproject.tomlの設定の一部をJSONベースの検証ツールに読み込ませたり、逆にJSONで管理していた設定をTOMLを使うツールへ移したりするケースです。
このとき手作業で移すと、[tool.black]のようなネストしたテーブルがどこまでで1つのオブジェクトなのか、[[tool.poetry.source]]のような二重の角括弧が配列なのかオブジェクトなのかで迷い、構造がずれてしまいがちです。形式そのものはシンプルなのに、対応のルールを知らないとミスが起きるポイントです。
ツールを使わずに文法を1つずつ対応させる方法
まずは原理からです。TOMLはもともとハッシュテーブル(キーと値の組み合わせ、つまり辞書)に正確に対応するように設計された形式です。そのためJSONのオブジェクトと相性がよく、対応のルールもいくつかに整理できます。
ルールは5つです。
キー = 値→"キー": 値と、1組のペアがそのまま移ります。[owner]の下の行 →"owner": { ... }にまとまったネストしたオブジェクトになります。owner.name = "山田太郎"のようにドット(.)でつないだキー →[owner]を書いたのと同じく"owner": { "name": "山田太郎" }になります。[[posts]]が繰り返されると →"posts": [ {...}, {...} ]というオブジェクトの配列になります。角括弧が2重になっているのが「配列」の合図です。{ x = 1, y = 2 }のインラインテーブル →{ "x": 1, "y": 2 }のオブジェクトになります。
たとえば、次のTOMLは
title = "ブログ設定"
version = 2
tags = ["seo", "auto", "blog"]

[database]
host = "127.0.0.1"
port = 5432

[[posts]]
title = "最初の記事"
views = 120

[[posts]]
title = "2つ目の記事"
views = 45
このように変わります。
{
  "title": "ブログ設定",
  "version": 2,
  "tags": [
    "seo",
    "auto",
    "blog"
  ],
  "database": {
    "host": "127.0.0.1",
    "port": 5432
  },
  "posts": [
    {
      "title": "最初の記事",
      "views": 120
    },
    {
      "title": "2つ目の記事",
      "views": 45
    }
  ]
}[database]が"database"オブジェクトに、[[posts]]が"posts"配列にたたまれているのが一目でわかります。
手作業で移した結果が正しいかを確認したいときは、標準のパーサーを通せば済みます。Python 3.11からは標準ライブラリに読み取り専用のTOMLパーサーtomllibが入っているので、別途インストールせずに次の1行で同じ変換を確認できます。
python3 -c "import tomllib,json; print(json.dumps(tomllib.load(open('config.toml','rb')), indent=2, ensure_ascii=False))"この方法は正規のパーサーなので、文法エラーがあればエラーとして教えてくれるという利点があります。ただ、ファイルを用意してコマンドを打つ手間が毎回かかりますし、逆方向(JSON → TOML)は標準ライブラリに書き出し用のツールがないため、ライブラリを別途入れる必要があります。
無料ツール「TOML ↔ JSON 変換」で確認する。
貼り付けるだけでブラウザ上でTOML↔JSONの双方向変換。インストールも会員登録も不要で無料、入力はサーバーに送信されません。
結果を読むときに迷うポイント
対応さえわかれば、TOML → JSONの方向で迷うことはほとんどありません。誤解が生じるのは主に逆方向と、いくつかの値の扱いです。よくあるものだけ整理すると、次のとおりです。
| 状況 | 結果 |
|---|---|
| JSONの最上位が配列・数値・文字列 | 「TOMLの最上位はオブジェクトである必要があります」というエラー |
値がnullのキー | TOMLにnullがないため、そのキーは丸ごと省略される |
"2026-07-17"のような日付文字列 | 引用符付きの文字列のまま維持 |
1_000_000のアンダースコア付き数値 | アンダースコアを外した1000000の数値に |
# コメント(引用符の外) | 結果から削除される |
最上位は必ずオブジェクトでなければなりません。 JSON → TOMLの方向で[1, 2, 3]のように最上位が配列だったり、単なる数値や文字列1つだったりすると、変換ツールは「TOMLの最上位はオブジェクトである必要があります」と知らせます。TOMLはファイル全体が1つのキーと値の組み合わせなので、名前のない配列を一番外側に置けないからです。{ "items": [1, 2, 3] }のようにキーで一度包めば変換できます。
nullのキーは消えます。 TOMLにはnullという値そのものがありません。そのためJSONに"nickname": nullがあると、TOMLの結果にはnicknameの行がまったく出てきません。値が空だからではなくキーごと丸ごと抜けるので、結果を再度JSONに戻すとそのキーはなくなっています。
日付に見えても文字列です。 TOMLには本来、日付・時刻の型がありますが、この変換ツールではその部分を単純化し、2026-07-17のような値を日付型ではなく文字列として扱います。そのためJSONの結果では"2026-07-17"のように引用符が付きます。数値と誤認識されて値が壊れることはありません。
数値のアンダースコアは桁区切りです。 TOMLでは1_000_000のようにアンダースコアで桁を区切って読みやすく書けます。変換ツールはアンダースコアを外し、1000000という数値に変えます。JSONにはアンダースコア表記がないので、自然な結果です。
まとめ
[table]はネストしたオブジェクト、[[table]]はオブジェクトの配列、ドット(.)キーとインラインテーブル{ }はすべてオブジェクトに変わります。- JSON → TOMLは最上位が必ずオブジェクトである必要があり、配列や数値だけを入れるとエラーになります。
- 値が
nullのキーはTOMLにnullがないため、結果から丸ごと抜けます。 - 日付のように見える値は文字列として維持され、
1_000_000のようなアンダースコア付き数値はアンダースコアを外した数値になります。 - 手作業で移した結果は、Pythonの
tomllibのような標準パーサーで再確認できます。
貼り付けるだけでブラウザ上でTOML↔JSONの双方向変換。インストールも会員登録も不要で無料、入力はサーバーに送信されません。
よくある質問
TOMLの [[ ]] のような二重角括弧は、JSONでは何になるのですか?
同じ名前の [[posts]] ブロックが複数回登場すると、その名前のオブジェクト配列、つまり "posts": [ { ... }, { ... } ] になります。角括弧1つの [posts] はネストしたオブジェクト1つ、2つの [[posts]] は配列、という違いだけを押さえておけば大丈夫です。
JSONをTOMLに変換したらエラーが出ました。なぜですか?
JSONの最上位がオブジェクトでない場合に起こります。[1, 2, 3] のような配列や、数値・文字列が1つだけの場合は「TOMLの最上位はオブジェクトでなければなりません」というエラーになります。TOMLはファイル全体がキーと値の組なので、{ "items": [1, 2, 3] } のようにキーで1回囲んであげれば変換できます。
日付を入れたら、引用符付きの文字列として出力されました。
正常な動作です。この変換ツールは日付・時刻を単純化して文字列として扱うため、2026-07-17 が "2026-07-17" と出力されます。値が変わったり壊れたりしているわけではなく、型だけが文字列として保たれている状態です。
入力した設定がサーバーに送信されることはありますか?
いいえ。すべての変換はブラウザ内で処理され、入力したTOML・JSONがサーバーへ送信されたり保存されたりすることはありません。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む