
HTML-Entities umwandeln: Die 5 Zeichen und ihre Kodierung
Inhalt
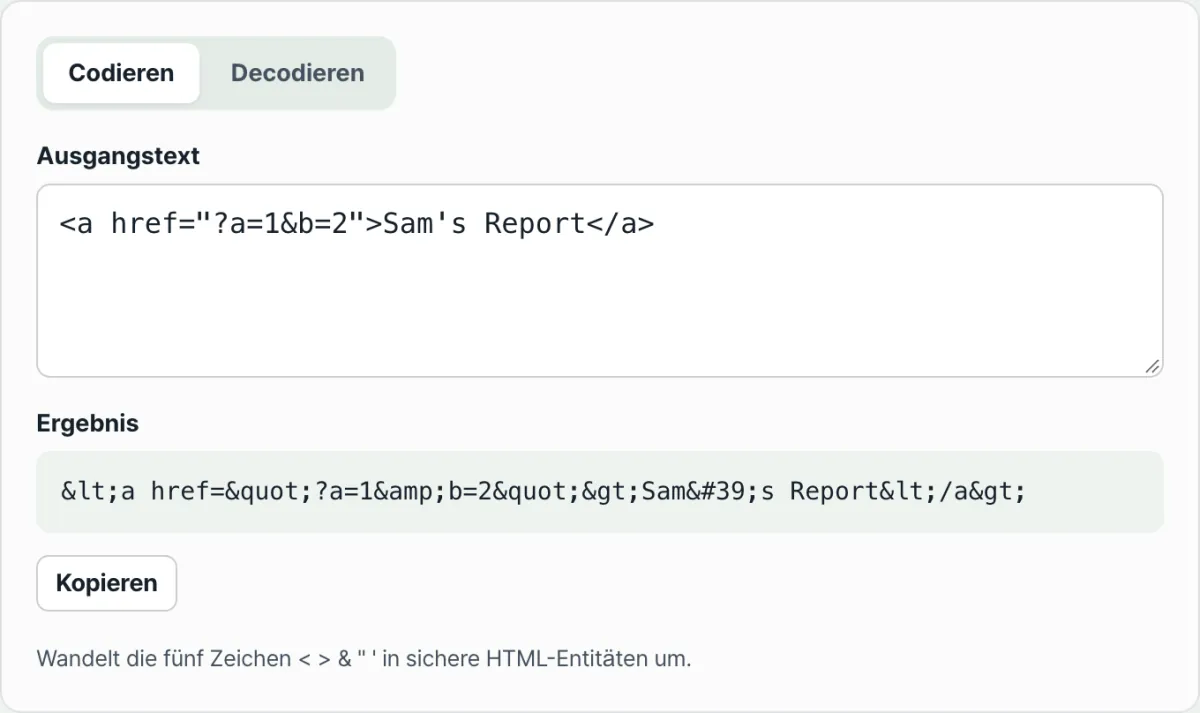
Wenn Code oder Sonderzeichen in einem Beitrag oder Template unverändert angezeigt werden sollen, aber stattdessen als Tag interpretiert werden oder die Darstellung zerstören, hilft es, fünf Zeichen (spitze Klammern, Ampersand und Anführungszeichen) durch die vorgesehenen HTML-Entities zu ersetzen. Umgekehrt gilt: Erscheinen Entities wie ' oder … als Code im Text, wandeln Sie sie nach festen Regeln wieder in die ursprünglichen Zeichen um. Dieser Beitrag zeigt, in welcher Reihenfolge und nach welchen Regeln das Kodieren und Dekodieren tatsächlich abläuft.
Zusammenfassung ① Beim Kodieren werden die fünf Zeichen
&<>"'der Reihe nach durch&<>"'ersetzt, wobei&als Erstes verarbeitet wird. ② Beim Dekodieren werden numerische Entities (dezimal oder hexadezimal, z. B.'und') sowie benannte Entities wie&und…in das ursprüngliche Zeichen zurückverwandelt. ③ Zahlen außerhalb des gültigen Bereichs und nicht registrierte Namen werden nicht umgewandelt und bleiben genau so stehen, wie Sie sie eingegeben haben.
Warum Code und Sonderzeichen auf der Seite kaputtgehen
In einem HTML-Dokument sind die spitzen Klammern (< >) das Signal zum Öffnen und Schließen von Tags, das Ampersand (&) kündigt den Beginn einer Entity an. Sieht der Browser eines dieser Zeichen, gibt er es nicht einfach aus, sondern versucht, es als Teil eines Tags oder einer Entity zu deuten.
Spürbar wird dieser Unterschied, wenn Sie Code unverändert in einen Blog- oder Forenbeitrag einfügen. Fügen Sie einen Beispielcode wie <p class="box">Text</p> direkt ein, zeigt der Browser ihn nicht als Text an, sondern interpretiert ihn als echtes Tag. Der Code verschwindet dann von der Seite oder das Layout gerät durcheinander.
Auch bei Attributwerten mit Anführungszeichen kann es je nach Editor passieren, dass Text davor oder danach abgeschnitten wird.
Es gibt auch das umgekehrte Problem: In einem kopierten Text stehen Entities wie ' oder & als Code im Klartext. An dieser Stelle sollte eigentlich ein einfaches Anführungszeichen oder ein Ampersand stehen. Diese Reste entstehen, wenn ein kodierter Wert übernommen wurde, ohne ihn zu dekodieren.
So rechnen Sie ohne Tool selbst nach
Wie das Kodieren funktioniert
Beim Kodieren wird jedes der fünf Zeichen anhand einer festen Tabelle durch eine Entity ersetzt. Ersetzen Sie die Zeichen eines Strings der Reihe nach laut dieser Tabelle, erhalten Sie dasselbe Ergebnis wie mit dem Tool.
| Zeichen | Entity | Codepoint |
|---|---|---|
& | & | U+0026 (dezimal 38) |
< | < | U+003C (dezimal 60) |
> | > | U+003E (dezimal 62) |
" | " | U+0022 (dezimal 34) |
' | ' | U+0027 (dezimal 39) |
Die Reihenfolge ist entscheidend: Ersetzen Sie zuerst &. Wandeln Sie zunächst < in < um und bearbeiten erst danach &, wird auch das & im gerade erzeugten < erneut ersetzt, und es entsteht &lt;. Verarbeiten Sie & als Erstes, tritt dieses Problem nicht auf.
Wie das Dekodieren funktioniert
Beim Dekodieren läuft es umgekehrt: Im String werden Abschnitte gesucht, die mit & beginnen und mit ; enden, und in das ursprüngliche Zeichen zurückverwandelt. Ein String, der mit & beginnt, aber kein ; enthält, wird von vornherein nicht als Entity-Muster erkannt.
Bei numerischen Abschnitten (', ') wird die Zahl hinter dem # als Codepoint gelesen. Steht davor ein x oder X, ist sie hexadezimal, andernfalls dezimal. So bezeichnen etwa dezimal 39 und hexadezimal 27 denselben Codepoint U+0027, also das einfache Anführungszeichen.
Benannte Abschnitte (&, …) werden in einer festen Namensliste nachgeschlagen und ersetzt. amp (&), lt (<), gt (>), quot ("), apos ('), nbsp (Leerzeichen), copy (©), reg (®), trade (™), hellip (…), mdash (—), ndash (–), middot (·), deg (°), euro (€), won (₩) – diese sechzehn Namen werden am häufigsten verwendet.
Im HTML-Standard sind weit mehr benannte Zeichenreferenzen definiert. Auch Zeichen ohne Namen lassen sich aber stets über ihren numerischen Codepoint darstellen. Den Codepoint eines bestimmten Zeichens finden Sie in der Zeichentabelle des Betriebssystems (Windows-Zeichentabelle, macOS-Zeichenübersicht) oder in den offiziellen Unicode-Charts.
Der eingegebene Text wird nicht an einen Server gesendet, sondern bei jedem Tastendruck sofort in Ihrem Browser berechnet.
Typische Stolperfallen
Der häufigste Fehler ist, Text erneut zu kodieren, der bereits in Entities umgewandelt wurde. Das Kodieren prüft keinen Kontext, sondern ersetzt der Reihe nach, beginnend mit &, bedingungslos. Kodieren Sie also einen Text, der bereits < enthält, noch einmal, wird auch das & darin ersetzt, und es entsteht das doppelt kodierte Ergebnis &lt;.
Beim Dekodieren kommt es dagegen oft zur Verwirrung „Warum wird das nicht umgewandelt?“. Nicht registrierte Namen und Zahlen außerhalb des gültigen Bereichs bleiben nämlich bewusst unverändert im Originaltext stehen.
| Situation | Tatsächliches Ergebnis |
|---|---|
| Bereits kodierten Text erneut kodieren | & wird wieder zu &, der Text ist doppelt kodiert (Beispiel: < → &lt;) |
Name, der nicht in der Tabelle steht (Beispiel: &foo;) | Wird nicht umgewandelt und bleibt so stehen, wie eingegeben |
Zahl außerhalb des gültigen Bereichs (Beispiel: �, über U+10FFFF) | Lässt sich nicht in einen Codepoint umwandeln und bleibt unverändert |
Name in Großbuchstaben (Beispiel: &) | Die Namenssuche unterscheidet nicht zwischen Groß- und Kleinschreibung, daher wird korrekt umgewandelt |
String, der mit & beginnt, aber kein ; enthält | Kein Entity-Muster, wird daher von vornherein nicht dekodiert |
Das Kodierergebnis erscheint immer nur in Kleinbuchstaben (& < > " '). Namen in Großbuchstaben (etwa &) werden nur beim Dekodieren erkannt und tauchen im Kodierergebnis nicht auf.
Zusammenfassung
- Kodiert werden nur die fünf Zeichen
&<>"', und&wird als Erstes ersetzt. - Beim Dekodieren werden numerische Entities, dezimal (
') oder hexadezimal ('), und benannte Entities aus der festen Namensliste in das ursprüngliche Zeichen zurückverwandelt. - Namen, die nicht in der Tabelle stehen, und Zahlen außerhalb des gültigen Bereichs werden nicht umgewandelt und bleiben unverändert.
- Kodieren Sie bereits umgewandelten Text erneut, wird
&noch einmal ersetzt, und der Text ist doppelt kodiert. - Die Berechnung erfolgt bei jeder Eingabe sofort im Browser und wird nicht an einen Server übertragen.
Der eingegebene Text wird nicht an einen Server gesendet, sondern bei jedem Tastendruck sofort in Ihrem Browser berechnet.
Häufig gestellte Fragen
Welche Zeichen werden beim Kodieren umgewandelt und wie viele sind es?
Es sind fünf Zeichen: & < > " '. Sie werden in der Reihenfolge & < > " ' ersetzt, wobei & als Erstes verarbeitet wird. Diese Reihenfolge verhindert eine doppelte Kodierung, bei der das & in einer zuvor erzeugten Entity erneut ersetzt würde.
Sind ' und ' dasselbe?
Ja. 39 ist die dezimale, 27 die hexadezimale Schreibweise, und beide bezeichnen U+0027, also das einfache Anführungszeichen. Nur die Schreibweise unterscheidet sich, das Ergebnis beim Dekodieren ist identisch.
Was passiert, wenn ich einen unbekannten Entity-Namen eingebe?
Steht der Name nicht in der unterstützten Liste (amp, lt, gt, quot, apos, nbsp, copy, reg, trade, hellip, mdash, ndash, middot, deg, euro, won), wird er nicht umgewandelt und bleibt so stehen, wie Sie ihn eingegeben haben. Es erscheint keine Fehlermeldung, der Originaltext bleibt einfach erhalten.
Wird der eingegebene Text an einen Server übertragen?
Nein. Das Kodieren und Dekodieren findet ausschließlich im Browser statt, der eingegebene Text wird weder an einen Server übertragen noch gespeichert. Das Ergebnis wird bei jedem Tastendruck sofort neu berechnet.
Dieser Artikel basiert auf unserem koreanischen Original. Koreanisches Original lesen