
Convertir entidades HTML: 5 reglas de codificación
Contenido
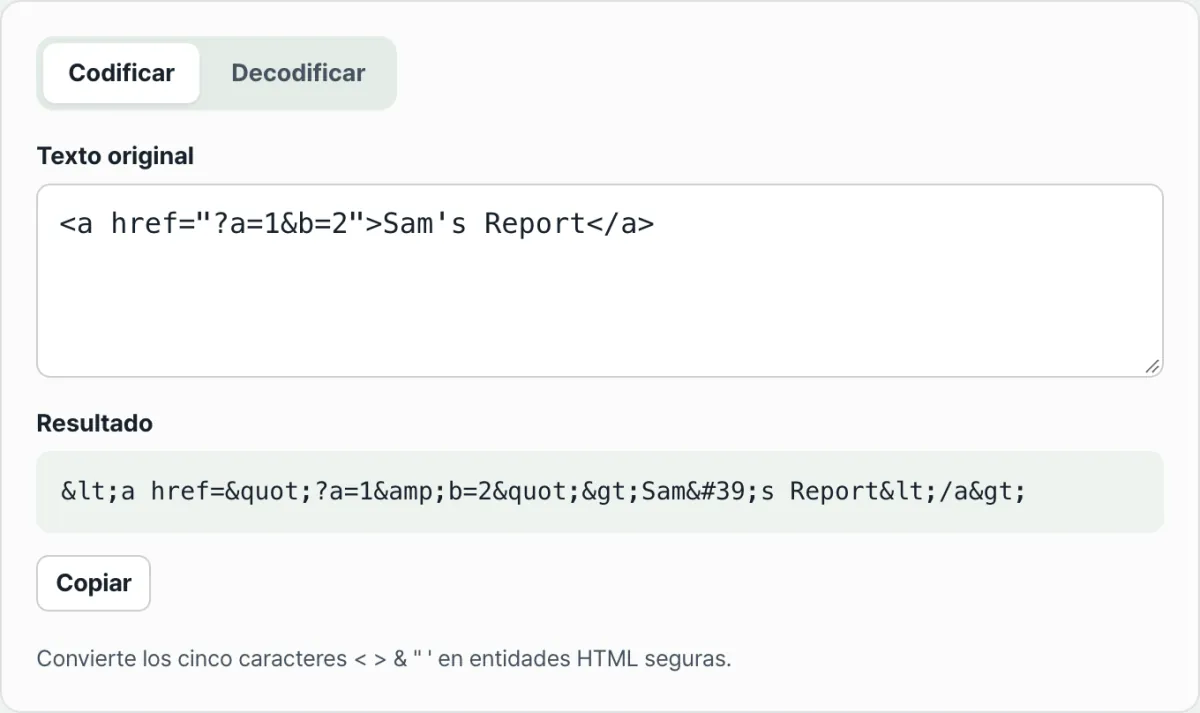
Cuando intentas mostrar tal cual un texto con código o caracteres especiales en una entrada o plantilla y acabas viendo etiquetas interpretadas o una pantalla rota, el problema se resuelve sustituyendo cinco caracteres —los signos de menor y mayor, el ampersand y las comillas— por las entidades HTML correspondientes. Y al contrario: si ves entidades como ' o … mostrándose como código literal, basta con devolverlas a su carácter original siguiendo las reglas establecidas. Este artículo explica con qué orden y con qué reglas se calculan realmente esa codificación y esa descodificación.
Resumen ① La codificación sustituye los cinco caracteres
&<>"'en este orden por&<>"', y procesa&siempre en primer lugar. ② La descodificación devuelve a su carácter original tanto las entidades numéricas decimales y hexadecimales, como'o', como las entidades con nombre, como&o…. ③ Los números fuera de rango y los nombres no registrados no se convierten y se quedan tal como los escribiste.
Por qué el código y los caracteres especiales se rompen en pantalla
En un documento HTML, los ángulos (< >) son la señal que abre y cierra etiquetas, y el ampersand (&) es la señal de que empieza una entidad. Cuando el navegador encuentra estos caracteres, no los pinta tal cual en pantalla: intenta interpretarlos como parte de una etiqueta o de una entidad.
Esta diferencia se nota mucho al pegar código directamente en el cuerpo de un blog o un foro. Si pegas un ejemplo como <p class="box">texto</p>, el navegador no lo muestra como texto, sino que lo interpreta como una etiqueta real y el fragmento desaparece de la pantalla o rompe el diseño.
Con los valores de atributo que llevan comillas pasa algo parecido: según el editor, el texto de delante y de detrás puede acabar cortado.
También existe el problema en la dirección contraria. Es lo que ocurre cuando un texto copiado de algún sitio muestra entidades como ' o & en su forma de código. Ahí debería verse una comilla simple o un ampersand, pero queda así porque se trasladó el valor codificado sin descodificarlo.
Cómo calcularlo por tu cuenta sin la herramienta
Cómo se calcula la codificación
Codificar es aplicar una tabla que traduce cinco caracteres a sus entidades correspondientes. Si sustituyes la cadena carácter a carácter según la tabla de abajo, obtienes el mismo resultado que con la herramienta.
| Carácter | Entidad | Punto de código |
|---|---|---|
& | & | U+0026 (38 en decimal) |
< | < | U+003C (60 en decimal) |
> | > | U+003E (62 en decimal) |
" | " | U+0022 (34 en decimal) |
' | ' | U+0027 (39 en decimal) |
El orden importa. Hay que cambiar & primero. Si conviertes < en < y después procesas &, el & de ese < que acabas de crear vuelve a entrar en la sustitución y se transforma en &lt;. Procesando & en primer lugar, ese problema no aparece.
Cómo se calcula la descodificación
Descodificar es la operación inversa: localizar en la cadena los fragmentos que empiezan por & y terminan en ; y devolverlos a su carácter original. Una cadena que empieza por & pero no tiene ningún ; detrás no se reconoce como patrón de entidad desde el principio.
Los fragmentos que empiezan por números (', ') se leen tomando el número que sigue a # como punto de código. Si delante hay una x o una X, es hexadecimal; si no, decimal. Por ejemplo, el 39 decimal y el 27 hexadecimal apuntan los dos a U+0027, es decir, al mismo punto de código de la comilla simple.
Los fragmentos con nombre (&, …) se buscan en la lista de nombres establecida y se sustituyen. amp (&), lt (<), gt (>), quot ("), apos ('), nbsp (espacio), copy (©), reg (®), trade (™), hellip (…), mdash (—), ndash (–), middot (·), deg (°), euro (€), won (₩): estos dieciséis son los nombres de uso más habitual.
El estándar HTML define muchas más referencias de caracteres con nombre que estas, pero cualquier carácter sin nombre siempre se puede expresar con su punto de código numérico. El punto de código de un carácter concreto lo puedes consultar en el mapa de caracteres de tu sistema operativo (el mapa de caracteres de Windows, el visor de caracteres de macOS) o en las tablas oficiales de Unicode.
El texto que escribes no se envía al servidor: se calcula al instante dentro de tu navegador cada vez que pulsas una tecla.
Puntos que suelen confundir
El error más frecuente es volver a codificar un texto que ya contiene entidades. Como la codificación no analiza el contexto y sustituye siempre por orden empezando por &, si codificas otra vez un texto que ya es <, el & que lleva dentro también cambia y obtienes una doble codificación: &lt;.
En la descodificación pasa lo contrario: es habitual preguntarse «¿y por qué no cambia?». La razón es que los nombres no registrados y los números fuera del rango válido se dejan intactos, tal cual estaban, por seguridad.
| Situación | Resultado real del procesamiento |
|---|---|
| Volver a codificar un texto ya codificado | El & vuelve a convertirse en & y se produce una doble codificación (por ejemplo, < → &lt;) |
Un nombre que no está en la tabla (por ejemplo, &foo;) | No se convierte y se queda tal como lo escribiste |
Un número fuera del rango válido (por ejemplo, �, por encima de U+10FFFF) | No se puede convertir a un punto de código y se queda igual |
Un nombre escrito en mayúsculas (por ejemplo, &) | La búsqueda del nombre distingue mayúsculas de minúsculas, así que se convierte con normalidad |
Una cadena que empieza por & pero no lleva ; detrás | No es un patrón de entidad, así que ni siquiera entra en la descodificación |
El resultado de la codificación sale siempre en minúsculas (& < > " '). Los nombres en mayúsculas (&, etc.) solo se reconocen al descodificar y nunca aparecen como resultado de una codificación.
En resumen
- Solo se codifican cinco caracteres,
&<>"', y&es el primero en cambiar. - La descodificación devuelve a su carácter original las entidades numéricas decimales (
') y hexadecimales (') y las entidades con nombre de la lista establecida. - Los nombres que no están en la tabla y los números fuera del rango válido no se convierten y se quedan tal como los escribiste.
- Si vuelves a codificar un texto que ya contiene entidades, el
&cambia otra vez y se produce una doble codificación. - El cálculo se hace al instante en el navegador cada vez que escribes y no se envía al servidor.
El texto que escribes no se envía al servidor: se calcula al instante dentro de tu navegador cada vez que pulsas una tecla.
Preguntas frecuentes
¿Cuántos caracteres se codifican y cuáles son?
Cinco: & < > " '. Se sustituyen por & < > " ' en ese orden, y & se procesa en primer lugar. Gracias a ese orden se evita la doble codificación en la que el & de una entidad creada antes vuelve a cambiar.
¿' y ' significan lo mismo?
Sí, lo mismo. 39 es notación decimal y 27 es notación hexadecimal, y ambas apuntan a U+0027, es decir, a la comilla simple. Solo cambia la forma de escribirlo; el resultado de la descodificación es idéntico.
¿Qué pasa si pongo un nombre de entidad que no conozco?
Si no está en la lista de nombres admitidos (amp, lt, gt, quot, apos, nbsp, copy, reg, trade, hellip, mdash, ndash, middot, deg, euro, won), no se convierte y se queda tal como lo escribiste. Es la forma de conservar el texto original sin mostrar ningún error.
¿El texto que escribo se envía a un servidor?
No. Los cálculos de codificación y descodificación se hacen solo dentro del navegador, y el texto que escribes no se envía ni se guarda en ningún servidor. El resultado se vuelve a calcular al instante con cada tecla que pulsas.
Este artículo está adaptado de nuestro original en coreano. Leer el original en coreano