
HTMLエンティティ変換 5つの文字規則と戻し方
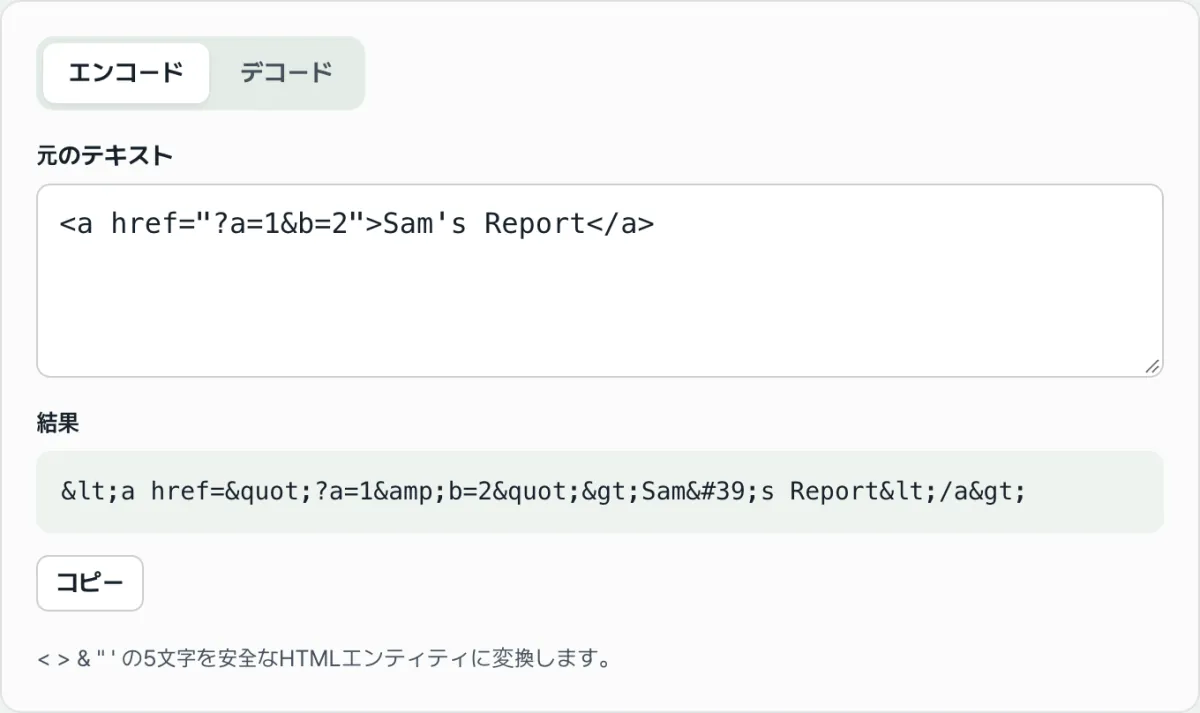
記事やテンプレートで、コードや特殊文字を含むテキストをそのまま表示しようとしてタグとして解釈されたり画面が崩れたりする問題は、山かっこ(不等号)・アンパサンド・引用符の5つの文字を決められたHTMLエンティティに置き換えれば解決します。逆に、' や … のようなエンティティがコードのまま表示されてしまった場合は、決められたルールに従って元の文字に戻せばOKです。この記事では、そのエンコード・デコードが実際にどのような順序とルールで計算されるのかを整理します。
要点 ① エンコードは
&<>"'の5文字を順番に&<>"'に置き換えるもので、&を最初に処理します。 ② デコードは'・'のような10進数・16進数の数値エンティティと、&・…のような名前付きエンティティを元の文字に戻します。 ③ 範囲外の数値や登録されていない名前は変換されず、入力したまま残ります。
コードや特殊文字が画面で崩れる理由
HTML文書において、山かっこ(< >)はタグの開始・終了を示す記号で、アンパサンド(&)はエンティティの始まりを示す記号です。ブラウザはこれらの文字を見つけると、そのまま画面に表示するのではなく、タグやエンティティの一部として解釈しようとします。
ブログや掲示板の本文にコードをそのまま貼り付けると、この違いがはっきりと現れます。<p class="box">テキスト</p> のようなサンプルコードをそのまま貼ると、ブラウザはこれを文字として見せる代わりに実際のタグとして解釈し、画面から消えたりレイアウトが崩れたりします。
引用符を含む属性値も同様で、エディタによっては前後のテキストが切り捨てられてしまうことがあります。
逆向きの問題もあります。どこかからコピーしたテキストで、' や & のようにエンティティがコードの形のまま表示されてしまうケースです。本来はシングルクォートやアンパサンドとして表示されるはずの場所ですが、エンコードされた値をデコードせずにそのまま貼り付けたときにこうなります。
ツールを使わずに自分で計算する方法
エンコードの計算方法
エンコードは、5つの文字を決められたエンティティに置き換える表の対応付けです。下の表どおりに文字列を1つずつ置換していけば、ツールと同じ結果になります。
| 文字 | エンティティ | コードポイント |
|---|---|---|
& | & | U+0026 (10進数 38) |
< | < | U+003C (10進数 60) |
> | > | U+003E (10進数 62) |
" | " | U+0022 (10進数 34) |
' | ' | U+0027 (10進数 39) |
順序が重要です。& を最初に置き換える必要があります。< を先に < に変えたあとで & を処理すると、たった今作った < の中の & まで巻き込まれて &lt; に変わってしまいます。& を最初に処理すれば、この問題は起こりません。
デコードの計算方法
デコードはその逆で、文字列の中から & で始まり ; で終わる断片を見つけ、元の文字に戻す処理です。& で始まっていても後ろに ; がない文字列は、そもそもエンティティのパターンとして認識されません。
数値で始まる断片('、')は、# の後ろの数値をコードポイントとして読み取ります。先頭に x か X があれば16進数、なければ10進数です。たとえば10進数の 39 と16進数の 27 は、どちらも U+0027、つまりシングルクォートを指す同じコードポイントです。
名前でできた断片(&、…)は、決められた名前表から探して置き換えます。amp(&)、lt(<)、gt(>)、quot(")、apos(')、nbsp(空白)、copy(©)、reg(®)、trade(™)、hellip(…)、mdash(—)、ndash(–)、middot(·)、deg(°)、euro(€)、won(₩)——この16個が代表的な名前です。
HTML標準にはこれよりはるかに多くの名前付き文字参照が定義されていますが、名前のない文字でも数値のコードポイントなら必ず表現できます。特定の文字のコードポイントは、OSの文字コード表(Windowsの文字コード表、macOSの「文字ビューア」)やUnicodeの公式チャートで確認できます。
入力したテキストはサーバーに送信されず、キーを入力するたびにブラウザ内で即座に計算されます。
間違いやすいポイント
いちばんよくある失敗は、すでにエンティティになっているテキストをもう一度エンコードしてしまうことです。エンコードは文脈を判断せず、& から順番に無条件で置換するため、すでに < になっているテキストを再度エンコードすると、その中の & まで変わり、&lt; という二重エンコードの結果になります。
デコードの側では逆に、「なぜ変わらないのか」という混乱がよく起きます。登録されていない名前や有効範囲を外れた数値は、安全のため原文のまま残す仕様になっているからです。
| 状況 | 実際の処理結果 |
|---|---|
| すでにエンコードされたテキストを再エンコード | & が再び & に変わり、二重エンコードになります(例: < → &lt;) |
表にない名前(例: &foo;) | 変換されず、入力したまま残ります |
有効範囲を外れた数値(例: �、U+10FFFF を超える) | コードポイントに変換できないため、そのまま残ります |
大文字で書いた名前(例: &) | 名前の照合では大文字・小文字を区別しないため、正常に変換されます |
& で始まるものの後ろに ; がない文字列 | エンティティのパターンではないため、そもそもデコードの対象になりません |
エンコードの結果は常に小文字の形(& < > " ')でしか出力されません。大文字の名前(& など)はデコードのときだけ認識され、エンコードの結果として出てくることはありません。
まとめ
- エンコードの対象は
&<>"'の5文字だけで、&が最初に変わります。 - デコードは、10進数(
')・16進数(')の数値エンティティと、決められた名前表にある名前付きエンティティを元の文字に戻します。 - 表にない名前や有効範囲を外れた数値は変換されず、入力したまま残ります。
- すでにエンティティになったテキストを再度エンコードすると、
&がまた変わり二重エンコードになります。 - 計算はブラウザ内で入力のたびに即座に行われ、サーバーに送信されることはありません。
入力したテキストはサーバーに送信されず、キーを入力するたびにブラウザ内で即座に計算されます。
よくある質問
どの文字がいくつエンコードされますか?
& < > " ' の5文字です。& < > " ' の順で、& が最初に処理されます。この順序のおかげで、後から作られたエンティティの中の & が再び変わる二重エンコードを防げます。
' と ' は同じ意味ですか?
はい、同じです。39 は10進数、27 は16進数の表記で、どちらも U+0027、つまりシングルクォートを指します。表記が違うだけで、デコード結果は同じです。
知らないエンティティ名を入力するとどうなりますか?
対応している名前表(amp、lt、gt、quot、apos、nbsp、copy、reg、trade、hellip、mdash、ndash、middot、deg、euro、won)にない場合は変換せず、入力したまま残します。エラー表示を出さずに原文を保持する方式です。
入力したテキストはサーバーに送信されますか?
いいえ。エンコード・デコードの計算はすべてブラウザ内だけで行われ、入力したテキストがサーバーに送信されたり保存されたりすることはありません。キーを入力するたびに結果がすぐに再計算されます。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む