
文字列エスケープの変換ルール|JSON・JSでの対応表
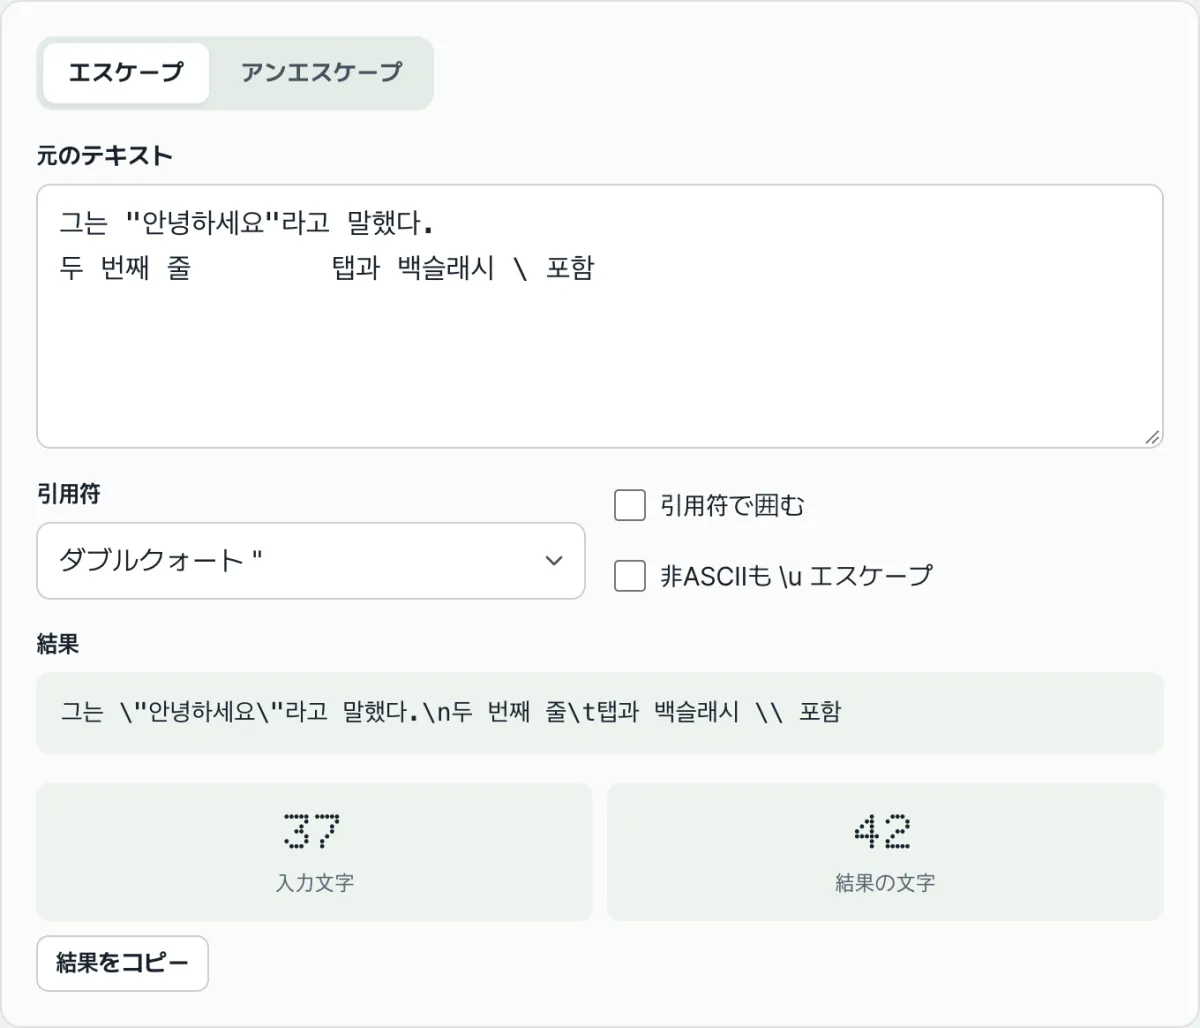
引用符・バックスラッシュ・改行が混ざったテキストをそのまま JSON や JavaScript の文字列に貼り付けると、文字列が途中で途切れたり、構文エラーになったりします。エスケープは、こうした文字を文字列の中で安全な表記に1文字ずつ置き換える作業で、アンエスケープはその逆方向の作業です。
この記事では、元の特殊文字が結果の中で具体的に何に置き換わるのかを表で示します。あわせて、つまずきやすいポイントを「結果をどう読むか」という観点で整理します。
要約 ① エスケープは元のテキストを1文字ずつ走査し、バックスラッシュは
\\、選んだ引用符は\"、改行は\n、タブは\t、そのほかの 0x20 未満の制御文字は\uXXXXに置き換えます。 ② 逆方向のアンエスケープは、\n\t\uXXXXなどの表記を元の文字に戻します。両端に引用符が残っている場合は、自動で外すオプションを使わないと結果がずれます。 ③ つまずきやすいのは、バックスラッシュを最初に処理せず二重に置き換わってしまうケースと、入力の引用符と選んだ引用符が違うために想定と異なる結果になるケースです。
貼り付けた途端に引用符で途切れ、改行でエラーになります
複数行のログメッセージや API レスポンスのテキストを、JSON 設定ファイルの値1つに入れたい場面を考えてみます。そのテキストにはたいてい二重引用符が含まれていて、複数行なので実際の改行文字も入っています。
これを "..." の間にそのまま貼り付けると、本文中の二重引用符が文字列を囲む二重引用符とぶつかり、その位置で文字列が途切れます。さらに、JSON や JavaScript の通常の文字列は、値の中に実際の改行文字を入れることを認めていません。そのため、行が変わる箇所ごとに構文エラーが出ます。
Windows のパスもよくある例です。C:\new\test を文字列にそのまま入れると、\n と \t がそれぞれ改行とタブとして解釈され、画面に出力される値が元のものと変わってしまいます。こうした文字を「文字列の中で安全な表記」に置き換えるのがエスケープです。
ツールを使わずに手作業でエスケープする方法
考え方はシンプルです。元のテキストを左から1文字ずつ読み、文字列リテラルを壊しうる文字だけを決まった表記に置き換えます。順序が大切です。
- 囲む引用符を決めます。 結果を二重引用符のリテラルに入れるのか、一重引用符か、バッククォートかによって、エスケープの対象が変わります。デフォルトは二重引用符です。
- バックスラッシュを最初に置き換えます。 バックスラッシュ(
\)を\\に置き換えます。最初にこの作業をするのは、後で引用符をエスケープするときに新しく加わるバックスラッシュまで、もう一度処理してしまう二重処理を防ぐためです。 - 選んだ引用符を置き換えます。 選んだ引用符の前にバックスラッシュを付けます。二重引用符を選んだ場合、
"は\"になります。このとき、選ばなかった別の種類の引用符には手を加えません。 - 改行系の文字を表記に置き換えます。 改行は
\n、キャリッジリターンは\r、タブは\t、バックスペースは\b、フォームフィードは\fに置き換えます。 - 残りの制御文字を処理します。 上記に名前のない 0x20 未満の制御文字(ヌル、垂直タブ、ESC など)は、
\uの後ろに4桁の16進数を付けた\uXXXXの形に置き換えます。
元の各文字が結果でどう対応するかをまとめると、次のとおりです。
| 元の文字 | エスケープ結果 |
|---|---|
バックスラッシュ \ | \\ |
選んだ引用符(デフォルトは ") | \" |
| 改行(LF) | \n |
| キャリッジリターン(CR) | \r |
| タブ | \t |
| バックスペース | \b |
| フォームフィード | \f |
| そのほかの 0x20 未満の制御文字 | \uXXXX |
このほかに、選択できるオプションが2つあります。引用符で囲むをオンにすると、結果全体を選んだ引用符で1回囲み、そのまま貼り付けられるリテラルにします。非ASCIIも \u エスケープをオンにすると、日本語や絵文字のように ASCII の範囲を超える文字も \uXXXX に置き換わります。このとき、U+FFFF を超える文字(ほとんどの絵文字)は、サロゲートペア2つ(\uXXXX\uXXXX)に分かれます。
逆方向のアンエスケープは、ルールをたどり直す形になります。\ に出会ったら次の文字を見て、\n \r \t \b \f \v \0 は対応する制御文字に、\xXX \uXXXX \u{XXXXX} はそのコードに当たる文字に戻します。エスケープされた引用符・バックスラッシュ・スラッシュは、元の記号に戻します。文字列の両端を同じ引用符が囲んでいる場合は、その1組を外します。
方向による違いが1つあります。エスケープは、垂直タブとヌル文字を \v \0 ではなく \uXXXX の形で出力しますが、アンエスケープは \v \0 という表記も元の文字として認識します。
「文字列エスケープ」で確認してみましょう。
エスケープとアンエスケープの両方向を、ブラウザー上でそのまま変換できます。インストールや会員登録は不要で、入力したテキストがサーバーに送信されることもありません。
結果をどう読むか: つまずきやすい3つのポイント
ルール自体は、ここまでで全部です。結果が想定と違ってしまうのは、たいてい次の3つのポイントです。
| 状況 | 結果がずれる理由 | 合わせ方 |
|---|---|---|
| バックスラッシュの処理が後回し | 先に入れた \" のバックスラッシュが、さらに \\ に二重処理される | バックスラッシュを最初にエスケープする |
| 入力の引用符 ≠ 選んだ引用符 | 選んだ引用符だけが置き換わり、ほかの引用符はそのまま残る | 囲むリテラルと同じ引用符を選ぶ |
| アンエスケープ時に両端の引用符が残る | 前後の " が本文に混ざり、結果が1文字ずつずれる | 両端の引用符の自動削除をオンにする |
バックスラッシュの順序の問題。 手作業で引用符を先に置き換えると、そのとき新しく付けたバックスラッシュまで、次の段階でもう一度 \\ に置き換わってしまいます。ツールは元のテキストを左から右へ1回だけ走査し、新しく入れたバックスラッシュを読み直さないので、この二重処理は起こりません。
引用符の種類の不一致。 一重引用符のリテラルに入れるテキストを二重引用符モードでエスケープすると、本文中の一重引用符はそのまま残ります。その結果を '...' の中に貼り付けると、残っていた一重引用符の位置で文字列が途切れます。まずは、結果を囲む引用符とツールで選んだ引用符が同じかどうかを確認してください。
アンエスケープ時の両端の引用符。 "あ\tHello" のように前後が引用符で囲まれた文字列を元に戻すとき、その引用符を外さないと、結果の前後に引用符が1文字ずつそのまま残ります。両端の引用符の自動削除をオンにすると、前後の文字が同じ引用符の場合に限り、その1組だけを外します。
まとめ
- エスケープは、元のテキストを1文字ずつ読み、バックスラッシュ →
\\、選んだ引用符 →\"、改行 →\n、タブ →\t、そのほかの 0x20 未満の制御文字 →\uXXXXに置き換えます。 - 手作業の場合は、バックスラッシュを最初に処理することで二重処理を避けられます。ツールは1回だけ走査するので、この問題を自動で避けられます。
- エスケープの対象は、選んだ引用符によって変わります。結果を入れるリテラルの引用符と同じ種類を選べば、想定どおりの結果になります。
- アンエスケープは逆方向に
\n\uXXXXなどを元に戻します。両端の引用符は、自動削除のオプションで外さないと結果がずれます。 - 非ASCIIも
\uエスケープをオンにすると、日本語や絵文字が\uXXXXに、U+FFFF を超える文字はサロゲートペアに置き換わります。
エスケープとアンエスケープの両方向を、ブラウザー上でそのまま変換できます。インストールや会員登録は不要で、入力したテキストがサーバーに送信されることもありません。
よくある質問
エスケープとアンエスケープは何が違うのですか?
変換の方向が逆です。エスケープは、人が読む元のテキストを文字列リテラルに入れられる表記(\n \" など)に変換し、アンエスケープはその表記を元の文字に戻します。ツール上部のタブで2つの方向を切り替えられ、入力が変わるたびに、結果と入力・結果の文字数がすぐに再計算されます。
日本語や絵文字も \u に変換できますか?
「非ASCII文字も \u でエスケープ」オプションをオンにすると、日本語や絵文字などASCIIの範囲外の文字も \uXXXX の形式に変換されます。U+FFFFを超える文字、つまりほとんどの絵文字は、サロゲートペアの2つに分かれます。オプションをオフにしておけば、こうした文字は元の姿のまま残ります。
シングルクォートで囲むつもりなのに、ダブルクォートがそのまま出力されるのはなぜですか?
引用符の選択がダブルクォートになっている場合、エスケープの対象はダブルクォートだけなので、本文中のシングルクォートには手を加えません。結果を '...' の中に入れる予定なら、引用符の選択をシングルクォートに切り替えてください。そうすると、シングルクォートが \' にエスケープされます。囲むリテラルと同じ引用符を選ぶことがポイントです。
アンエスケープすると前後に引用符が残ってしまいます。
入力した文字列の両端が引用符で囲まれていて、「両端の引用符を自動で削除」がオフになっている場合、その引用符は本文の一部として扱われ、結果の前後にそのまま残ります。オプションをオンにすると、前後の文字が同じ引用符(ダブルクォート・シングルクォート・バッククォート)のときに限り、その1組だけを取り除いてから残りを元に戻します。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む