
テキストを2進数に変換する仕組み|UTF-8とバイト数
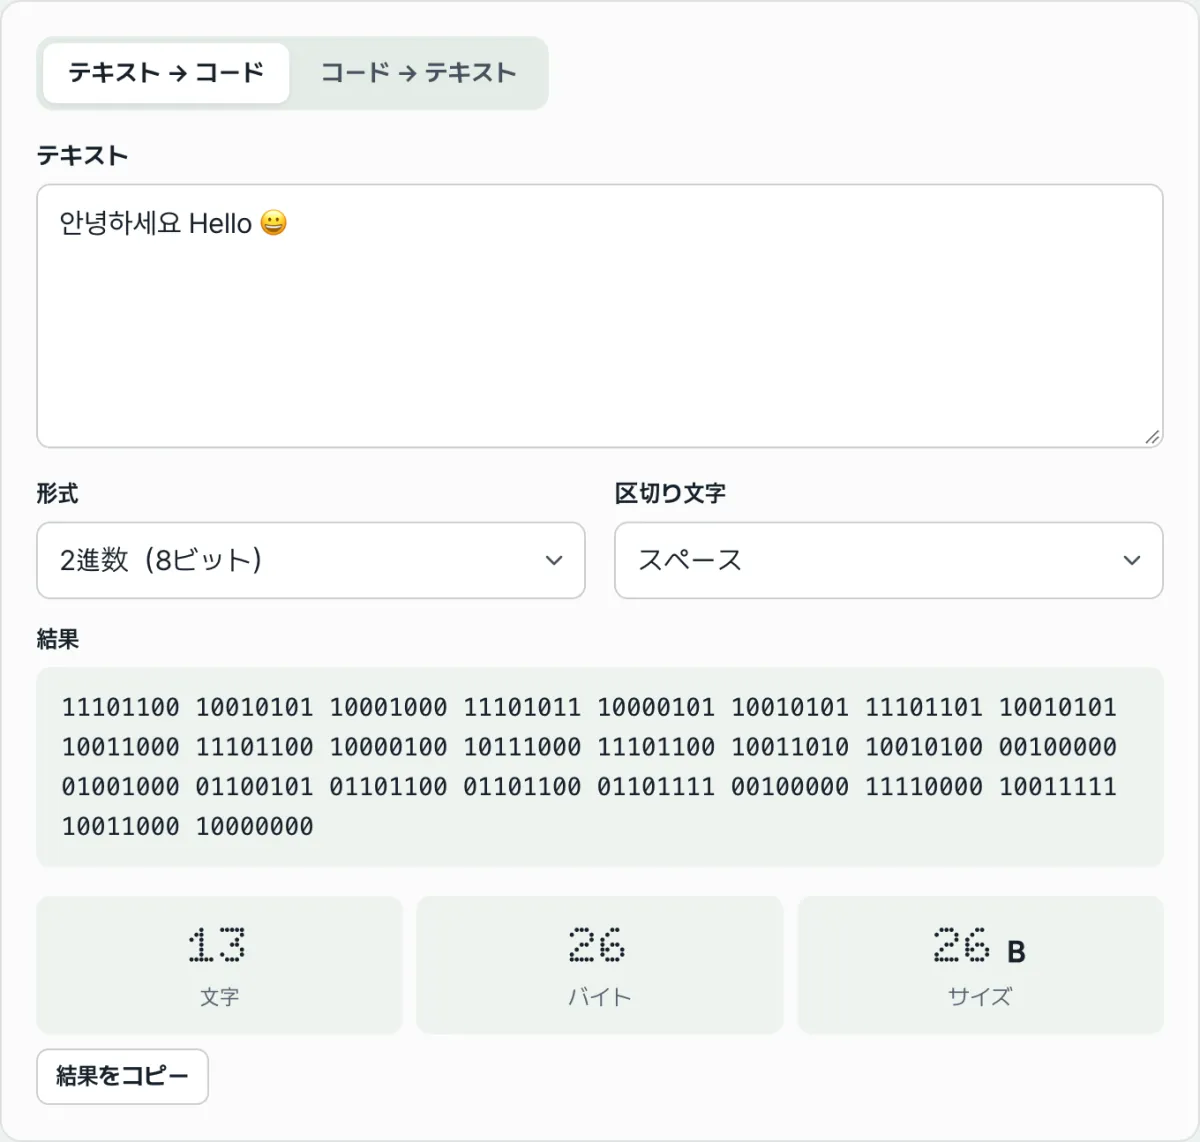
入力した「가」という1文字が、なぜ画面で24個の0と1になって現れるのか。その答えは、コンピューターが文字を「バイト」という8ビットのまとまり単位で保存しているからです。英字は1バイト、ハングルは通常3バイト、絵文字は4バイトなので、1文字が複数の8桁の2進数に分かれます。
この記事では、文字が0と1に変わる過程をUTF-8の規則どおりに説明し、逆にそのコードを文字へ戻すときにつまずきやすいポイントまで、検証できる事実を中心に整理します。
まとめ ① コンピューターは文字をUTF-8のバイトに変換したうえで、各バイトを8桁の2進数、または2桁の16進数で表します。 ② 英字は1バイト・ハングルは3バイト・絵文字は4バイトなので、1文字が複数の8ビットのまとまりとして出てきます。 ③ 復元は2進数なら8桁、16進数なら2桁ずつ区切って読むもので、桁数が合わないときや不正なバイトの組み合わせでは失敗するか、�として表示されます。
「안녕」は2文字なのに、なぜ6バイトなのか
テキストエディタで「안녕」の2文字だけを入力してUTF-8で保存すると、ファイルには6バイトが入ります。文字は明らかに2つなのに、容量はその3倍です。
ここから「文字数」と「バイト数」が別の値だという事実が見えてきます。コンピューターは文字を数えているのではなく、バイトを数えて保存しているからです。
ハングル1文字はUTF-8では通常3バイトを占めます。つまり「안」が3バイト、「녕」が3バイトで、合わせて6バイトになります。この3倍という関係がどこから来るのかがわかれば、2進数に変換したときにあれほど長い0と1の並びになる理由も同時に理解できます。
ツールを使わずに文字を2進数へ変換する方法
すべての工程は手作業でも行えます。手順は3ステップです。
ステップ1 — 文字をバイトに変える。 コンピューターは文字ごとに決められた番号(コードポイント)を、UTF-8の規則に従って1〜4個のバイトに分けます。英字の「A」は番号が65番で1バイト、ハングルの「가」は3バイトに分かれます。
ステップ2 — 各バイトを8桁の2進数で書く。 1バイトは0から255までの値です。この値を2進数で書き、8桁に満たなければ先頭を0で埋めます。「A」(65)は2進数では1000001ですが、8桁に合わせると01000001になります。
ステップ3 — バイトが複数あればつなげる。 「가」はバイト値が234・176・128の3つなので、それぞれ11101010・10110000・10000000になり、つなげると24桁になります。
16進数表記と値を自分で確かめる方法
16進数はもっと単純です。各バイトを2桁の16進数で書けばよいだけです。「A」は41、「가」はea b0 80です。8桁の2進数1バイトは、16進数ではちょうど2桁に対応します。
自分で確かめたいときは、ブラウザの開発者ツールのコンソールで new TextEncoder().encode('가') を実行すると [234, 176, 128] が返ります。この値がそれぞれea・b0・80にあたり、Pythonでは '가'.encode('utf-8') で同じ結果が得られます。
問題は、文字が増えるとこの計算を1文字ずつ繰り返さなければならないことです。
私たちの無料ツール「テキスト ↔ 2進数変換ツール」で確認する。
インストールや会員登録なしで、ブラウザ上でテキストをUTF-8基準の2進数・16進数に変換し、そのコードを元のテキストに復元できます。
復元するときにつまずきやすいポイント
2進数や16進数のコードを文字に戻すときには、決まったルールがあります。復元ツールは2進数なら8桁ずつ、16進数なら2桁ずつ区切って、それぞれのまとまりを1バイトとして読みます。そのため区切り文字(空白)はあってもなくてもかまいません。
問題は、この「区切って読む」が成り立たないときです。以下が代表的なケースです。
| 症状 | 原因 | 確認方法 |
|---|---|---|
| 2進数が文字にならない | 0と1の合計個数が8の倍数でない | 8の倍数か(1バイト=8桁)確認する |
| 16進数が文字にならない | 桁数が奇数 | 偶数桁か(1バイト=2桁)確認する |
| つなげて書いたコードも変換できる | 8ビット・2桁ずつ自動で区切る | 区切り文字はあってもなくてもよい |
| 文字の代わりに�が出る | 有効なUTF-8ではないバイトの組み合わせ | 元のコードが途中で切れたり混ざったりしていないか確認する |
| 16進数なのに2進数として読まれる | 0と1しかないため自動判定が2進数と判断する | 形式を16進数に自分で指定する |
最後の2行をもう少し詳しく見てみます。たとえば2進数の入力欄に10000000を1つだけ入れると、これは単独では使えないバイトなので、有効な文字として復元されず、代替文字の�として表示されます。コードが欠けていないか見直すべきだという合図です。
また、自動判定モードは入力に0と1しかなければ2進数と判断します。そのため「01」や「10」のような16進数の値は2進数と誤認されることがあるので、その場合は形式を16進数に自分で指定すれば解決します。なお、バイト数が文字数より大きくなるのはエラーではなく、ハングルや絵文字が複数のバイトで成り立っているために起こる正常な結果です。
まとめ
- コンピューターは文字をUTF-8のバイトに変換し、各バイトを8桁の2進数、または2桁の16進数で表します。
- 英字は1バイト・ハングルは3バイト・絵文字は4バイトなので、1文字が複数のまとまりに分かれ、バイト数は文字数より大きくなります。
- 復元は2進数なら8桁、16進数なら2桁ずつ区切って読むので、区切り文字はなくてもかまいません。
- 2進数の全体の長さが8の倍数でない場合や、16進数が奇数桁の場合は復元されず、案内メッセージが表示されます。
- 有効なUTF-8ではないバイトの組み合わせは、代替文字の�として表示されます。
インストールや会員登録なしで、ブラウザ上でテキストをUTF-8基準の2進数・16進数に変換し、そのコードを元のテキストに復元できます。
よくある質問
ハングル1文字が2進数で24桁になるのはなぜですか?
ハングルはUTF-8では通常3バイトで保存され、1バイトは8桁の2進数だからです。3バイト × 8桁 = 24桁になります。英字は1バイトなので8桁、絵文字は4バイトなので32桁になります。
区切り(空白)なしでつなげた2進数も復元できますか?
できます。2進数は8桁ずつ、16進数は2桁ずつ自動で区切って読みます。ただし全体の長さが、2進数では8の倍数、16進数では偶数桁である必要があり、桁数が合わない場合は案内メッセージが表示されます。
復元したら �(四角やはてな)記号が出ました。なぜですか?
バイトの組み合わせが有効なUTF-8ではないからです。たとえば単独では使えないバイトが混ざると、復元ツールは元の文字を特定できず、代替文字の�として表示します。元のコードが途中で切れていないか、別の値と混ざっていないかを確認すれば解決します。
2進数と16進数は何が違うのですか?
同じバイトを書き方を変えて表したもので、含まれる情報量は同じです。1バイトを2進数では8桁、16進数では2桁で表します。16進数は短く見やすいのに対し、2進数はビット1つ1つをそのまま見せてくれるという違いがあります。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む