
Texto a binario UTF-8: cómo se convierte cada letra en 0 y 1
Contenido
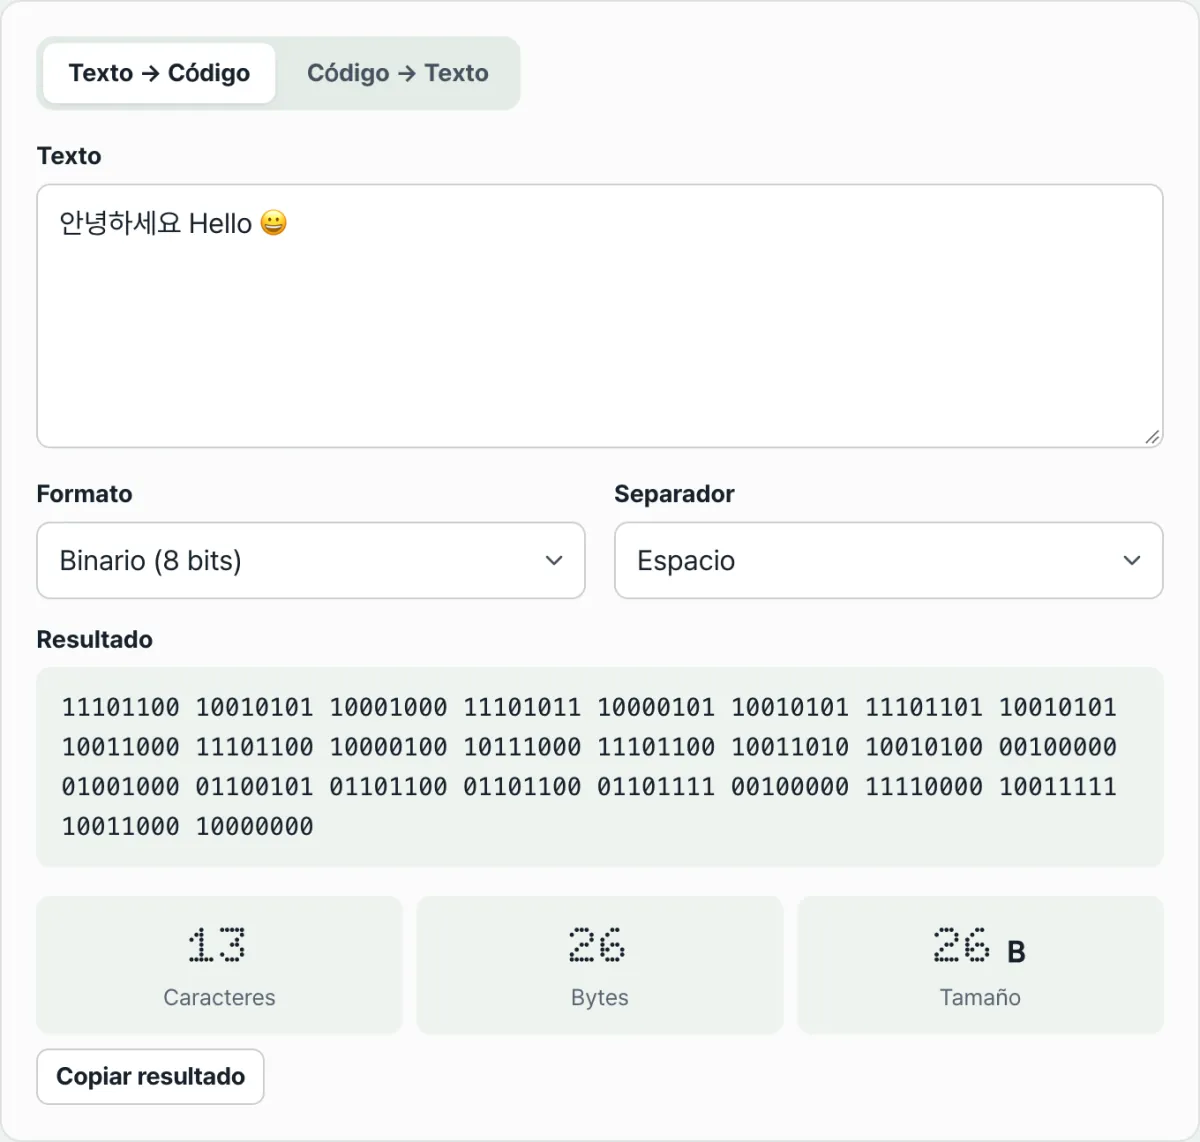
Si alguna vez te has preguntado por qué un solo carácter como '가' acaba saliendo en pantalla como 24 ceros y unos, la respuesta es que la computadora guarda el texto en unidades de 8 bits llamadas «bytes». Las letras latinas ocupan 1 byte, el hangul (coreano) normalmente 3 bytes y los emojis 4 bytes, así que un único carácter se divide en varios números binarios de 8 dígitos.
Este artículo explica paso a paso cómo un carácter se convierte en 0 y 1 siguiendo las reglas de UTF-8 y, en sentido contrario, repasa los puntos en los que más se atasca la conversión de esos códigos de vuelta a texto, centrándose en hechos que puedes verificar.
En resumen ① La computadora convierte el texto en bytes UTF-8 y después representa cada byte como un número binario de 8 dígitos o un número hexadecimal de 2 dígitos. ② Como las letras latinas ocupan 1 byte, el hangul 3 bytes y los emojis 4 bytes, un solo carácter sale como varios grupos de 8 bits. ③ Para reconstruir el texto se leen bloques de 8 dígitos en binario y de 2 dígitos en hexadecimal; si el número de dígitos no cuadra o la combinación de bytes no es válida, la conversión falla o aparece �.
'안녕' son dos caracteres, ¿por qué ocupa 6 bytes?
Si en un editor de texto escribes solo los dos caracteres '안녕' y guardas en UTF-8, el archivo ocupa 6 bytes. Son claramente dos caracteres, pero el tamaño es el triple.
Aquí se ve que «número de caracteres» y «número de bytes» son valores distintos. La computadora no cuenta caracteres: cuenta y almacena bytes.
Un carácter de hangul ocupa normalmente 3 bytes en UTF-8. Así, '안' ocupa 3 bytes, '녕' ocupa 3 bytes y juntos suman 6 bytes. Si entiendes de dónde sale ese factor de 3, también se aclara por qué al pasarlo a binario aparece una lista tan larga de ceros y unos.
Cómo convertir texto a binario sin herramientas
Puedes hacer todo el proceso a mano. Son tres pasos.
Paso 1 — Convierte el carácter en bytes. La computadora asigna a cada carácter un número determinado (punto de código) y lo reparte en 1 a 4 bytes según las reglas de UTF-8. La 'A' latina tiene el número 65 y ocupa 1 byte; la '가' del hangul ocupa 3 bytes.
Paso 2 — Escribe cada byte como un número binario de 8 dígitos. Un byte es un valor de 0 a 255. Ese valor se escribe en binario y, si no llega a 8 dígitos, se rellena con ceros a la izquierda. 'A' (65) en binario es 1000001, pero ajustado a 8 dígitos queda 01000001.
Paso 3 — Si hay varios bytes, únelos. '가' tiene tres valores de byte, 234, 176 y 128, que corresponden a 11101010 · 10110000 · 10000000; al unirlos salen 24 dígitos.
La notación hexadecimal y cómo comprobar los valores tú mismo
El hexadecimal es más sencillo: basta con escribir cada byte como un número hexadecimal de 2 dígitos. 'A' es 41 y '가' es ea b0 80. Un byte, es decir 8 dígitos binarios, corresponde exactamente a 2 dígitos hexadecimales.
Si quieres comprobarlo tú mismo, ejecuta new TextEncoder().encode('가') en la consola de herramientas de desarrollo del navegador y obtendrás [234, 176, 128]. Esos valores son ea, b0 y 80 respectivamente, y en Python puedes ver el mismo resultado con '가'.encode('utf-8').
El problema es que, cuando hay mucho texto, tienes que repetir este cálculo carácter por carácter.
Compruébalo con nuestra herramienta.
Sin instalaciones ni registro: convierte texto a binario y hexadecimal en UTF-8 desde el navegador, y recupera el texto original a partir del código.
Los puntos donde más se atasca la conversión de vuelta
Para pasar un código binario o hexadecimal de vuelta a texto hay reglas fijas. El conversor corta el binario cada 8 dígitos y el hexadecimal cada 2, y lee cada bloque como un byte. Por eso los separadores (espacios) pueden estar o no.
El problema aparece cuando ese corte no cuadra. Estos son los casos más habituales.
| Síntoma | Causa | Cómo comprobarlo |
|---|---|---|
| El binario no se convierte en texto | La cantidad total de 0 y 1 no es múltiplo de 8 | Comprueba que sea múltiplo de 8 (un byte = 8 dígitos) |
| El hexadecimal no se convierte | El número de dígitos es impar | Comprueba que tenga un número par de dígitos (un byte = 2 dígitos) |
| El código pegado sin espacios también funciona | Se corta automáticamente cada 8 bits o cada 2 dígitos | Los separadores son opcionales |
| Aparece � en lugar del carácter | La combinación de bytes no es UTF-8 válido | Comprueba que el código original no esté cortado ni mezclado |
| Es hexadecimal, pero se lee como binario | Solo contiene 0 y 1, así que la detección automática lo toma por binario | Indica el formato hexadecimal manualmente |
Vamos a detallar las dos últimas filas. Por ejemplo, si en el campo de binario escribes solo 10000000, es un byte que no puede aparecer por sí solo, así que no se reconstruye como carácter válido y se muestra el carácter de reemplazo �. Es la señal de que conviene revisar si el código está completo.
Además, el modo de detección automática decide que la entrada es binaria si solo contiene 0 y 1. Por eso valores hexadecimales como '01' o '10' pueden confundirse con binario; en ese caso basta con indicar el formato hexadecimal a mano. Ten en cuenta que un número de bytes mayor que el de caracteres no es un error: es el resultado normal cuando el hangul o los emojis ocupan varios bytes.
Para terminar
- La computadora convierte el texto en bytes UTF-8 y representa cada byte como un número binario de 8 dígitos o un número hexadecimal de 2 dígitos.
- Como las letras latinas ocupan 1 byte, el hangul 3 bytes y los emojis 4 bytes, un carácter se divide en varios bloques y el número de bytes supera al de caracteres.
- La conversión de vuelta se lee en bloques de 8 dígitos en binario y de 2 dígitos en hexadecimal, así que los separadores no son necesarios.
- Si la longitud total del binario no es múltiplo de 8 o el hexadecimal tiene un número impar de dígitos, no se convierte y aparece un mensaje de aviso.
- Las combinaciones de bytes que no son UTF-8 válido se muestran con el carácter de reemplazo �.
Sin instalaciones ni registro: convierte texto a binario y hexadecimal en UTF-8 desde el navegador, y recupera el texto original a partir del código.
Preguntas frecuentes
¿Por qué un solo carácter de hangul ocupa 24 dígitos en binario?
Porque el hangul se guarda normalmente en 3 bytes en UTF-8 y cada byte son 8 dígitos binarios. 3 bytes × 8 dígitos = 24 dígitos. Las letras latinas ocupan 1 byte y dan 8 dígitos, y los emojis 4 bytes y dan 32 dígitos.
¿Se puede reconstruir un binario escrito sin separadores (espacios)?
Sí. El binario se corta automáticamente cada 8 dígitos y el hexadecimal cada 2. Eso sí, la longitud total debe ser múltiplo de 8 en el binario y un número par de dígitos en el hexadecimal; si no cuadra, aparece un mensaje de aviso.
Al convertir de vuelta me aparece el símbolo � (un rombo con un signo de interrogación). ¿Por qué?
Porque la combinación de bytes no es UTF-8 válido. Por ejemplo, si se mezcla un byte que no puede aparecer por sí solo, el conversor no puede saber cuál era el carácter original y muestra el carácter de reemplazo �. Comprueba que el código original no se haya cortado por el medio ni se haya mezclado con otro valor.
¿En qué se diferencian el binario y el hexadecimal?
Son formas distintas de escribir los mismos bytes, así que contienen la misma cantidad de información. Un byte se escribe con 8 dígitos en binario y con 2 dígitos en hexadecimal. El hexadecimal es más cómodo de leer porque es más corto, mientras que el binario muestra cada bit tal cual.
Este artículo está adaptado de nuestro original en coreano. Leer el original en coreano