
Text in Binär umwandeln: Wie aus Buchstaben 0 und 1 werden
Inhalt
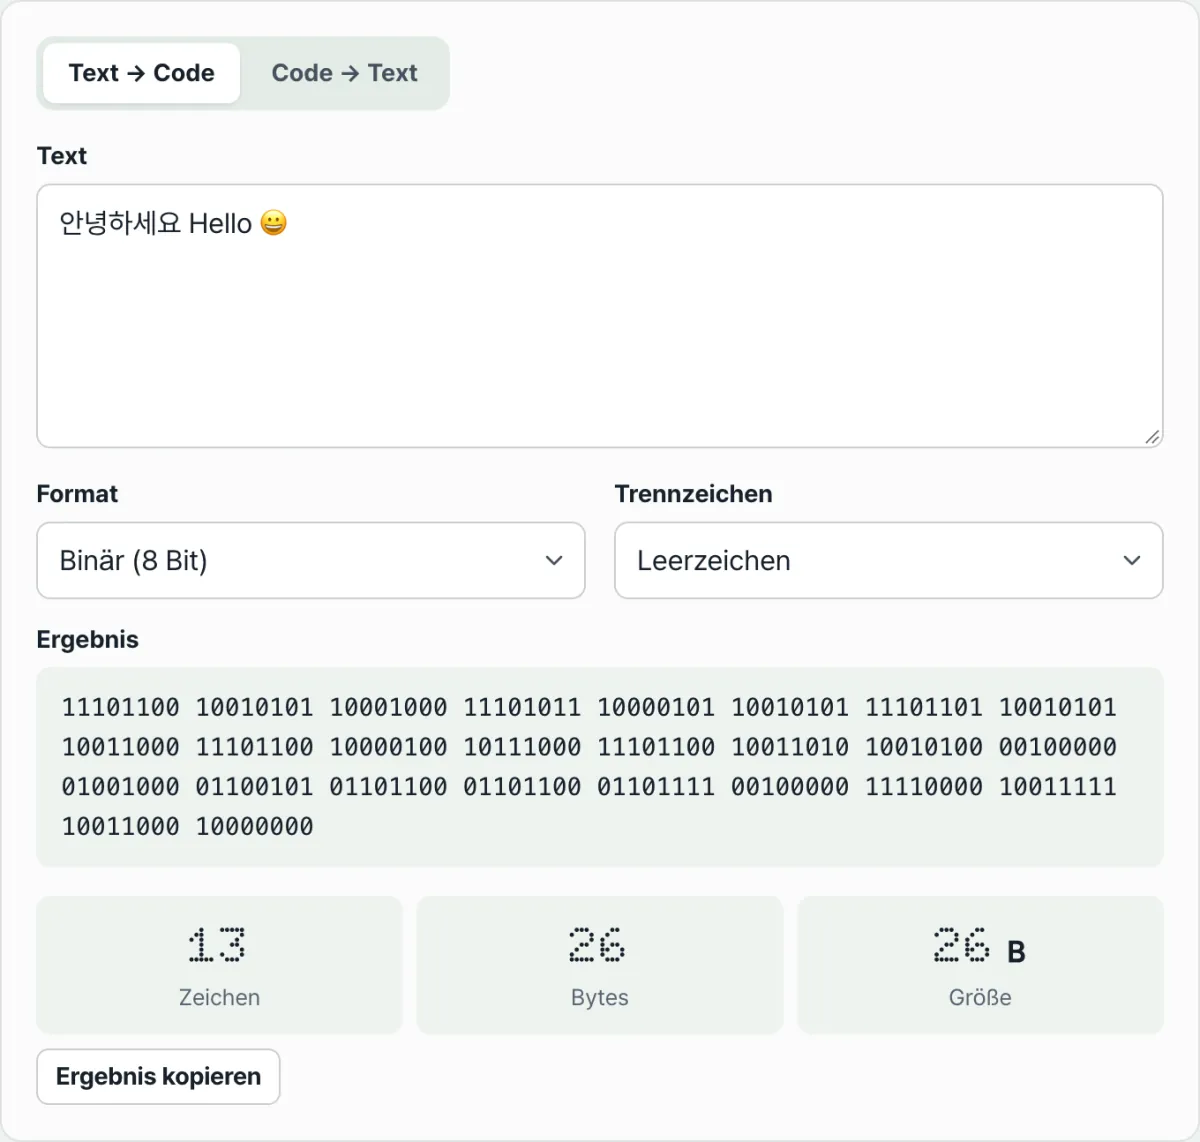
Wenn Sie sich gefragt haben, warum ein einziges eingegebenes Zeichen wie „가“ auf dem Bildschirm als 24 Nullen und Einsen erscheint, liegt die Antwort darin, dass Computer Zeichen in Bytes speichern, also in Einheiten aus jeweils 8 Bit. Lateinische Buchstaben belegen 1 Byte, koreanische Hangul-Zeichen in der Regel 3 Bytes und Emojis 4 Bytes. Deshalb wird ein einzelnes Zeichen in mehrere achtstellige Binärzahlen zerlegt.
Dieser Artikel erklärt, wie aus Zeichen Nullen und Einsen werden – streng nach den UTF-8-Regeln. Außerdem zeigt er, an welchen Stellen es typischerweise hakt, wenn Sie einen solchen Code wieder in Text zurückverwandeln. Im Mittelpunkt stehen überprüfbare Fakten.
Kurzfassung ① Ein Computer wandelt Text zunächst in UTF-8-Bytes um und stellt jedes Byte als achtstellige Binärzahl oder zweistellige Hexadezimalzahl dar. ② Lateinische Buchstaben belegen 1 Byte, Hangul 3 Bytes, Emojis 4 Bytes – ein Zeichen kann also aus mehreren 8-Bit-Blöcken bestehen. ③ Bei der Rückumwandlung wird der Code in Blöcke von 8 Binärstellen bzw. 2 Hexadezimalstellen zerlegt. Stimmt die Stellenzahl nicht oder ist die Bytefolge ungültig, schlägt die Umwandlung fehl oder es erscheint �.
Warum belegt „안녕“ mit nur zwei Zeichen 6 Bytes?
Wenn Sie in einem Texteditor nur die zwei Zeichen „안녕“ schreiben und als UTF-8 speichern, enthält die Datei 6 Bytes. Es sind eindeutig zwei Zeichen, aber der Speicherbedarf ist dreimal so hoch.
Daran zeigt sich: „Zeichenanzahl“ und „Bytezahl“ sind zwei verschiedene Werte. Ein Computer zählt beim Speichern nämlich keine Zeichen, sondern Bytes.
Ein Hangul-Zeichen belegt in UTF-8 in der Regel 3 Bytes. „안“ sind also 3 Bytes, „녕“ ebenfalls 3 Bytes, zusammen 6 Bytes. Wer versteht, woher dieses Dreifache kommt, versteht auch, warum bei der Umwandlung in Binärcode so lange Folgen aus Nullen und Einsen entstehen.
Text ohne Tool in Binärcode umwandeln
Den gesamten Vorgang können Sie auch von Hand durchführen. Er besteht aus drei Schritten.
Schritt 1 – Das Zeichen in Bytes umwandeln. Jedem Zeichen ist eine feste Nummer zugeordnet (Codepoint). Nach den UTF-8-Regeln wird sie auf 1 bis 4 Bytes verteilt. Das lateinische „A“ hat die Nummer 65 und belegt 1 Byte, das Hangul-Zeichen „가“ wird auf 3 Bytes aufgeteilt.
Schritt 2 – Jedes Byte als achtstellige Binärzahl schreiben. Ein Byte hat einen Wert von 0 bis 255. Schreiben Sie diesen Wert binär und füllen Sie vorne mit Nullen auf, falls es keine 8 Stellen sind. „A“ (65) lautet binär 1000001, auf 8 Stellen aufgefüllt ergibt das 01000001.
Schritt 3 – Bei mehreren Bytes aneinanderhängen. „가“ hat die drei Bytewerte 234, 176 und 128. Binär sind das 11101010 · 10110000 · 10000000, aneinandergehängt ergibt das 24 Stellen.
Hexadezimaldarstellung und eigene Kontrolle
Hexadezimal ist noch einfacher: Jedes Byte schreiben Sie als zweistellige Hexadezimalzahl. „A“ ist 41, „가“ ist ea b0 80. Ein Byte mit 8 Binärstellen entspricht hexadezimal genau 2 Stellen.
Zum Nachprüfen können Sie in der Konsole der Entwicklertools Ihres Browsers new TextEncoder().encode('가') ausführen. Das Ergebnis ist [234, 176, 128]. Diese Werte entsprechen ea, b0 und 80. In Python erhalten Sie dasselbe Ergebnis mit '가'.encode('utf-8').
Das Problem: Bei mehr Text müssen Sie diese Rechnung Zeichen für Zeichen wiederholen.
Mit unserem Tool prüfen.
Wandeln Sie Text direkt im Browser ohne Installation und Anmeldung auf UTF-8-Basis in Binär oder Hexadezimal um und stellen Sie Codes wieder als Text her.
Typische Stolperstellen bei der Rückumwandlung
Beim Zurückverwandeln von Binär- oder Hexadezimalcode in Text gelten feste Regeln. Der Konverter zerlegt Binärcode in Blöcke von je 8 Stellen und Hexadezimalcode in Blöcke von je 2 Stellen und liest jeden Block als ein Byte. Trennzeichen (Leerzeichen) sind deshalb erlaubt, aber nicht nötig.
Probleme entstehen, wenn dieses Zerlegen nicht aufgeht. Die typischen Fälle:
| Symptom | Ursache | Prüfung |
|---|---|---|
| Binärcode wird nicht in Text umgewandelt | Die Gesamtzahl der Nullen und Einsen ist kein Vielfaches von 8 | Prüfen, ob die Stellenzahl ein Vielfaches von 8 ist (ein Byte = 8 Stellen) |
| Hexadezimalcode wird nicht umgewandelt | Ungerade Stellenzahl | Prüfen, ob die Stellenzahl gerade ist (ein Byte = 2 Stellen) |
| Auch zusammengeschriebener Code funktioniert | Es wird automatisch in 8-Bit- bzw. 2-Stellen-Blöcke zerlegt | Trennzeichen sind optional |
| Statt eines Zeichens erscheint � | Bytefolge ist kein gültiges UTF-8 | Prüfen, ob der Originalcode abgeschnitten oder durchmischt wurde |
| Hexadezimalcode wird als Binärcode gelesen | Er enthält nur 0 und 1, die automatische Erkennung entscheidet auf Binär | Format manuell auf Hexadezimal setzen |
Die letzten beiden Zeilen etwas genauer: Geben Sie zum Beispiel in das Binärfeld nur 10000000 ein, ist das ein Byte, das allein nicht vorkommen darf. Es lässt sich daher nicht in ein gültiges Zeichen zurückverwandeln und wird als Ersatzzeichen � angezeigt. Das ist ein Hinweis, den Code noch einmal auf Vollständigkeit zu prüfen.
Außerdem erkennt der automatische Modus eine Eingabe als Binärcode, sobald sie nur aus 0 und 1 besteht. Hexadezimalwerte wie „01“ oder „10“ können daher fälschlich als Binärcode gedeutet werden. Setzen Sie in diesem Fall das Format selbst auf Hexadezimal. Übrigens ist es kein Fehler, wenn die Bytezahl größer ist als die Zeichenanzahl: Hangul und Emojis bestehen aus mehreren Bytes, das ist also ein ganz normales Ergebnis.
Zusammenfassung
- Ein Computer wandelt Text in UTF-8-Bytes um und stellt jedes Byte als achtstellige Binärzahl oder zweistellige Hexadezimalzahl dar.
- Lateinische Buchstaben belegen 1 Byte, Hangul 3 Bytes, Emojis 4 Bytes. Ein Zeichen wird daher in mehrere Blöcke zerlegt, und die Bytezahl ist größer als die Zeichenanzahl.
- Bei der Rückumwandlung wird in Blöcke von 8 Binärstellen bzw. 2 Hexadezimalstellen zerlegt, Trennzeichen sind deshalb nicht nötig.
- Ist die Gesamtlänge des Binärcodes kein Vielfaches von 8 oder hat der Hexadezimalcode eine ungerade Stellenzahl, wird nicht umgewandelt und es erscheint eine Hinweismeldung.
- Bytefolgen, die kein gültiges UTF-8 sind, werden als Ersatzzeichen � angezeigt.
Wandeln Sie Text direkt im Browser ohne Installation und Anmeldung auf UTF-8-Basis in Binär oder Hexadezimal um und stellen Sie Codes wieder als Text her.
Häufig gestellte Fragen
Warum hat ein Hangul-Zeichen binär 24 Stellen?
Hangul wird in UTF-8 in der Regel in 3 Bytes gespeichert, und ein Byte besteht aus 8 Binärstellen. 3 Bytes × 8 Stellen = 24 Stellen. Lateinische Buchstaben belegen 1 Byte und damit 8 Stellen, Emojis belegen 4 Bytes und damit 32 Stellen.
Lässt sich Binärcode ohne Trennzeichen (Leerzeichen) zurückverwandeln?
Ja. Binärcode wird automatisch in Blöcke von 8 Stellen zerlegt, Hexadezimalcode in Blöcke von 2 Stellen. Die Gesamtlänge muss allerdings bei Binärcode ein Vielfaches von 8 sein und bei Hexadezimalcode eine gerade Stellenzahl haben. Passt die Stellenzahl nicht, erscheint eine Hinweismeldung.
Nach der Rückumwandlung sehe ich das Zeichen � (Kästchen bzw. Fragezeichen). Woran liegt das?
Die Bytefolge ist dann kein gültiges UTF-8. Mischt sich zum Beispiel ein Byte ein, das nicht allein stehen darf, kann der Konverter das ursprüngliche Zeichen nicht erkennen und zeigt stattdessen das Ersatzzeichen � an. Prüfen Sie, ob der Originalcode mittendrin abgeschnitten oder mit anderen Werten vermischt wurde.
Was ist der Unterschied zwischen Binär und Hexadezimal?
Es sind unterschiedliche Schreibweisen für dieselben Bytes, der Informationsgehalt ist also identisch. Ein Byte wird binär mit 8 Stellen und hexadezimal mit 2 Stellen dargestellt. Hexadezimal ist kompakter zu lesen, Binärcode zeigt dagegen jedes einzelne Bit unverändert.
Dieser Artikel basiert auf unserem koreanischen Original. Koreanisches Original lesen