
Regulären Ausdruck lesen: Bedeutung der Zeichen im Überblick
Inhalt
Reguläre Ausdrücke wirken schon nach wenigen Zeichen unlesbar: Eckige und runde Klammern sowie Fragezeichen überlagern sich, und man weiß nicht, wo man mit dem Lesen anfangen soll. Tatsächlich besteht ein regulärer Ausdruck (kurz: Regex) nur aus vier Arten von Symbolen, die der Reihe nach aneinandergehängt werden: Anker, Zeichenklassen, Gruppen und Quantifizierer. Wer diese Regeln kennt, kann jeden Ausdruck Zeichen für Zeichen von Hand entschlüsseln.
In diesem Artikel erfahren Sie, wie Sie einen regulären Ausdruck in Teile zerlegen und lesen. Außerdem zeigen wir, wie Sie bei langen Mustern ein Tool nutzen, das jedes Symbol automatisch im Klartext erklärt.
Zusammenfassung ① Ein regulärer Ausdruck ist eine Kombination aus vier Symbolarten: Anker (
^$), Zeichenklassen ([...]), Gruppen ((...)) und Quantifizierer (*+{n,m}) ② Literale Zeichen (z. B.@,.) dienen als Orientierungspunkte; die Abschnitte dazwischen lesen Sie gruppenweise ③ Bei langen Mustern geht es schneller, sie in ein Tool einzugeben und eine Erklärung pro Token zu erhalten, statt von Hand abzuzählen
Warum sich Regex so schwer lesen lässt: zu viele Symbole in einer Zeile
Sehen wir uns ein gängiges Muster zur Prüfung des E-Mail-Formats an:
^([a-zA-Z0-9_.-]+)@([a-z0-9_.-]+)\.([a-z]{2,5})$
In dieser einen Zeile stecken 3 Gruppen in runden Klammern, 3 Zeichenklassen in eckigen Klammern, 2 Quantifizierer und 1 maskierter Punkt. Da es keine Leerzeichen gibt, ändert sich die Bedeutung eines Symbols je nach unmittelbarem Umfeld komplett. Beispielsweise steht . außerhalb einer Zeichenklasse für „ein beliebiges Zeichen“, mit vorangestelltem Backslash wie in \. dagegen für „das Punktzeichen selbst“. Sind mehrere solcher Symbole verschachtelt, verliert man beim Mitlesen leicht den Überblick, welche Klammer zu welcher gehört.
Regex selbst lesen: die vier Symbolarten
Begrenzung am Anfang und Ende: Anker. ^ steht für den Anfang, $ für das Ende der Zeichenkette. Stehen beide zusammen, muss die gesamte Zeichenkette exakt zum regulären Ausdruck passen.
Welche Zeichen erlaubt sind: Zeichenklassen. Ein Treffer entsteht mit genau einem der Zeichen in den eckigen Klammern. [a-z] steht für einen Kleinbuchstaben des Alphabets. Steht ^ ganz am Anfang ([^0-9]), bedeutet das die Negation, also „alle außer diesen“. Häufig genutzte Klassen wie \d (Ziffer), \w (Wortzeichen: Buchstaben, Ziffern und Unterstrich) und \s (Leerraum) werden mit einem Backslash abgekürzt.
Zusammenfassen: Gruppen. Der Teil in runden Klammern wird als eine Einheit behandelt, und der Treffer wird nummeriert gespeichert (Capturing). Wenn Sie nichts speichern müssen, schreiben Sie (?:...) und verzichten so auf die Erfassung. (?=...), (?!...), (?<=...) und (?<!...) sind Lookahead und Lookbehind: Sie prüfen nur eine Bedingung vor oder nach der aktuellen Stelle, ohne Zeichen zu verbrauchen.
Wie oft wiederholt wird: Quantifizierer. Sie legen fest, wie oft das unmittelbar davor stehende Symbol oder die Gruppe vorkommen muss. * bedeutet 0-mal oder öfter, + 1-mal oder öfter, ? 0- oder 1-mal. Mit geschweiften Klammern wie {2,5} geben Sie die minimale und maximale Anzahl direkt an. Standardmäßig wird so viel wie möglich getroffen (gierig, „Greedy“). Hängen Sie ein ? an (*?, +?), wird nur so wenig wie möglich getroffen (genügsam, „Lazy“).
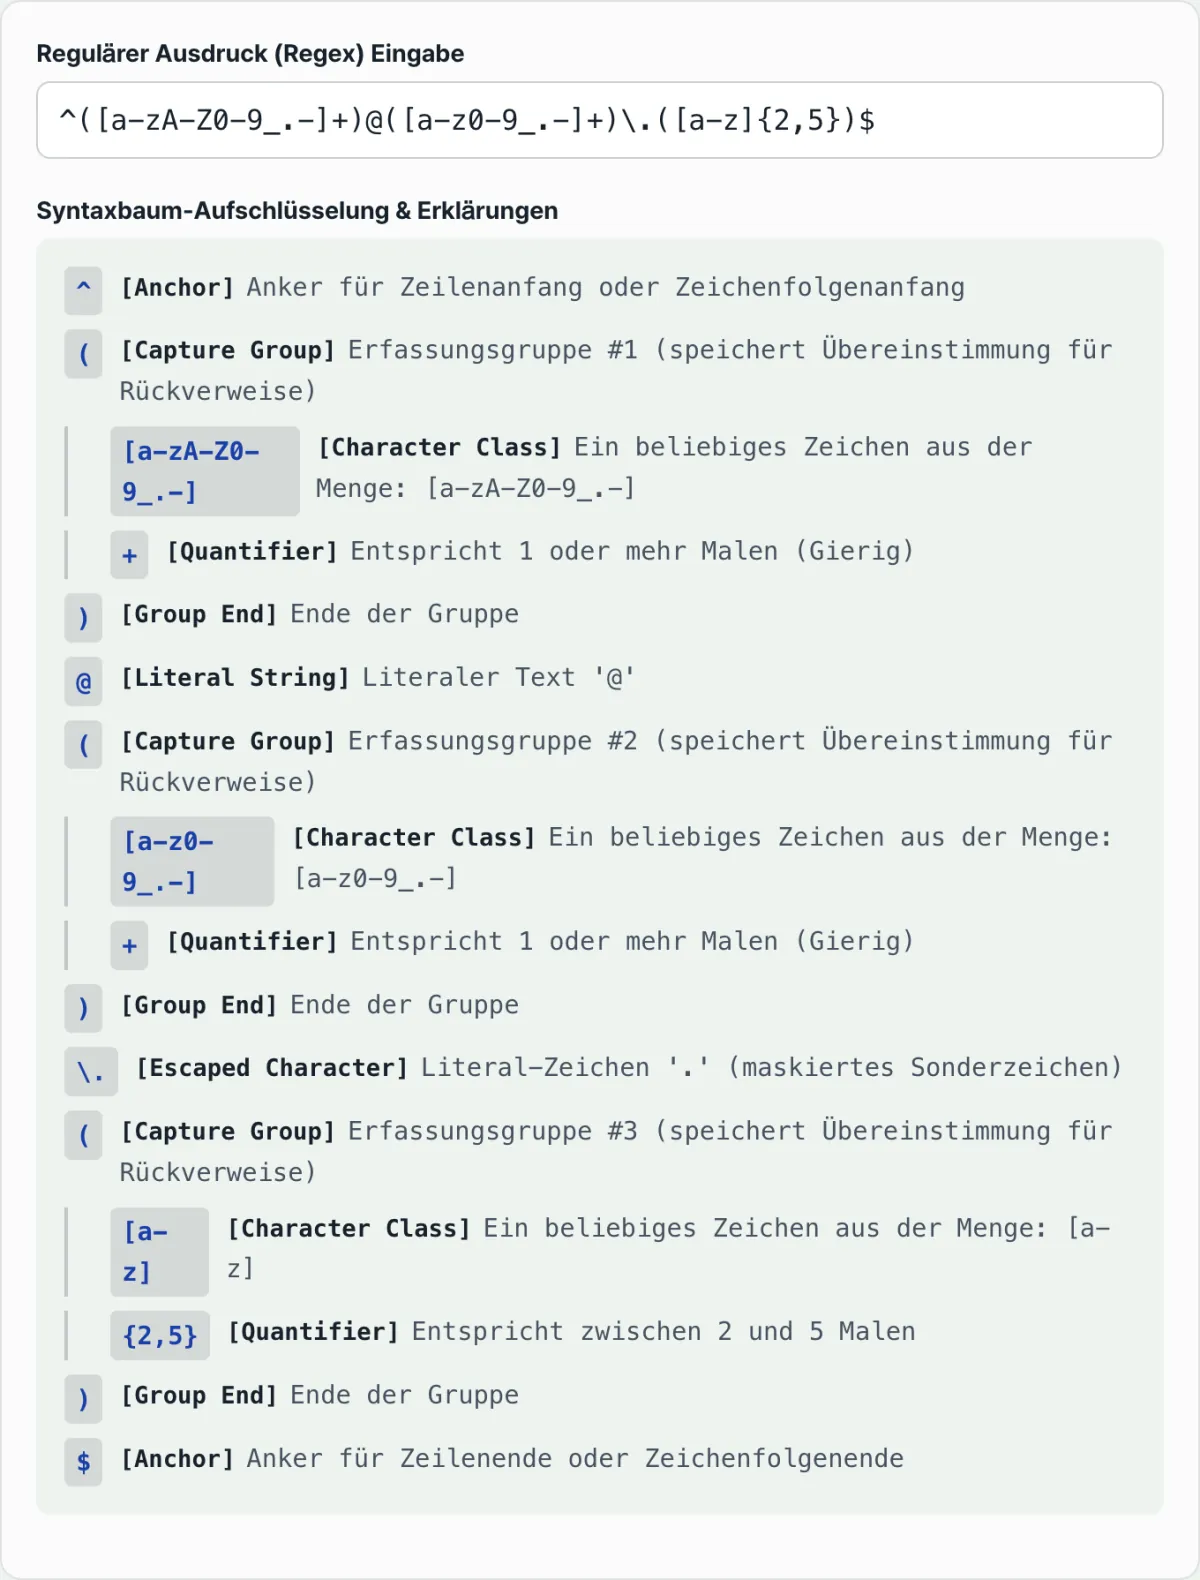
Wenden Sie diese Regeln auf das E-Mail-Muster oben an, löst es sich Schritt für Schritt so auf: ^ (Anker am Anfang) → ( (Beginn der Capturing-Gruppe Nr. 1) → [a-zA-Z0-9_.-] (Zeichenklasse) → + (1-mal oder öfter, gierig) → ) (Ende der Gruppe) → @ (literales Zeichen) → ( (Capturing-Gruppe Nr. 2) → [a-z0-9_.-] → + → ) → \. (maskierter, literaler Punkt) → ( (Capturing-Gruppe Nr. 3) → [a-z] → {2,5} (2- bis 5-mal) → ) → $ (Anker am Ende).
Mit unserem Tool prüfen. Wenn Ihnen das Abzählen von Hand zu mühsam ist: Sobald Sie das Muster in den Regex-Visualisierer eingeben, erscheinen dieselben Schritte in derselben Reihenfolge, eingerückt und mit einer Erklärung im Klartext.
Geben Sie einen regulären Ausdruck ein: Er wird in Gruppen, Zeichenklassen, Quantifizierer und Anker zerlegt, und die Bedeutung jedes Zeichens wird im Klartext erklärt.
Häufig verwechselte Schreibweisen
| Schreibweise | Tatsächliche Bedeutung |
|---|---|
(...) vs. (?:...) | (...) speichert den Treffer nummeriert (Capturing), (?:...) fasst nur zusammen und speichert nicht |
(?=...) vs. (?<=...) | (?=...) prüft die Bedingung für das, was folgt (Lookahead), (?<=...) prüft die Bedingung für das, was davor steht (Lookbehind) |
* vs. *? | * trifft so viel wie möglich (Greedy), *? so wenig wie möglich (Lazy) |
\d \w \s | Abkürzungen für Ziffer, Wortzeichen (Buchstaben, Ziffern und Unterstrich) bzw. Leerzeichen |
Fazit
Ein regulärer Ausdruck ist eine Kombination aus vier Symbolarten: Anker, Zeichenklassen, Gruppen und Quantifizierer. Nutzen Sie literale Zeichen wie @ oder . als Orientierungspunkte und unterteilen Sie die Abschnitte dazwischen gruppenweise, dann lässt sich ein Ausdruck auch von Hand lesen. Wird das Muster länger oder kommen Lookahead und Lookbehind hinzu, geht es schneller, es in ein Tool einzugeben und eine Erklärung pro Token zu erhalten. Der Regex-Visualisierer ist darauf spezialisiert, die Struktur eines regulären Ausdrucks zu erklären; eine Funktion, um zu testen, ob echte Zeichenketten passen, bietet er nicht.
Geben Sie einen regulären Ausdruck ein: Er wird in Gruppen, Zeichenklassen, Quantifizierer und Anker zerlegt, und die Bedeutung jedes Zeichens wird im Klartext erklärt.
Häufig gestellte Fragen
Kann ich mit dem Tool auch testen, ob eine Zeichenkette zum Regex passt?
Nein. Das Tool ist darauf spezialisiert, die Struktur des regulären Ausdrucks selbst Token für Token zu zerlegen und zu erklären. Eine separate Funktion, um Teststrings abzugleichen, gibt es nicht.
Erkennt das Tool auch fortgeschrittene Syntax wie Lookahead und Lookbehind?
Ja. Nicht erfassende Gruppen mit (?:...), positiver Lookahead mit (?=...), negativer Lookahead mit (?!...) sowie Lookbehind mit (?<=...) und (?<!...) werden jeweils unterschieden und erklärt.
Wird der eingegebene reguläre Ausdruck an einen Server gesendet?
Nein. Das Parsen und das Erzeugen der Erklärung laufen ausschließlich im Browser ab. Deshalb können Sie auch sensible Muster unbedenklich prüfen.
Dieser Artikel basiert auf unserem koreanischen Original. Koreanisches Original lesen