
正規表現の記号の意味を分解して読み解く方法
正規表現が数文字を超えたあたりから、角括弧や丸括弧、クエスチョンマークが重なって、どこから読めばいいのか分からなくなります。しかし実際には、正規表現もアンカー・文字クラス・グループ・量指定子という4種類の記号を順番につなげたものにすぎず、ルールさえ分かれば1文字ずつ手で解いて読むことができます。
この記事では、正規表現を部分ごとに分けて読む方法と、パターンが長くなったときに記号をひとつずつ日本語の解説に自動で分解してくれるツールの使い方をあわせて紹介します。
まとめ ① 正規表現はアンカー(
^$)・文字クラス([...])・グループ((...))・量指定子(*+{n,m})の4種類の記号の組み合わせです ② リテラル文字(@、.など)を道しるべにして、その間をグループ単位で区切って読めばOKです ③ パターンが長くなったら、手で数える代わりにツールに入れてトークンごとの日本語解説を受け取るほうが早いです
正規表現が読めない理由: 記号が1行に詰め込まれているから
メールアドレスの形式をチェックする、よくあるパターンをひとつ見てみましょう。
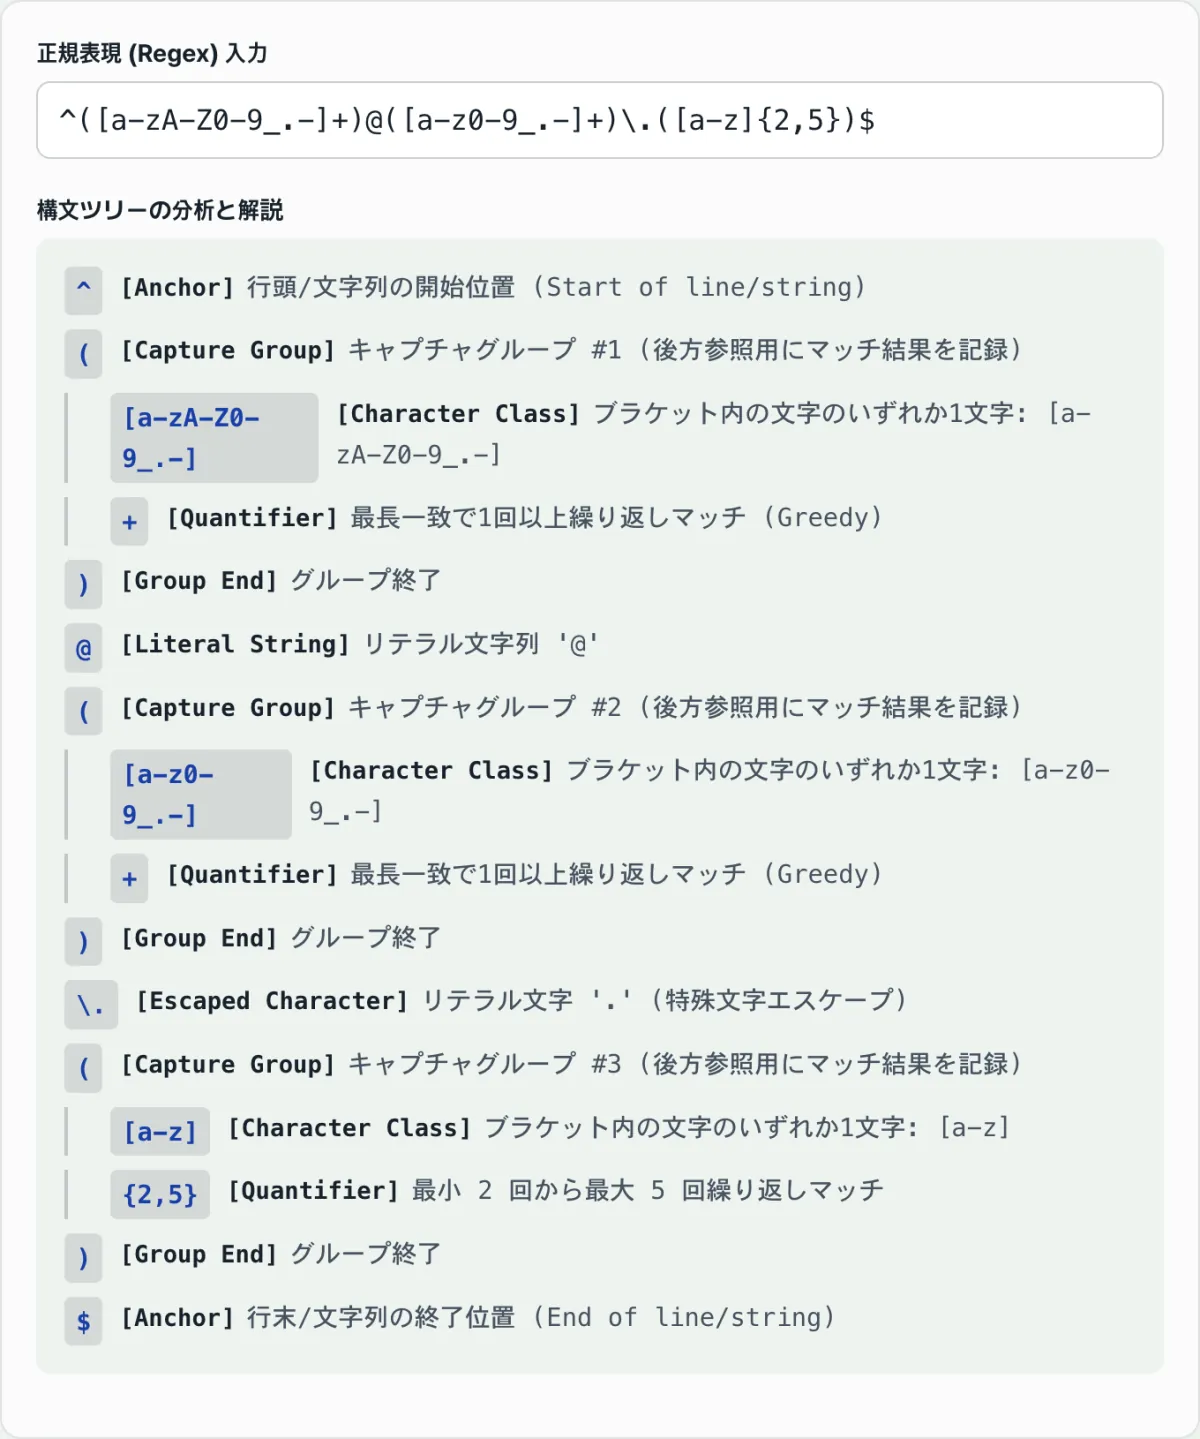
^([a-zA-Z0-9_.-]+)@([a-z0-9_.-]+)\.([a-z]{2,5})$
この1行の中には、丸括弧のグループが3つ、角括弧の文字クラスが3つ、量指定子が2つ、エスケープされたピリオドが1つ入っています。空白がないぶん、記号ひとつが前後の文脈によって意味をがらりと変えます。たとえば . はグループの外では「任意の1文字」を意味しますが、\. のようにバックスラッシュが付くと「ピリオドという文字そのもの」に変わります。こうした記号がいくつも入れ子になると、目で追っているうちにどの括弧とどの括弧が対になっているのか見失いがちです。
正規表現を自分で読む方法: 4種類の記号に分けてみる
前後の境界、アンカー。 ^ は文字列の先頭、$ は末尾を指します。この2つが揃っていると、文字列全体が正規表現と完全に一致しなければマッチしません。
どの文字を許可するか、文字クラス。 角括弧の中に入れた文字のうち、どれか1つとマッチします。[a-z] は小文字アルファベット1文字、先頭に ^ が来ると([^0-9])その逆で「除外」を意味します。\d(数字)、\w(単語文字:英数字+アンダースコア)、\s(空白)のようによく使うクラスは、バックスラッシュで短く書けます。
まとめて扱う、グループ。 丸括弧で囲んだ部分はひとつの単位として扱われ、マッチした値に番号が振られて保存されます(キャプチャ)。保存が不要なら (?:...) と書いてキャプチャを省略でき、(?=...)・(?!...)・(?<=...)・(?<!...) は文字を消費せずに前後の条件だけを確認する先読み・後読みです。
何回繰り返すか、量指定子。 すぐ前の記号やグループが何回現れるべきかを決めます。* は0回以上、+ は1回以上、? は0回または1回、{2,5} のように波括弧を使えば最小・最大の回数を直接指定します。基本はできるだけ多くマッチする欲張り(Greedy)方式で、後ろに ? を付けると(*?、+?)最小限だけマッチする最短(Lazy)方式に変わります。
このルールを上のメールパターンにそのまま当てはめてみると、^(開始アンカー)→ ((キャプチャグループ #1 開始)→ [a-zA-Z0-9_.-](文字クラス)→ +(1回以上、欲張り)→ )(グループ終了)→ @(リテラル文字)→ ((キャプチャグループ #2)→ [a-z0-9_.-] → + → ) → \.(エスケープされたリテラルのピリオド)→ ((キャプチャグループ #3)→ [a-z] → {2,5}(2〜5回)→ ) → $(終了アンカー)の順に、ひとつずつ解けていきます。
無料ツールで確認する。 この順番を手で数えるのが面倒なら、ツールにパターンを入れるだけで、同じ順序のままインデント付きで日本語の解説が並びます。
正規表現を入力すると、キャプチャグループ・文字クラス・量指定子・アンカー単位に分解し、各記号の意味を日本語で説明します。
よく混同される表記
| 表記 | 実際の意味 |
|---|---|
(...) vs (?:...) | (...) はマッチ結果を番号で保存(キャプチャ)、(?:...) はまとめるだけで保存しない |
(?=...) vs (?<=...) | (?=...) は後ろに続く条件を確認(先読み)、(?<=...) は前に置かれた条件を確認(後読み) |
* vs *? | * はできるだけ多くマッチ(Greedy)、*? は最小限だけマッチ(Lazy) |
\d \w \s | それぞれ数字、単語文字(英数字+アンダースコア)、空白文字の省略表記 |
まとめ
正規表現は、アンカー・文字クラス・グループ・量指定子という4種類の記号の組み合わせです。@ や . のようなリテラル文字を道しるべにして、その間をグループ単位で区切れば、手でも読み解けます。パターンが長くなったり、先読み・後読みまで混ざってきたりしたら、ツールに入れてトークンごとの日本語解説を受け取るほうが早いです。このツールは正規表現の構造を説明することに特化しており、実際の文字列がマッチするかをテストする機能は提供していません。
正規表現を入力すると、キャプチャグループ・文字クラス・量指定子・アンカー単位に分解し、各記号の意味を日本語で説明します。
よくある質問
このツールで、実際の文字列がマッチするかどうかもテストできますか?
いいえ。正規表現そのものの構造をトークン単位に分けて説明することに特化しており、テスト用の文字列をマッチさせる機能は提供していません。
先読み・後読みのような高度な文法も認識しますか?
はい。(?:...) の非キャプチャグループ、(?=...) の肯定的先読み、(?!...) の否定的先読み、(?<=...)・(?<!...) の後読みまで、それぞれ区別して説明します。
入力した正規表現はサーバーに送信されますか?
送信されません。パースと解説の生成ロジックはすべてブラウザの中だけで実行されるので、機密性の高いパターンでもそのまま確認できます。
この記事は韓国語の原文をもとに作成しています。 韓国語の原文を読む