
Expresiones regulares: qué significa cada símbolo y cómo leerlos
Contenido
En cuanto una expresión regular pasa de unos pocos caracteres, entre corchetes, paréntesis y signos de interrogación, no sabes por dónde empezar a leerla. En realidad, una expresión regular es solo una concatenación, en orden, de cuatro tipos de símbolos: anclas, clases de caracteres, grupos y cuantificadores. Si conoces las reglas, puedes descomponerla y leerla a mano, carácter a carácter.
En este artículo veremos cómo dividir una expresión regular en partes para leerla y también cómo usar una herramienta que, cuando el patrón se alarga, descompone automáticamente cada símbolo en una explicación en español.
Resumen ① Una expresión regular es una combinación de cuatro tipos de símbolos: anclas (
^$), clases de caracteres ([...]), grupos ((...)) y cuantificadores (*+{n,m}). ② Toma caracteres literales (@,., etc.) como puntos de referencia y divide en grupos lo que hay entre ellos y léela. ③ Cuando el patrón se alarga, es más rápido introducirlo en la herramienta y obtener una explicación en español de cada token que contar el orden a mano.
Por qué cuesta leer una expresión regular: los símbolos se amontonan en una sola línea
Veamos un patrón habitual para validar un formato de correo electrónico.
^([a-zA-Z0-9_.-]+)@([a-z0-9_.-]+)\.([a-z]{2,5})$
En esta única línea hay 3 grupos entre paréntesis, 3 clases de caracteres entre corchetes, 2 cuantificadores y 1 punto escapado. Como no hay espacios, el significado de un símbolo cambia por completo según el contexto inmediato. Por ejemplo, . fuera de un grupo significa “cualquier carácter”, pero si lleva una barra invertida delante, como en \., pasa a significar “el carácter de punto en sí”. Cuando estos símbolos se anidan en varias capas, es fácil perder de vista qué paréntesis se corresponde con cuál al seguirlos con la vista.
Cómo leer una expresión regular por tu cuenta: divídela en cuatro tipos de símbolos
Los límites del principio y del final: las anclas. ^ señala el inicio de la cadena y $, el final. Si aparecen juntos, toda la cadena debe coincidir exactamente con la expresión regular para que se acepte.
Qué caracteres se permiten: las clases de caracteres. Coinciden con uno de los caracteres incluidos entre corchetes. [a-z] es una letra minúscula; si ^ aparece al principio ([^0-9]), significa lo contrario, es decir, “excluir”. Las clases de uso frecuente como \d (dígito), \w (carácter de palabra: alfanumérico + guion bajo) y \s (espacio en blanco) se escriben de forma abreviada con una barra invertida.
Agrupar para tratarlo como una unidad: los grupos. Lo que se encierra entre paréntesis se trata como una unidad y el valor coincidente se guarda numerado (captura). Si no necesitas guardarlo, puedes usar (?:...) para omitir la captura; (?=...), (?!...), (?<=...) y (?<!...) son búsquedas hacia delante y hacia atrás que comprueban condiciones sin consumir caracteres.
Cuántas veces se repite: los cuantificadores. Indican cuántas veces debe aparecer el símbolo o grupo que tienen justo delante. * significa cero o más veces; +, una o más; ?, cero o una; y con llaves como {2,5} indicas directamente el mínimo y el máximo. Por defecto, el comportamiento es codicioso (Greedy): coincide con la mayor cantidad posible. Si añades un ? después (*?, +?), pasa a ser perezoso (Lazy) y coincide con la menor cantidad posible.
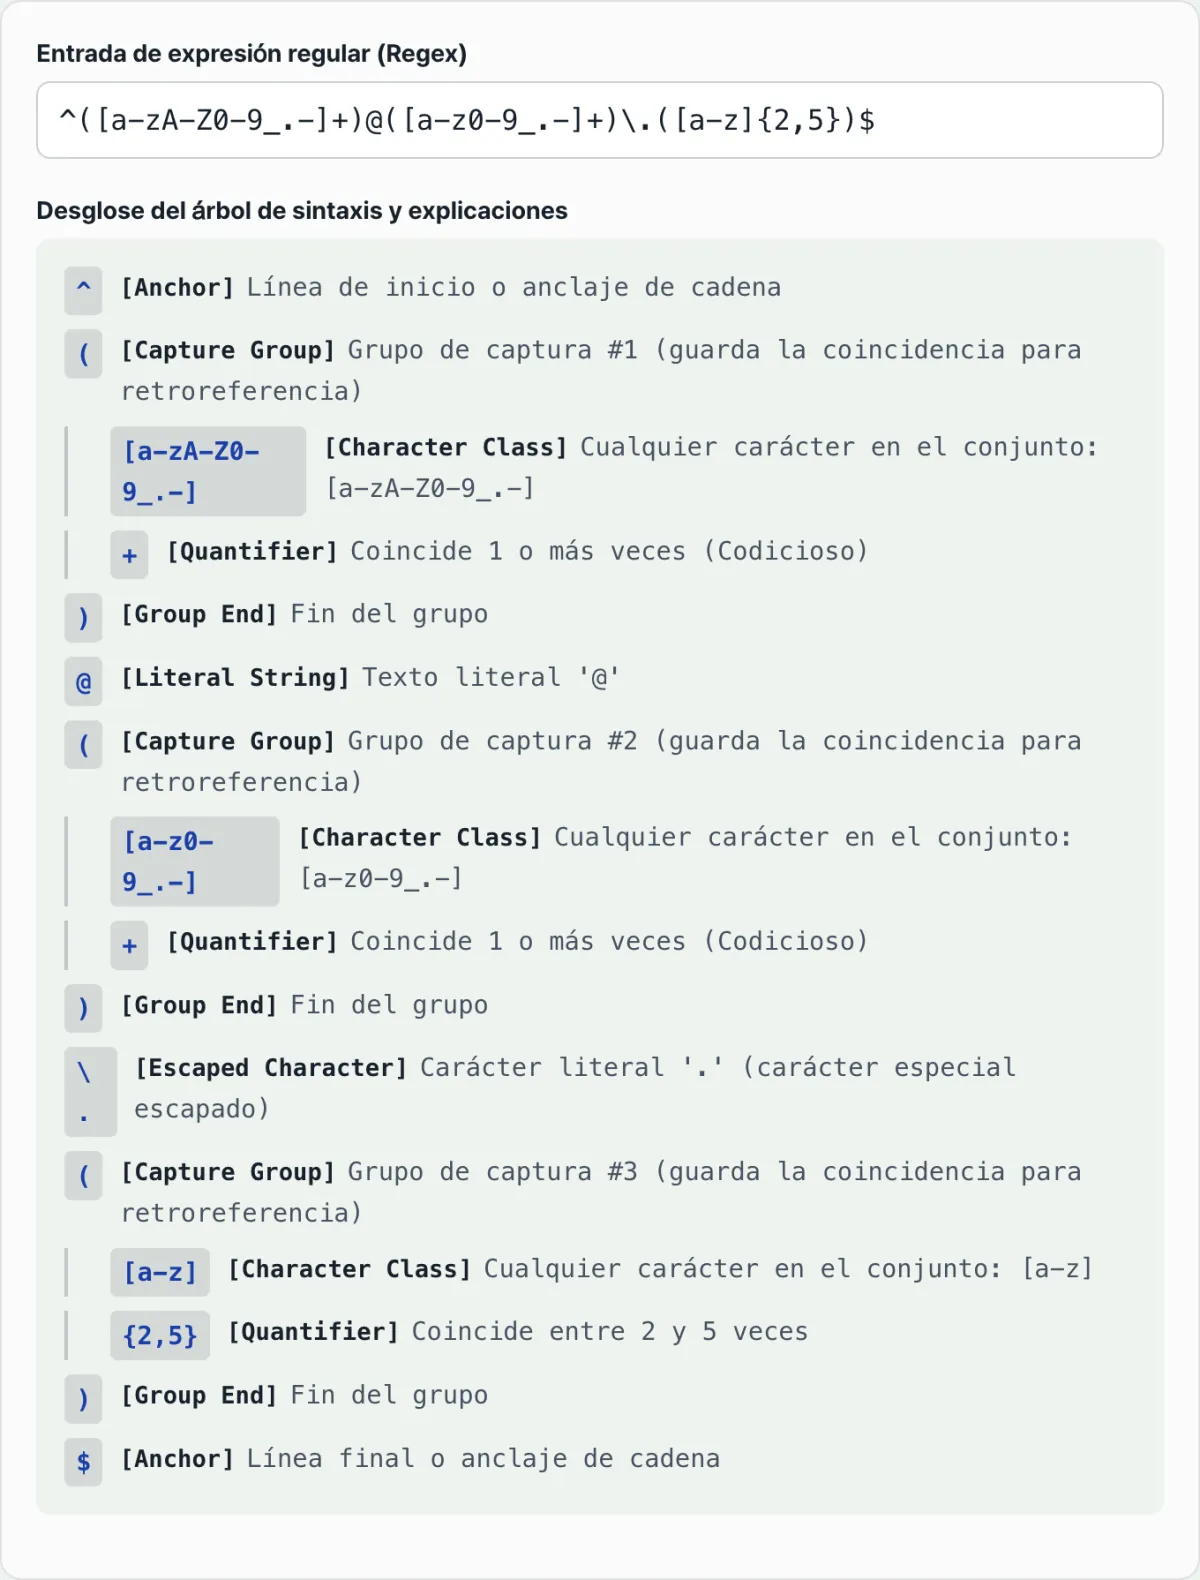
Si aplicamos estas reglas al patrón de correo anterior, se descompone paso a paso en este orden: ^ (ancla de inicio) → ( (inicio del grupo de captura 1) → [a-zA-Z0-9_.-] (clase de caracteres) → + (una o más veces, codicioso) → ) (fin del grupo) → @ (carácter literal) → ( (grupo de captura 2) → [a-z0-9_.-] → + → ) → \. (punto literal escapado) → ( (grupo de captura 3) → [a-z] → {2,5} (de 2 a 5 veces) → ) → $ (ancla de fin).
Compruébalo con el Visualizador de expresiones regulares. Si contar este orden a mano te resulta engorroso, en cuanto introduces el patrón en la herramienta aparecen las explicaciones en español, con sangría y en ese mismo orden.
Escribe tu expresión regular y la dividimos en grupos de captura, clases de caracteres, cuantificadores y anclas, explicándote en español qué significa cada símbolo.
Notaciones que se confunden a menudo
| Notación | Qué significa en realidad |
|---|---|
(...) vs (?:...) | (...) guarda el resultado coincidente con un número (captura); (?:...) solo agrupa y no lo guarda |
(?=...) vs (?<=...) | (?=...) comprueba una condición que viene después (búsqueda hacia delante); (?<=...) comprueba una condición que viene antes (búsqueda hacia atrás) |
* vs *? | * coincide con la mayor cantidad posible (Greedy); *? coincide con la mínima (Lazy) |
\d \w \s | Abreviaturas de dígito, carácter de palabra (alfanumérico + guion bajo) y espacio en blanco, respectivamente |
Conclusión
Una expresión regular es una combinación de cuatro tipos de símbolos: anclas, clases de caracteres, grupos y cuantificadores. Si usas caracteres literales como @ o . como puntos de referencia y divides en grupos lo que hay entre ellos, también puedes leerla a mano. Cuando el patrón se alarga o se mezcla con búsquedas hacia delante y hacia atrás, es más rápido introducirlo en la herramienta y recibir una explicación en español de cada token. Esta herramienta está especializada en explicar la estructura de las expresiones regulares y no ofrece una función para probar si una cadena real coincide.
Escribe tu expresión regular y la dividimos en grupos de captura, clases de caracteres, cuantificadores y anclas, explicándote en español qué significa cada símbolo.
Preguntas frecuentes
¿Puedo usar esta herramienta para probar si una cadena real coincide?
No. Está especializada en dividir y explicar la estructura de la propia expresión regular token a token, y no incluye una función aparte para probar coincidencias con una cadena de texto.
¿También reconoce sintaxis avanzada como las búsquedas hacia delante y hacia atrás?
Sí. Distingue y explica por separado los grupos sin captura (?:...), la búsqueda hacia delante positiva (?=...), la búsqueda hacia delante negativa (?!...) y las búsquedas hacia atrás (?<=...) y (?<!...).
¿Se envía al servidor la expresión regular que introduzco?
No. Tanto el análisis como la generación de las explicaciones se ejecutan solo en el navegador, así que puedes comprobar tal cual incluso patrones sensibles.
Este artículo está adaptado de nuestro original en coreano. Leer el original en coreano