
Cómo leer un hex dump: offset, hexadecimal y ASCII
Contenido
Los números hexadecimales que se suceden en una pantalla de volcado hexadecimal y la cadena de puntos (.) de la derecha se pueden leer tal cual si entiendes las tres columnas fijas: offset, hexadecimal y ASCII.
Cuando ejecutas xxd o hexdump -C en la terminal, o cuando otro programa genera una salida con los bytes originales en este formato, el principio es el mismo. Este artículo explica, en orden, cómo se construye esa estructura y cómo leer cada columna.
Resumen ① El offset de la izquierda es la posición del byte donde empieza esa línea; cambiar entre hexadecimal y decimal solo muestra esa misma posición con otro número. ② La zona central contiene los valores de los bytes escritos como dos dígitos hexadecimales (00–FF), ordenados de 8 en 8 o de 16 en 16 por línea. ③ Cada punto (.) de la zona |...| de la derecha es un símbolo que sustituye de forma segura los bytes que no se pueden representar como caracteres en pantalla.
Cuándo te encuentras con un volcado hexadecimal
Si abres un archivo en un editor de texto y ves caracteres corruptos, puede que eches un vistazo a los primeros bytes con un visor hexadecimal para comprobar si la causa es la codificación del archivo.
También puede pasarte que la extensión no sea suficiente para saber qué contiene realmente un archivo y tengas que revisar los primeros bytes a simple vista para decidirlo.
La pantalla de volcado hexadecimal que aparece en esos casos no suele mostrar más que números, sin ninguna explicación: a la izquierda, un número de 8 dígitos; en el centro, valores hexadecimales divididos en dos bloques; a la derecha, una cadena llena de puntos, todo seguido en la misma línea.
El problema es que este formato de representación se repite una y otra vez en programación, análisis de redes, comprobación de formatos de archivo y otros contextos. Una vez entiendes la estructura, puedes leer con el mismo criterio cualquier volcado hexadecimal, sin importar qué programa lo haya generado; si no la entiendes, te bloqueas cada vez que aparece la misma pantalla.
Cómo crear y leer un volcado hexadecimal sin herramientas
Un volcado hexadecimal no es algo que solo se pueda ver con un programa especial.
En la terminal de macOS y Linux, los comandos xxd nombre-de-archivo y hexdump -C nombre-de-archivo vienen incluidos de serie, y en Windows PowerShell existe Format-Hex nombre-de-archivo. La estructura de la pantalla que generan estos comandos es fundamentalmente la misma.
El orden en que se construye la estructura es el siguiente.
- Divide los datos originales en bytes. Si son texto, convierte cada carácter en 1 a 4 bytes según las reglas de codificación UTF-8; si es un archivo, usa los bytes tal como están guardados.
- Decide cuántos bytes mostrar por línea. Normalmente son 8 o 16.
- Calcula la posición inicial de cada línea (el offset). El offset es «número de línea × bytes por línea».
- Escribe cada valor de byte como dos dígitos hexadecimales (00–FF) y colócalos en fila.
- Si el valor del byte está en el rango 32–126 (ASCII imprimible), escribe el carácter correspondiente a la derecha; si no, escribe un punto (.).
Offsets y valores de byte vistos en un ejemplo
Por ejemplo, si haces un volcado hexadecimal de la cadena ABCDEFGHIJKLMNOPQRST, formada por 20 letras, con 16 bytes por línea, el resultado es este.
00000000  41 42 43 44 45 46 47 48  49 4A 4B 4C 4D 4E 4F 50  |ABCDEFGHIJKLMNOP|
00000010  51 52 53 54                                       |QRST|
La primera línea contiene 16 bytes, del byte 0 (A) al byte 15 (P), y la segunda empieza en el byte 16 (Q).
Esa posición 16 se escribe 00000010 en hexadecimal y 00000016 en decimal. La posición señalada es exactamente la misma; solo cambia el aspecto del número según la base que uses.
Cuándo aparecen los puntos (.)
Cuando se mezclan caracteres de control o caracteres que se codifican con varios bytes, aparecen puntos en la zona de la derecha. Por ejemplo, si el texto incluye un salto de línea (0x0A), no se puede trasladar tal cual como carácter en pantalla y se sustituye por un punto.
Una letra coreana suele codificarse con 3 bytes en UTF-8, y esos tres valores superan 127, así que quedan fuera del rango ASCII imprimible (32–126).
Por eso, en la zona hexadecimal central aparecen con exactitud los valores de los bytes, pero en la zona ASCII de la derecha aparecen tres puntos seguidos en lugar del carácter.
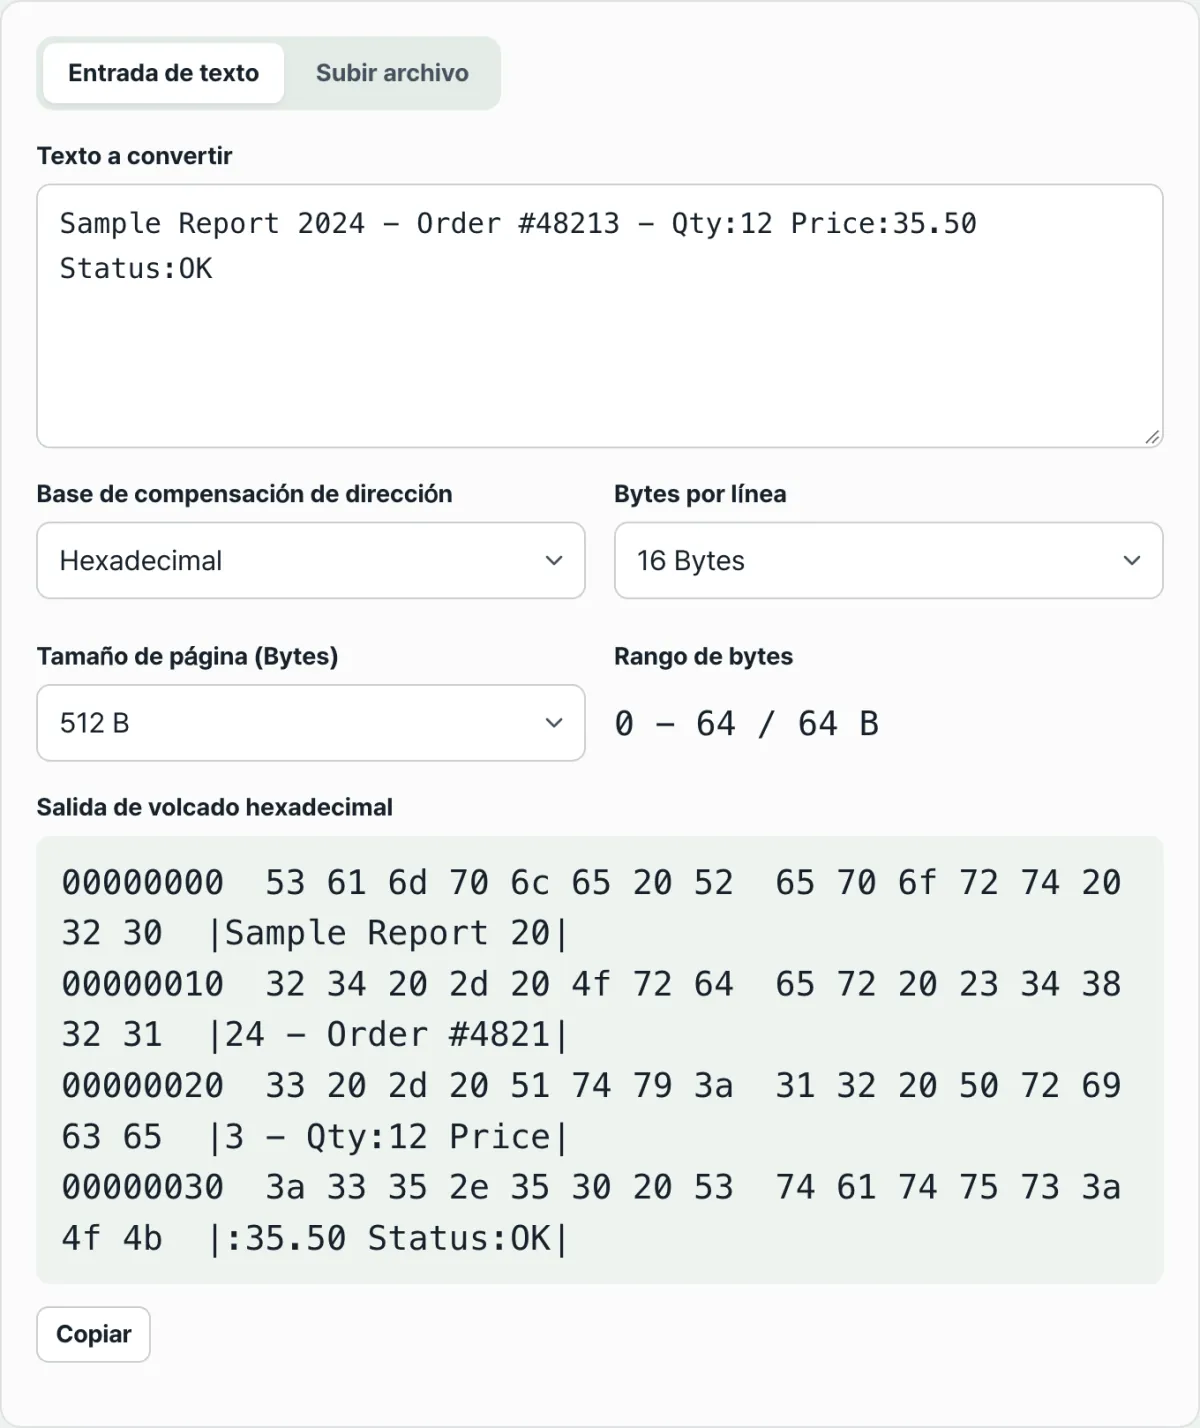
Si no quieres hacer este cálculo a mano y prefieres ver directamente en qué volcado hexadecimal se convierte el texto o el archivo que introduzcas, compruébalo con nuestro Visor de volcado hexadecimal (hex dump), que es gratuito.
Escribe un texto o sube un archivo y verás el resultado del volcado hexadecimal al instante, sin instalar nada ni registrarte.
Aspectos que suelen generar confusión
| Aspecto que suele confundir | Qué significa en realidad |
|---|---|
| El offset parece cambiar al pasar de hexadecimal a decimal | Es la misma posición escrita con números de otra base; los datos a los que apunta son los mismos |
| Hay muchos puntos (.) en la zona ASCII | Es solo una marca que sustituye los caracteres de control 0x00–0x1F y los bytes no imprimibles de 127 en adelante para que se lean con facilidad; no indica que los datos estén dañados |
| Hay más bytes que caracteres introducidos | Porque caracteres como las letras coreanas se codifican con varios bytes en UTF-8 |
| Al cambiar los bytes por línea (8/16), cambia el número de líneas | Solo cambia cuántos bytes caben en cada línea; el conjunto de los datos es el mismo |
| El archivo es grande, pero solo se ve una parte | Es solo paginación: se muestra por bloques del tamaño de página (256B–4KB) y el resto de tramos también existe |
El último punto, la paginación, es especialmente fácil de malinterpretar. Como mostrar de una vez un archivo grande completo en el navegador lo vuelve lento, la herramienta solo muestra el tamaño de página seleccionado y deja el resto para las páginas siguientes.
Eso significa que lo que ves en pantalla no es todo el conjunto de datos, sino el tramo que tienes delante en ese momento.
En resumen
- Un volcado hexadecimal es una forma de representación que convierte texto (codificado en UTF-8) o un archivo (sus bytes originales) en una matriz de bytes y luego los muestra en grupos de 8 o 16 por línea.
- El offset de la izquierda es la posición del byte donde empieza la línea; las notaciones hexadecimal y decimal solo muestran esa misma posición con números distintos.
- La zona central contiene los valores de los bytes escritos como dos dígitos hexadecimales, y la zona |...| de la derecha muestra como caracteres solo los bytes del rango 32–126; el resto aparece como punto (.).
- Que haya muchos puntos (.) no significa que los datos estén dañados: solo se están representando de forma segura valores que no se pueden trasladar como caracteres en pantalla.
- Los datos grandes se muestran por páginas, así que lo que ves en pantalla no es todo el conjunto de datos.
Escribe un texto o sube un archivo y verás el resultado del volcado hexadecimal al instante, sin instalar nada ni registrarte.
Preguntas frecuentes
¿Por qué aparecen más bytes que caracteres si solo escribí texto?
Los caracteres ASCII, como las letras inglesas y los números, se codifican con 1 byte en UTF-8, pero los caracteres de rangos Unicode amplios, como las letras coreanas o los emojis, suelen codificarse con 3 o 4 bytes.
Por eso, aunque escribas una sola letra coreana, en el volcado hexadecimal aparecen varios valores de byte y, en la zona ASCII, se muestran tantos puntos (.) como bytes ocupa ese carácter.
¿Por qué el número del offset cambia si lo veo en hexadecimal o en decimal?
El offset indica, con un número de 8 dígitos, la posición absoluta del byte donde empieza la línea. Aunque sea la misma posición, en hexadecimal se ve, por ejemplo, 00000010, y en decimal, 00000016.
La posición a la que apunta es la misma; lo único que cambia es la base numérica en la que se escribe.
Si hay muchos puntos (.) en la zona ASCII, ¿el archivo está dañado?
No. Los puntos son una representación que sustituye de forma segura los bytes que no se pueden escribir como caracteres en pantalla, es decir, los caracteres de control del rango 0x00–0x1F y los bytes no imprimibles de 127 en adelante.
El valor real de esos bytes aparece con exactitud en la zona hexadecimal central, así que no puedes determinar si un archivo está dañado solo por la cantidad de puntos.
¿Es más estándar usar 8 o 16 bytes por línea?
Ambos se usan mucho en la práctica y no hay un único estándar definido. El comando hexdump -C de macOS y Linux muestra 16 bytes por línea de forma predeterminada, y algunos depuradores o herramientas usan bloques de 8 bytes.
Si cambias los bytes por línea, los datos no cambian; solo cambia dónde se separan las líneas.
Este artículo está adaptado de nuestro original en coreano. Leer el original en coreano